1.1 汇编是什么:一条指令的解码现场
1.1 汇编是什么:一条指令的解码现场
本节摘要:汇编语言是机器码的"人类可读转写层",两者不是两门语言,而是同一件事的两种视角。本节从一段真实程序的十六进制转储出发,手工走一遍"字节 → 指令"的解码过程,拆开一条 x86-64 指令的前缀、操作码与操作数三层结构,并用工具链把互译过程自动化。读完你能解释 MOV 为什么对应几十个操作码,也能独立完成字节流与汇编的来回对照。
深夜两点,你接手一个别人留下的崩溃现场。调试器停在非法地址上,屏幕左边是一列十六进制字节:55 48 89 E5 B8 2A 00 00 00 5D C3。同事只留下一句话:"这附近有问题。"如果你只学过高级语言,这串东西和乱码没有区别;但如果知道它其实是五个指令、知道每个字节怎么读,这串乱码会自己开口说话。本节就练这个本事——它也是整本册子"反汇编对照实验"的第一次动手。
先看一场解码现场
x86-64 的指令是变长的,解码的第一步是找到指令边界。55 恰好是一个完整指令:push rbp,把调用者的栈帧基址压栈——这是几乎所有函数的开场白。接着 48 89 E5 是一条三字节指令 mov rbp, rsp,把栈顶指针搬进基址寄存器,正式"圈地"建立新栈帧。然后 B8 2A 00 00 00 是五字节的 mov eax, 42,注意 2A 00 00 00 这四个字节要按小端序拼成 0x0000002A,也就是十进制 42。最后 5D 弹出 rbp、C3 返回,函数收工。
十一个字节,一个把返回值设为 42 的迷你函数。注意两个此前容易忽略的事实:第一,B8 这类操作码后面跟的操作数在字节流里是"倒着放"的(低位字节在前),这是 x86 家族的小端序传统;第二,指令长短不一——一字节、三字节、五字节混在一起,CPU 取指时必须边读边判断边界。这两点是后面所有反汇编阅读的地基,第 4 章排错时会再吃到它们的甜头。
把一条指令拆成三层
上面我们靠"感觉"在解读,现在把感觉升级成规则。一条 x86-64 指令从左到右由四段组成:可选的Legacy前缀、可选的REX前缀、操作码、操作数字段(ModR/M、SIB、位移、立即数,按需出现)。拿刚才出现过的 48 89 D8 做完整解剖,它对应 mov rax, rbx:
48 89 D8 │ │ │ REX前缀 操作码 ModR/M字节 REX.W=1 MOV r/m, r 11 011 000 表示64位 寄存器送内存 mod=11 reg=011 rm=000 操作数 或寄存器互送 mod=11直接寄存器 reg=011→rbx 源 rm=000→rax 目的
ModR/M 字节一个顶三个字段:最高两位 mod 决定操作数是寄存器还是内存,中间三位 reg 与最低三位 rm 各指向一个寄存器编号。011 按寄存器表查到 rbx,000 查到 rax,于是这条指令读作"把 rbx 送进 rax"。REX 前缀的 W 位把操作数从 32 位撑到 64 位——没有它,89 D8 就是 32 位的 mov eax, ebx。一个前缀字节,天壤之别,这也是为什么 64 位时代的老二进制分析资料经常让你先看前缀。
图 1-1:同一程序的三种视图对齐
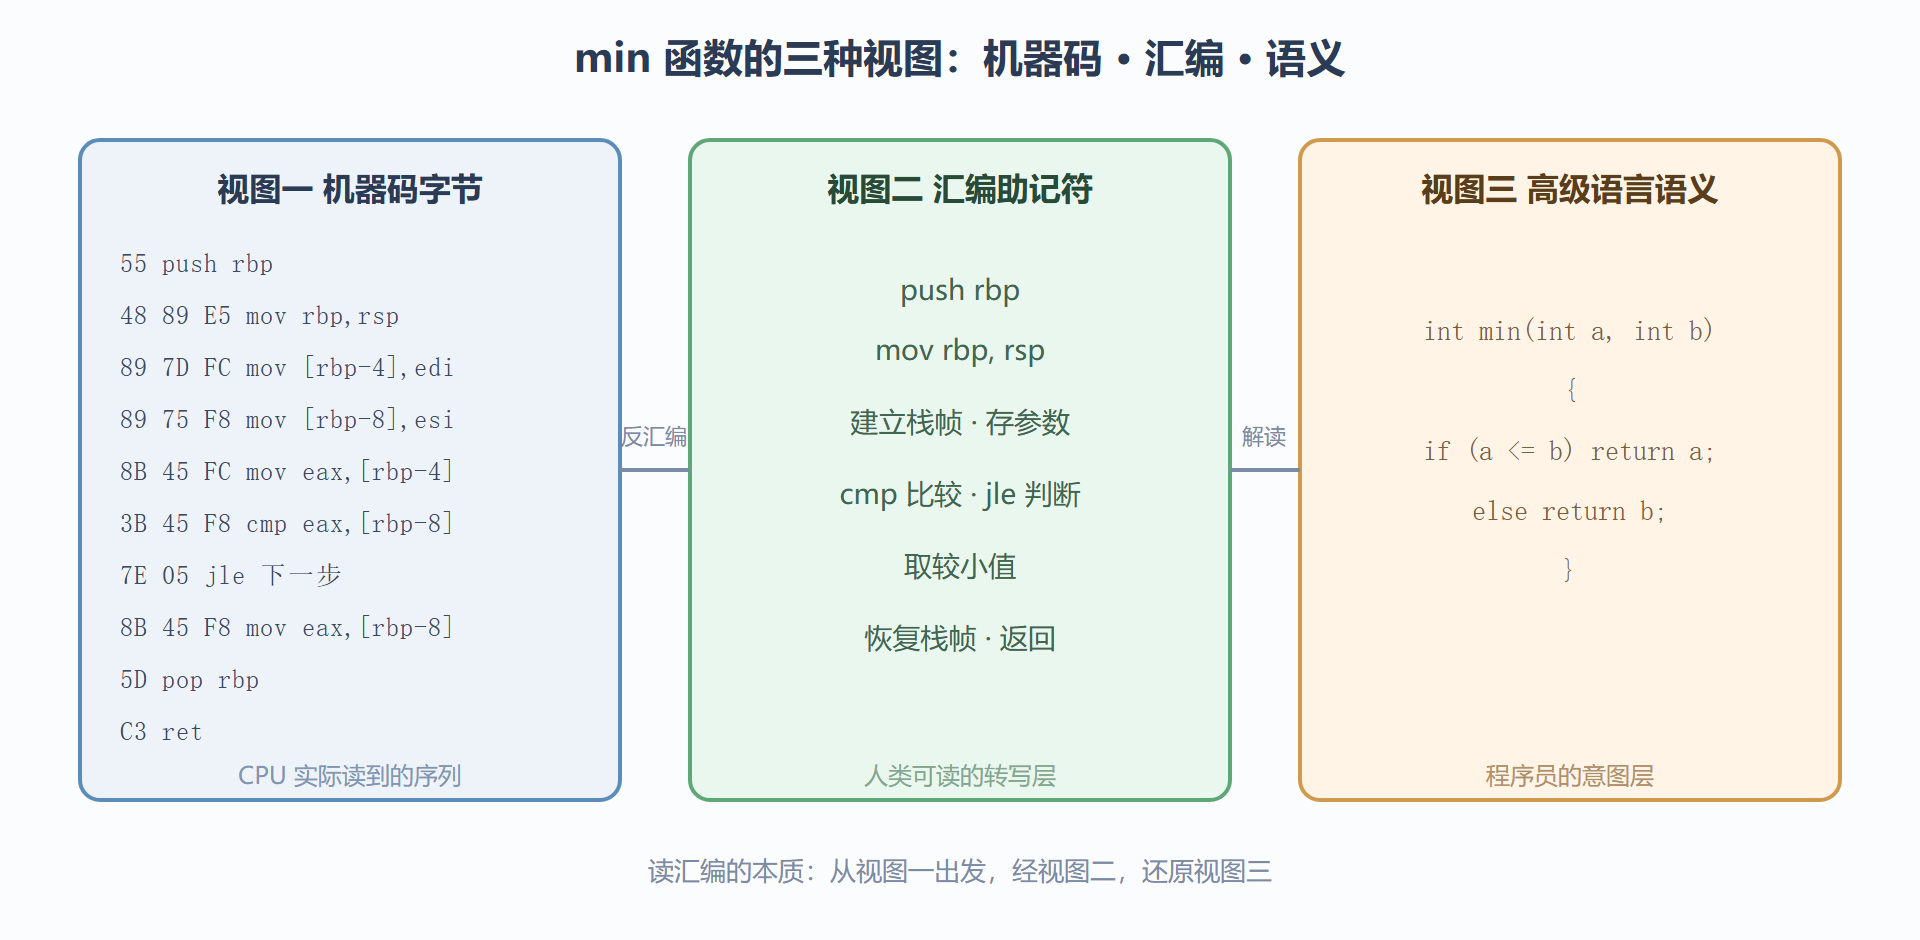
这张图值得盯半分钟。同一个 min 函数,机器码层是 CPU 的真实口粮,语义层是程序员的原始意图,汇编居中做转写。所谓"会读汇编",就是能从左边出发走到右边——而调试器和反汇编器替你完成的只是第一段箭头。
助记符是转写,不是翻译
初学者最常见的误会:以为 MOV 是"一条指令"。实际上 MOV 是一个家族的统称,家族成员的操作码各不相同。往寄存器塞立即数用 B8 系列,寄存器互送用 89 或 8B,往内存送立即数用 C7——它们只是"恰好都叫 MOV"。下表是这个家族的常见成员名单(数值以 x86-64 常用编码为准):
| 操作码 | 汇编写法 | 语义 |
|---|---|---|
| B8+r | mov eax, imm32 | 立即数送 32 位寄存器 |
| 89 /r | mov r/m32, r32 | 寄存器送内存或寄存器 |
| 8B /r | mov r32, r/m32 | 内存或寄存器读入寄存器 |
| C7 /0 | mov r/m32, imm32 | 立即数送内存 |
| A1 | mov eax, moffs32 | 绝对地址读入(少见) |
为什么要背这个表?不用背。要点在于理解"助记符 → 操作码"是一对多映射,方向反过来才是唯一的。这就解释了一个反汇编阅读的实用技巧:看反汇编输出时,别停留在 MOV 字面上,要看它的实际编码——操作码才唯一决定语义,这是 1.2 节 ISA 契约的第一块基石。同理,AT&T 语法里 movl 的后缀、Intel 语法里的尺寸前缀,都只是在"帮编译器选对家族成员",语法之争留到第 2 章展开。
⚠️ 常见坑:手工解码时按大端序读立即数。x86 的多字节数值一律低位字节在前,2A 00 00 00 是 42,而 00 00 00 2A 是 704643072。网络协议分析习惯了网络字节序(大端)的人在这里栽跟头的概率接近百分之百。
💡 关键直觉:变长指令 + 前缀 + 一对多映射,这三件事共同造成了"汇编反汇编不可逆"——从字节到汇编是唯一解,从汇编文本回字节却可能有多种编码。理解这一点,你就明白为什么反汇编器偶尔会"错位":一旦边界判断失误,后面所有字节都会被错误切分,整段代码面目全非。
动手:让工具替你走一遍
手工解码是内功,日常干活靠工具。下面把刚才的迷你函数跑通全流程(Linux 环境,NASM 语法),命令与会话输出如下:
; min42.asm —— 返回 42 的最小函数 section .text global min42 min42: mov eax, 42 ret
$ nasm -f elf64 min42.asm -o min42.o $ ld -shared -o min42.so min42.o $ objdump -d min42.so min42.so: file format elf64-x86-64 Disassembly of section .text: 0000000000001000 <min42>: 1000: b8 2a 00 00 00 mov eax,0x2a 1005: c3 ret
三个工具各司其职:NASM 负责把助记符翻成字节(汇编),ld 负责把目标文件拼成可加载的库(链接),objdump 负责把字节翻回助记符并配上地址(反汇编)。注意输出中间那列 b8 2a 00 00 00——这正是我们手工解过的那五字节。工具会话里还能再玩一步:用 xxd 直接看 min42.so 的 .text 段,你会看到 b8 开头的那串字节原封不动躺在文件里,说明"可执行文件就是字节流"不是比喻,是字面事实。
把"写 → 汇编 → 链接 → 反汇编"这条回路走顺,本册后续所有实验都复用它。第 2 章我们会给这条回路补上完整的理论地图(段、符号、重定位),并在 2.3 节拆开每一步中间产物。
本节要点回顾
- 汇编与机器码是转写关系:助记符到操作码是一对多,反方向才唯一,所以判读指令语义要看编码而非字面。
- x86-64 指令四段式:Legacy 前缀、REX 前缀、操作码、操作数字段,变长是常态而非例外。
- ModR/M 字节一位三用:mod 定寄存器或内存,reg 与 rm 各查一张寄存器表。
- 小端序:多字节立即数低位在前,手工读数必错的第一大坑。
- 工具链三步:汇编器生成字节、链接器拼装目标、反汇编器还原助记符,本册全部实验复用这条回路。
下一节我们把镜头拉高:这条编码规则是谁定的、凭什么全世界的芯片都认它——那是 ISA 契约的故事。