2.1 Intel 与 AT&T 双语法对照
2.1 Intel 与 AT&T 双语法对照
本节摘要:Intel 与 AT&T 是同一种机器码的两套"拼写方案",差别集中在操作数顺序、寄存器前缀、立即数记号、尺寸后缀与内存寻址写法五处。本节用同一段程序做双语对照,给出可背的五条互译规则,并演示让 objdump 与 GCC 按你习惯的语法输出的开关。读完你能在两种语法间无损互译,不再把方言差异误认成架构差异。
同一段程序,两种长相
先看一个容易闹出的真事。一位同事把 Linux 教程里的汇编抄进 Windows 的汇编器,程序死活跑不对;他坚持认为"Linux 和 Windows 的 CPU 不一样"。真相让他哭笑不得:CPU 当然一样,不一样的是教程用 AT&T 语法、汇编器认 Intel 语法,而两种语法最阴险的地方在于操作数顺序相反——照抄源目顺序,语义恰好掉头。这条反例说明的问题很普遍:方言不统一造成的困惑,比指令本身的难度坑了更多的人。
把同一个小函数各写一遍,差异一目了然。函数功能是"返回三个整数的和":
; ---- Intel 语法(NASM)---- section .text global sum3 sum3: lea eax, [rdi + rsi] add eax, edx ret
# ---- AT&T 语法(GNU as)---- .text .globl sum3 sum3: lea (%rdi,%rsi), %eax add %edx, %eax ret
两份源码汇编出的机器码完全相同——所谓语法之争,争的只是"怎么拼写字节流",不涉及任何语义分歧。盯住这两段源码,五处差异全部现身。
五处差异逐项拆解
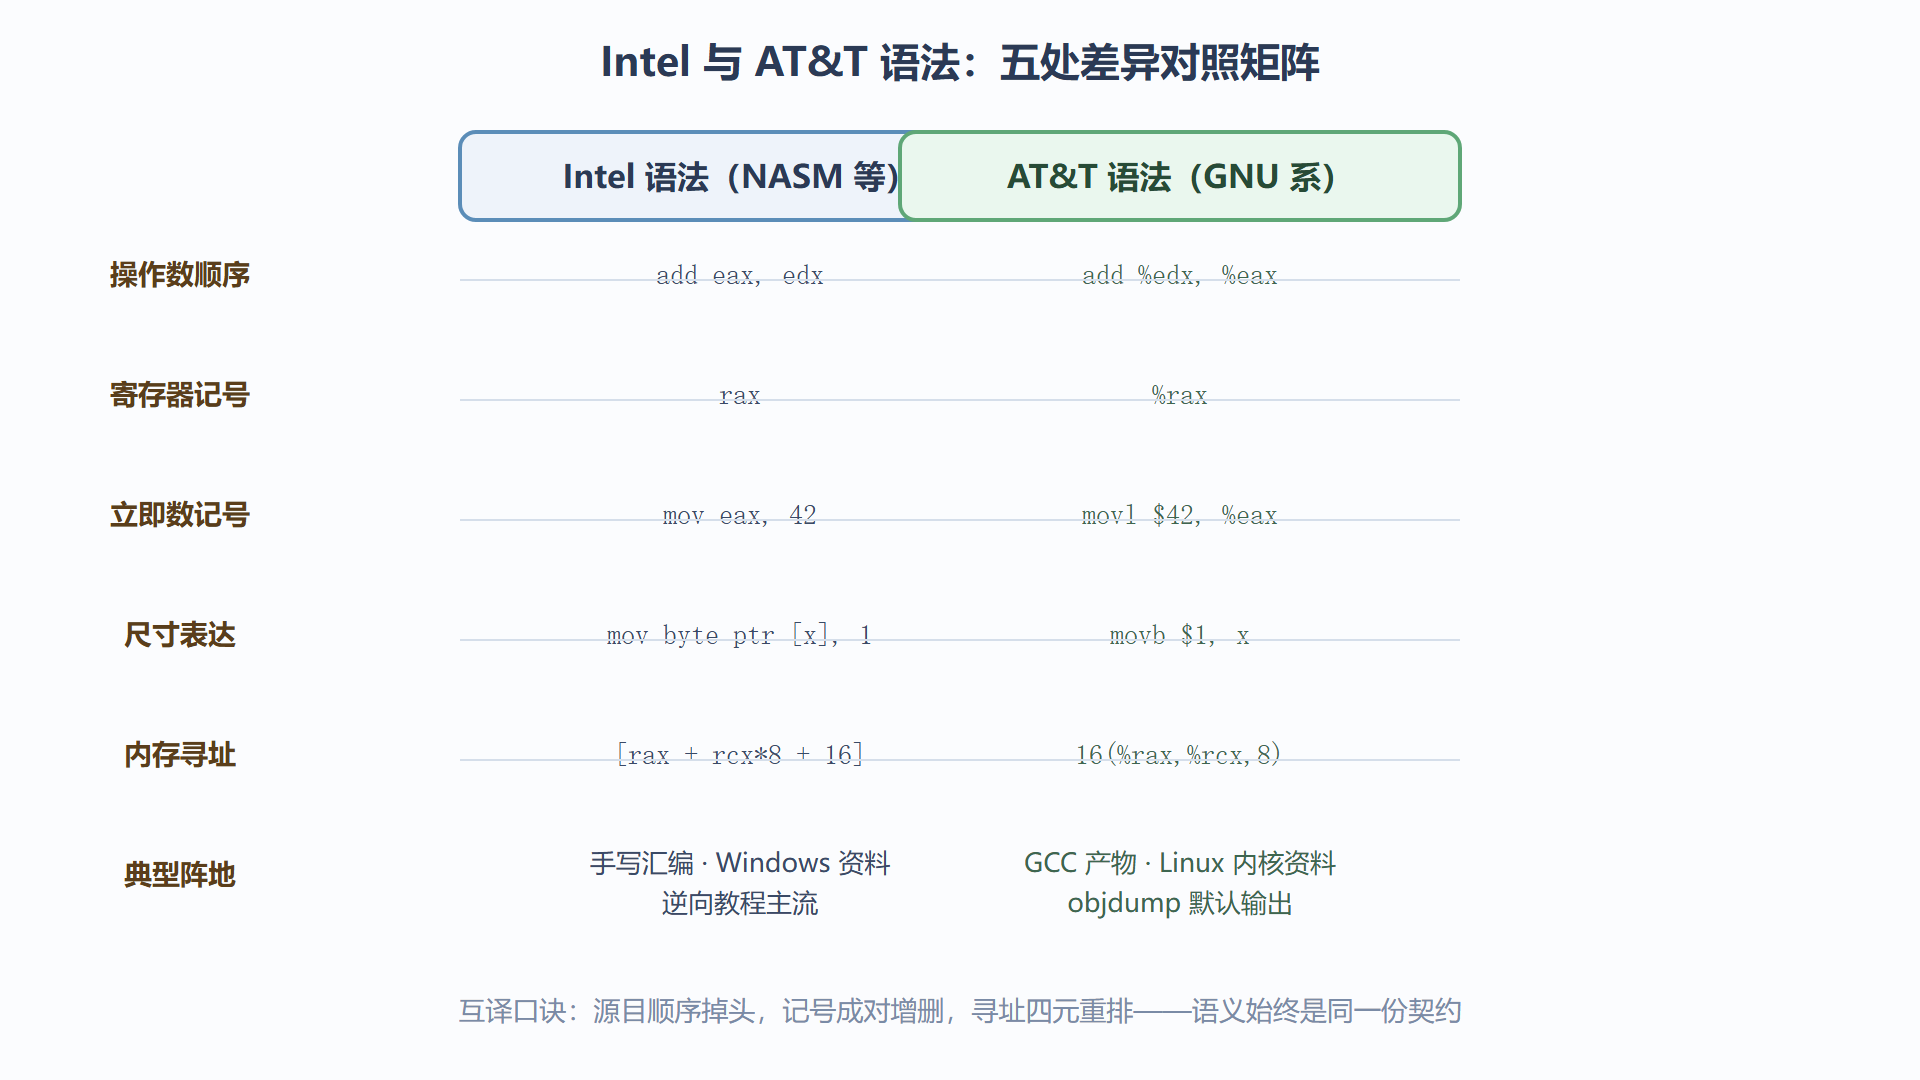
差异一:操作数顺序。 Intel 写 add eax, edx,读作"eax 加上 edx";AT&T 写 add %edx, %eax,源操作数在前、目的在后。这是最致命的差异,因为它改变了语义而不只是外观——手工互译时顺序翻错,程序不会报错,只会安静地算错。规则只有一句:Intel 是"目的在前",AT&T 是"源在前"。
差异二:寄存器与立即数的记号。 AT&T 给寄存器加百分号前缀(rax 写作 %rax),给立即数加美元号(42 写作 $42);Intel 裸写寄存器名,立即数直接写数字。记号的作用是让汇编器一眼分清"这是个数还是个符号"——AT&T 里 42 表示内存地址 42 处的值,$42 才是数值本身,这个区分在 Intel 语法里要靠方括号承担。
差异三:操作数尺寸的表达。 AT&T 靠指令后缀声明宽度:movb 一字节、movw 两字节、movl 四字节、movq 八字节;Intel 靠寄存器名自带宽度(eax 即四字节),或用 byte ptr、word ptr 之类的尺寸指示修饰内存操作数。同一个动作,AT&T 写 movl $1, %eax,Intel 写 mov eax, 1——宽度信息一个挂在指令上,一个藏在寄存器里。
差异四:内存寻址的写法。 这是最需要练的一项。AT&T 用圆括号元组:位移(基址, 变址, 比例),省略的分量留空;Intel 用方括号算术:[基址 + 变址*比例 + 位移]。四个元素完全相同,只是排列与记号不同:
| 语义 | Intel 写法 | AT&T 写法 |
|---|---|---|
| 取 rax 指向的值 | [rax] |
(%rax) |
| 栈上局部变量 | [rbp - 8] |
-8(%rbp) |
| 数组按 8 字节取元素 | [rax + rcx*8] |
(%rax,%rcx,8) |
| 结构体字段再偏移 | [rax + rcx*8 + 16] |
16(%rax,%rcx,8) |
差异五:跳转指令的记号。 近跳转 AT&T 在助记符前不加点(jmp、call),经由 GOT 的位置无关跳转加星号与偏移写法;Intel 系汇编器的分支一律直接写目标符号。日常读反汇编时只需记住:看到 %rip 相对寻址的注释(# 5a67 <foo>),那是 AT&T 风格输出在帮你把 RIP 相对地址换算成符号。
图 2-1:双语法五处差异对照矩阵
动手:让工具听你的
与其死记对照表,不如把工具调成统一语法、让机器替你互译。两处开关覆盖九成场景。其一是 objdump 加 -M intel 参数,反汇编输出立刻从 AT&T 切到 Intel:
$ objdump -d sum3.o ; 默认 AT&T 0: 8d 04 37 lea (%rdi,%rsi,1),%eax 3: 01 d0 add %edx,%eax 5: c3 ret $ objdump -d -M intel sum3.o ; 切 Intel 0: 8d 04 37 lea eax,[rdi+rsi*1] 3: 01 d0 add eax,edx 5: c3 ret
中间那列机器码两行完全一致——语法的"翻译无损"直接可见。其二是 GCC 生成汇编时加 -masm=intel,让编译器产物不再坚持 AT&T 阵营;第 5 章的对照实验全程用这个开关,省去边读边译的心智负担。还有一个细节值得养成习惯:GDB 里用 set disassembly-flavor intel,调试窗口从此和你读的资料同一种口音。
⚠️ 常见坑:把 AT&T 的 movl 误读成"mov 减 1"或别的什么。后缀 l 是 long 的历史缩写,对应四字节,与数值含义无关;同理 q 是四字(quadword)、w 是字(word)。这批缩写来自 16 位时代的内存模型,当代读码只需机械对应宽度。
💡 关键直觉:语法差异全部停留在"拼写层",1.2 节的 ISA 契约管不着它们——契约规定的是字节与语义的绑定,拼写是人与汇编器之间的私事。想通这一点,两种语法就从"两门语言"降级成了"一套音标"。
最后提供一个自测小实验,检验你是否真的过了方言关。找一段你从未见过的反汇编输出(任何开源库都行),遮住工具栏,只看指令文本,30 秒内判断它是什么语法——判据说出来应该是这样的:操作数里带百分号是 AT&T,方括号加星号乘法是 Intel,指令尾缀挂 b、w、l、q 是 AT&T,尺寸修饰 byte ptr 挂在内存操作数前是 Intel。三秒钟出结论,靠的不是背表,是"扫视特征"——就像认口音不需要分析语法。这个扫视能力会在第 7 章逆向实战里每天使用,值得现在就练成本能。
本节要点回顾
- 五处差异:操作数顺序、寄存器与立即数记号、尺寸表达、内存寻址写法、跳转记号;其中顺序差异会改语义,其余只改外观。
- 互译口诀:源目掉头、记号增删、寻址四元重排。
- 三个开关:objdump 的
-M intel、GCC 的-masm=intel、GDB 的set disassembly-flavor intel,统一口音后专心看语义。 - 机器码是仲裁者:判断两种写法是否等价,比对其汇编产物即可,无须争论。
词汇关已过,下一节搭骨架:段与符号如何把指令组织成程序。