3.1 数据传送与算术逻辑指令
3.1 数据传送与算术逻辑指令
本节摘要:数据类指令是汇编中使用频率最高的一族,核心成员不过十余条:mov 负责搬运、lea 负责"算地址顺便当计算器"、xchg 负责交换,加法乘法与位运算各司其职。本节逐条讲清它们的语义与脾气——mov 的操作数不能两边都是内存、立即数有尺寸上限、lea 不碰标志位——并用反汇编实证每条脾气。读完你能读懂普通函数里九成的数据指令,并知道哪些"想当然"的写法会直接被汇编器拒绝。
先定义"数据操作"的范围
给本节的任务画个边界:凡是以"把数据从 A 处弄到 B 处"或"把数据加工成另一个值"为使命的指令,都算数据操作。这个家族的成员名单短得惊人——mov、lea、xchg、push/pop(栈上的搬运,第 4 章细讲)、add/sub/imul、inc/dec、and/or/xor/not、shl/shr。相应地,把控制流(跳转调用)、特权管理留给 3.2 与 3.3。判别一个函数"在算什么",九成的证据来自这份短名单。
学这批指令的正确姿势不是背语义——语义一查就有——而是记脾气:尺寸限制、副作用、被拒绝的写法。脾气才是反汇编阅读时真正消耗判断力的地方,也是本节的全部重心。
mov:最常用,也最有规矩
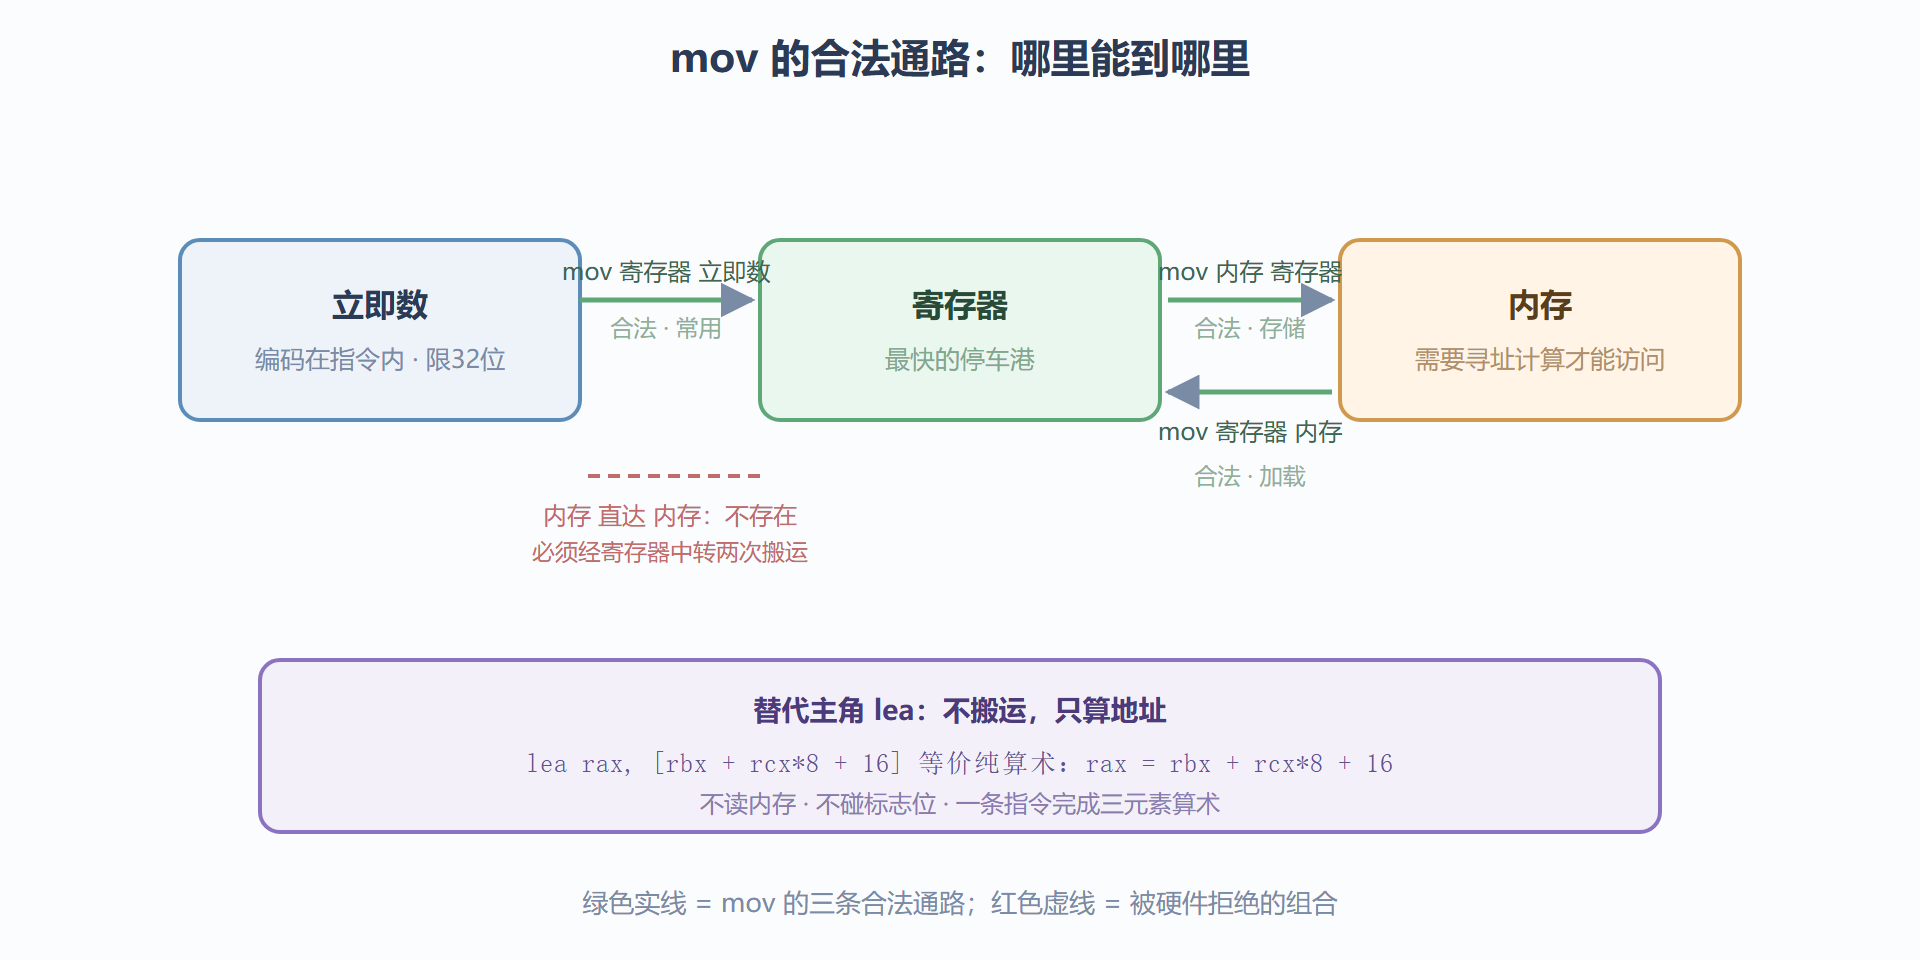
mov 的语法是 mov 目的, 源,但能填什么受三条规矩约束。规矩一:源与目的不能同时是内存——x86 的数据通路里,内存到内存的搬运必须经寄存器中转,硬写 mov [a], [b] 汇编器直接报错。这不是语法洁癖,是硬件事实:一条指令只有一次内存读写通路,两次访问需要两条指令。
规矩二:立即数有尺寸上限。往 64 位寄存器塞立即数,汇编器只能编出 32 位立即数的编码,超过 0xFFFFFFFF 的常数要么用 movabs(64 位立即数专用编码),要么拆步骤:
mov rax, 0x12345678 ; 合法:32位立即数,高位自动清零 mov rax, 0x123456789A ; 报错:立即数超32位 movabs rax, 0x123456789A ; 合法:64位立即数专用编码 mov eax, 1 ; 注意:写eax会自动把rax高32位清零
第三行注释里的"自动清零"是个隐藏脾气:写入 32 位寄存器时,对应 64 位寄存器的高半部分被无条件清成零——这是 x86-64 的设计决定(写入 8/16 位子寄存器则保留高位)。写惯了 16 位代码的人常在这里翻车:mov al, 5 之后 rax 的高位还是旧值,mov eax, 5 之后 rax 高位必定是零。反汇编读码时同理:看到 mov eax, ... 就等于看到"rax 高 32 位归零",这是免费信息。
规矩三:尺寸必须成对。mov eax, bl 这种一字节与四字节的混搭没有对应编码,得显式使用 movzx 或 movsx 做零扩展/符号扩展搬运——顺便说,这对指令也是读 C 代码反汇编的老熟人:无符号 char 短整提升对应 movzx,有符号对应 movsx,看到它们就等于看到一次隐式类型转换。
图 3-1:数据在寄存器、内存与立即数之间的合法通路
lea:被误读最深的"搬运工"
lea 名义上是"加载有效地址",实际身份是汇编世界的计算器。lea rax, [rbx + rcx*8 + 16] 不访问内存,只把方括号里那套"基址加变址乘比例加位移"的寻址算术算出来存进 rax。三个特性使它成为编译器的心头好:一条指令完成三元算术、完全不碰标志位(3.2 节会讲这有多方便)、不产生内存访问延迟。
编译器把 lea 用出了花:乘 5 写成 lea eax, [rdi + rdi*4],乘 9 写成 lea eax, [rdi + rdi*8];加常数、算数组下标、凑指针偏移,全是它的活。读反汇编时见到方括号里没有实际内存语义的 lea,第一反应应该是"这是在做算术",而不是"这是在取地址"。
算术与逻辑:运算家族的分工与副作用
算术家族的语义直白,要点在副作用。add、sub、cmp 都会按结果更新全部六个状态标志(进位、零、符号、溢出等,3.2 节展开);inc/dec 也更新标志但保留进位标志——这个细节让 inc 能安全地用于多精度加法的循环里而不破坏进位链;neg(取负)与 not(按位取反)一字之差,前者是"零减自身"的算术运算、会置标志,后者是纯位翻转、只清进位与溢出。位运算三兄弟里,xor eax, eax 值得单独点名:把寄存器与自己异或是清零的惯用法,编码只有两字节,比 mov eax, 0 还短,反汇编里出镜率极高。
乘除法是家族里的怪脾气成员。imul 一条指令最多三操作数(imul rax, rcx, 5 一步完成 rax 乘 5 存 rax),但除法 idiv 固定使用一对寄存器放被除数(64 位除法要求把被除数放在 rdx:rax 这对搭档里),且除零不抛 arithmetic 异常而是硬件中断——这些约束让编译器宁可把除法优化成乘法加移位(第 5 章对照实验里会亲眼见到这个魔法)。
| 指令 | 常见脾气 | 阅读提示 |
|---|---|---|
| mov | 双内存禁止;立即数限 32 位;写 32 位寄存器清高 32 位 | 见 mov eax 即知 rax 高半归零 |
| movzx / movsx | 宽度不等搬运必经之路 | 分别对应无符号/有符号的类型提升 |
| lea | 不访存、不碰标志位 | 大概率在做算术而非取地址 |
| add / sub / cmp | 更新全部六标志 | cmp 是"只改标志的减法" |
| inc / dec | 更新标志但保留进位 | 多精度运算安全 |
| xor eax, eax | 两字节清零惯用法 | 等价 mov eax, 0 且更短 |
| imul | 支持三操作数 | 除法 idiv 才是难伺候的那个 |
⚠️ 常见坑:把 cmp 当成"比较专用指令"以为它不产生计算。cmp 的机器本质就是 sub,只是结果丢弃、标志保留——理解这一点,"为什么 cmp 能测相等也能比大小"就不再是记忆题。
💡 关键直觉:数据指令的成本分层极其清晰——寄存器到寄存器最快、带内存操作数次之、跨段的搬运最贵。读反汇编时留意内存操作数的密度,就能对一段代码的性能档次做出秒级估计,这个直觉在 6.1 节会升级成系统方法。
本节要点回顾
- mov 三规矩:双内存禁止、立即数限 32 位(超限用 movabs)、写 32 位寄存器自动清高 32 位。
- lea 是计算器:三元素算术一条搞定,不访存不碰标志,编译器最爱的算术替身。
- 类型提升现形记:movzx 与 movsx 对应 C 隐式转换的无符号与有符号两条路。
- 副作用即语义:cmp 是丢结果的减法,inc 保进位,xor 自反清零——脾气本身就是信息。
数据的来路与加工已经清楚,但程序总得"分岔"。下一节解剖分岔的幕后推手:标志位。