4.1 寻址方式全景:有效地址的四元素拼法
4.1 寻址方式全景:有效地址的四元素拼法
本节摘要:x86-64 的全部寻址方式可以用一个公式统一:有效地址 = 基址 + 变址 × 比例 + 位移。教科书里并列罗列的"立即寻址、寄存器寻址、直接寻址、间接寻址、变址寻址"等名目,不过是四元素取不同子集的特例。本节先立四元素模型,再按"服务什么数据结构"把拼法一一归位,最后给出场景到寻址方式的选型表。读完你能看任何内存指令一眼报出有效地址,也能为给定访问场景挑出编码最省的写法。
一个问题引出全部寻址方式
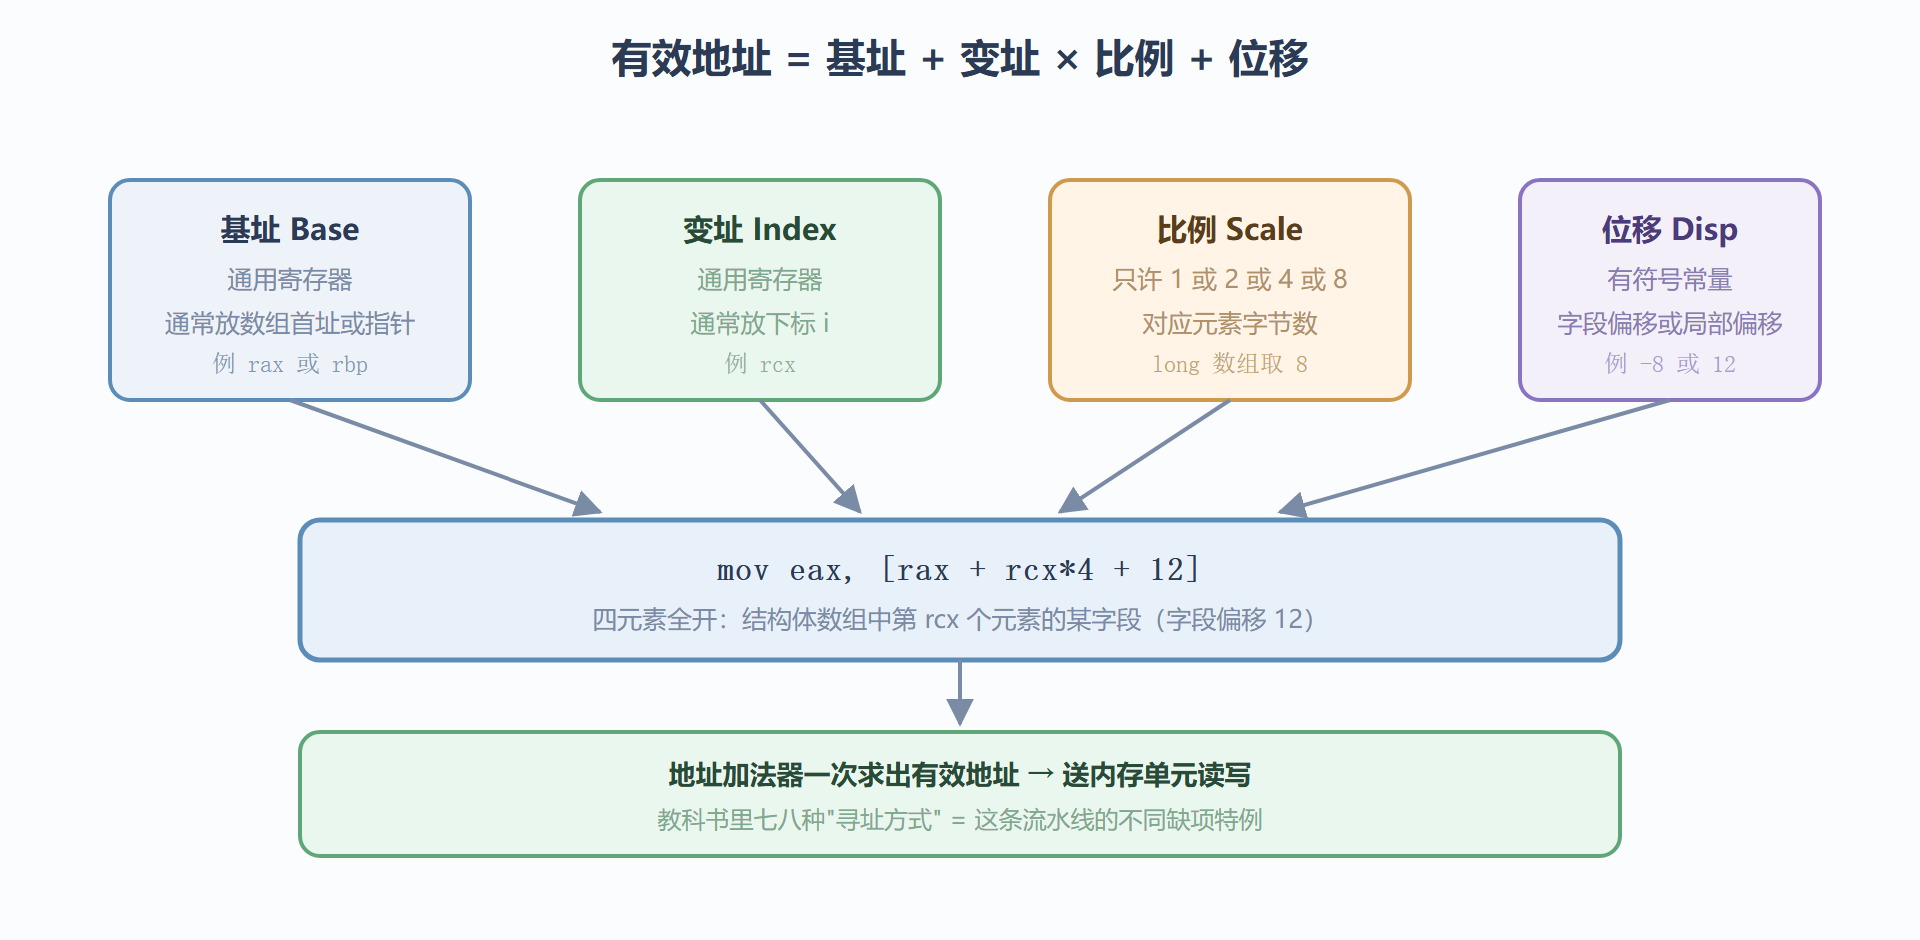
从一个问题开始:指令 mov eax, [rax + rcx*4 + 12] 执行时,CPU 到底去哪个地址取数据?答案需要一次小小的计算:把 rax 的值加上 rcx 的值乘四、再加十二,算出来的那个数才是真正的内存地址——这个计算结果有个正式名字,有效地址(Effective Address)。整节内容都从这个计算展开:四个可选项(基址寄存器、变址寄存器、比例因子、位移常量)各是什么、哪些组合合法、每个组合在真实程序里对应什么。
先交代两件边界事。其一,四元素里的比例只允许 1、2、4、8 四档——对应字节、双字节、四字节、八字节元素,这组硬编码直接透露了寻址硬件的原始使命:服务数组下标。其二,方括号之外还有第五元素(段基址),但 x86-64 的分段已经退化(段基址基本为零,4.2 与 6.3 节会补充上下文),日常寻址计算可以完全忽略它。
从特例到通式:教材名目的统一
把教科书的寻址方式清单按四元素重排,你会发现它们是一个家族的不同"缺项"写法:
| 寻址名目 | 四元素形态 | 汇编示例 | 对应的高级语言访问 |
|---|---|---|---|
| 立即寻址 | 无内存访问 | mov eax, 42 | 常量赋值(不寻址) |
| 寄存器寻址 | 无内存访问 | mov eax, ebx | 局部变量在寄存器 |
| 直接寻址 | 仅位移 | mov eax, [count] | 全局变量 / 静态变量 |
| 寄存器间接 | 仅基址 | mov eax, [rax] | 指针解引用 |
| 基址加位移 | 基址 + 位移 | mov eax, [rbp - 8] | 栈上局部变量 |
| 变址寻址 | 基址 + 变址×比例 | mov eax, [rax + rcx*8] | 数组元素 arr[i] |
| 完整四元素 | 全部四项 | mov eax, [rax + rcx*8 + 12] | 结构体数组字段访问 |
这张表值得读三遍,因为它回答了一个常见困惑:为什么教材要背七八种寻址方式,而汇编器只认一种语法?因为硬件只有一套地址加法器,"多种寻址方式"是教学抽象,四元素才是物理事实。读反汇编时同理——不用回忆"这叫什么寻址",直接把方括号里四元素代入公式算出有效地址即可,名目只是事后贴的标签。
图 4-1:有效地址四元素的拼装流水线
场景选型:什么访问用什么拼法
理解通式之后,工程问题变成选型问题:给定一次数据访问,哪种拼法编码最省、执行最快。经验法则是"缺项越少、编码越短"——每多一个元素,指令编码多出对应的字节(变址加比例要补 SIB 字节,位移按大小占一到四字节)。按高频场景整理如下:
| 访问场景 | 推荐拼法 | 编码代价 | 备注 |
|---|---|---|---|
| 全局变量 | 仅位移 | 4 字节位移 | RIP 相对寻址更常见(见下) |
| 栈上局部变量 | rbp 或 rsp 加单字节位移 | 1 字节位移 | 第 4.2 节主角 |
| 指针解引用 | 仅基址 | 无附加字节 | 最便宜 |
| 数组遍历 | 基址 + 变址×比例 | 补 SIB 字节 | 下标放变址寄存器 |
| 结构体字段 | 基址 + 常量位移 | 单字节位移 | 偏移小于 128 时最省 |
| 结构体数组 | 四元素全开 | SIB 加位移 | 完整形态 |
场景表里埋着一个当代特有的答案:全局变量的推荐拼法其实已经不是"仅位移",而是 RIP 相对寻址——mov eax, [rip + 0x2f0a],以指令指针为隐式基址加 32 位位移。动机在 2.3 节埋过伏笔:相对编址让代码段可以整体搬迁(位置无关),现代系统的共享库与地址随机化都依赖它。反汇编输出里看到 rip 加偏移,直接查同行的注释(工具会算出目标符号)即可。
动手:算三遍,形成直觉
选型表要变成直觉,靠亲手算。三道递进练习(寄存器初值:rax=0x1000,rcx=3):
; 第一题:仅基址 mov eax, [rax] ; 有效地址 = 0x1000 ; 第二题:数组访问,long 数组取第 rcx 个 mov rdx, [rax + rcx*8] ; 有效地址 = 0x1000 + 3*8 = 0x1018 ; 第三题:结构体数组,元素 16 字节,字段在偏移 4 mov r8d, [rax + rcx*16 + 4] ; 报错!比例只许 1/2/4/8
第三题故意埋了个雷:元素 16 字节的结构体数组无法用比例一步到位(比例上限 8),正确写法是先把下标乘 16 放进寄存器再间接寻址:
mov rcx, 3 shl rcx, 4 ; rcx = 3 * 16 = 48 mov r8d, [rax + rcx + 4] ; 有效地址 = 0x1000 + 48 + 4 = 0x1034
这个"比例上限 8"的边界在真实代码里天天遇到:任何大于八字节的元素类型(结构体、long double、向量)都逃不开这条两步走的路径。GDB 里可用 x 命令验证上述每一步:x/1dx 0x1018 打印该地址内容,把算出的有效地址与调试器看到的真实访问对账——4.3 节的排错正是把这套对账动作反过来用。
补一个当代产物的常见验证场景:RIP 相对寻址的地址怎么手算。设某指令位于 0x401020、长七字节,其 rip 相对操作数写作 [rip + 0x2f0a]——注意 rip 的取值不是当前指令地址,而是下一条指令地址(0x401027),所以目标地址是 0x401027 加 0x2f0a 等于 0x403F31。"rip 指向下一条"这个细节是手工核对反汇编换算时最容易翻车的点,objdump 通常会在行尾注释里替你算好,但工具缺席时(手读裸字节、读崩溃日志)你得自己来。
💡 关键直觉:寻址四元素不是语法糖,是硬件地址加法器的输入端口。编译器选拼法的逻辑永远是"把常用访问形状映射到端口组合上"——理解了这层映射,你在 5.1 章读编译器产物时,会发现每个方括号表达式都意料之中。
本节要点回顾
- 四元素通式:基址加变址乘比例加位移,教材的各种寻址名目全是它的缺项特例。
- 比例上限 8:超八字节的元素类型必须先乘后访,两步走。
- RIP 相对寻址:现代全局访问的主流拼法,位置无关的地基。
- 选型法则:缺项越少编码越短;栈局部变量走 rbp 减位移,数组走基址加变址乘比例。
寻址的语法就位。下一节给这些表达式一个最密集的舞台——栈:一次函数调用里,栈帧如何搭起、如何拆除。