5.1 一个 C 函数的编译旅行
5.1 一个 C 函数的编译旅行
本节摘要:让同一段 C 函数分别以 -O0 与 -O2 编译,把两份汇编产物逐行对照,能看清编译器"直译"与"改写"的两副面孔:未优化版本忠实到笨拙,每行 C 对应一串 load-compute-store;优化版本脱胎换骨,循环展开、指令替换、寄存器全包。本节全程用真实编译输出做教材,读完你能认出编译器的招牌手法,并对"一行代码的成本"建立起汇编级的直觉。
从一段历史说起
上世纪七十年代,编译器还只是"翻译员"——你写什么它翻什么,优化是奢侈品。Fortran 编译器率先把优化做成卖点,此后五十年,编译优化从"可选项"长成了"默认项":今天的 -O2 产物与源码之间的距离,比任何一代汇编程序员手写的代码都要远。这带来一个必须直面的现实:你写的 C 不是运行的代码,编译器产物才是。理解这场翻译,不是出于怀旧,而是因为调试、性能、逆向三条路上,你打交道的对象都是产物。
选教材的标准动作:一个足够小但五脏俱全的函数——带循环、带数组访问、带算术。就用数组求和:
// sum.c long sum_array(const long *arr, long n) { long s = 0; for (long i = 0; i < n; i++) s += arr[i]; return s; }
-O0 版本:诚实的直译
用 gcc -O0 -S -masm=intel sum.c 产出版本一(节选主干,省去啰嗦的函数序言尾部):
sum_array: push rbp mov rbp, rsp mov [rbp-24], rdi ; arr 存进栈上槽位 mov [rbp-32], rsi ; n 同上 mov QWORD PTR [rbp-8], 0 ; s = 0 mov QWORD PTR [rbp-16], 0; i = 0 .L2: mov rax, [rbp-16] ; 循环判断:i < n cmp rax, [rbp-32] jge .L4 mov rax, [rbp-8] ; s += arr[i] mov rdx, [rbp-16] lea rcx, [rdx*8] mov rdx, [rbp-24] add rcx, rdx mov rdx, [rcx] add rax, rdx mov [rbp-8], rax add QWORD PTR [rbp-16], 1; i++ jmp .L2 .L4: mov rax, [rbp-8] ; 返回 s pop rbp ret
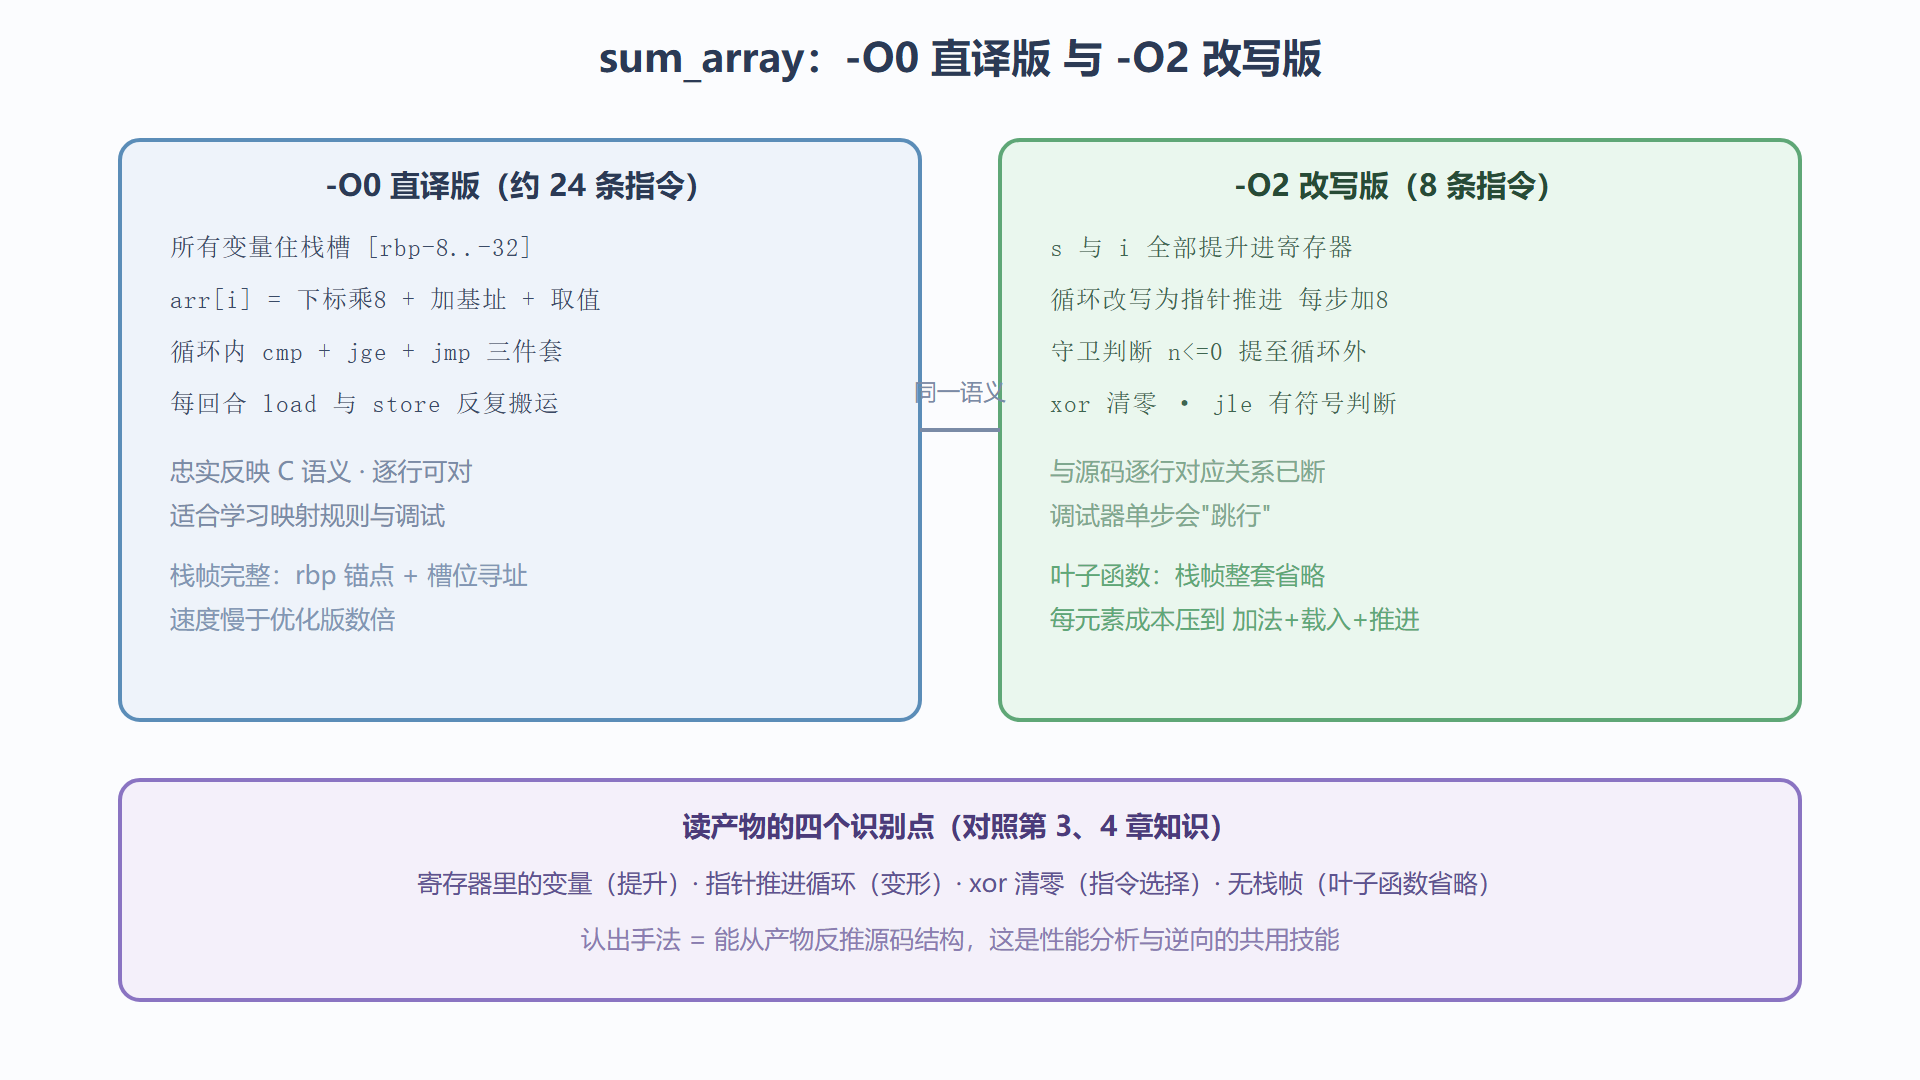
几乎每一行 C 都能逐字对上:每个变量都在栈上有个槽位(-O0 的铁律:变量必须可调试,绝不住寄存器),每次读写都老老实实 load 再 store,连 arr[i] 都拆成了"下标乘八、加基址、取值"三步——4.1 节的寻址四元素在这里原样出演。这个版本的价值是教学性的:它证明了 C 语义到汇编的映射规则,也解释了为什么 -O0 构建慢上几倍——每个变量每回合都要回栈上走一遭。
-O2 版本:改写大师的稿子
同一函数换 -O2 再产一版:
sum_array: xor eax, eax ; s = 0(两字节清零惯用法) test rsi, rsi jle .Ldone ; n <= 0 直接返回 lea rcx, [rdi + rsi*8] ; 预算末元素后一位置的地址 .Lloop: add rax, QWORD PTR [rdi] ; 直接从指针取数累加 add rdi, 8 ; 指针推进 8 字节 cmp rdi, rcx jne .Lloop .Ldone: ret
对照之下,编译器动了四处手脚,每一处都有名字。变量提升:s 与 i 从栈槽搬进了寄存器(eax 与 rdi),整个函数没有任何栈读写——4.2 节的栈帧协议被合法省略,因为它是个叶子函数。循环变形:计数循环被改写成指针推进循环,下标乘八的算术被并进"每次加八"的推进量里,寻址四元素缩成了最便宜的"仅基址"拼法。守卫判断前置:n 小于等于零的情况被提到循环之前一次判断,省掉循环内的条件比较——这正是 3.2 节说的"先判断后执行"形状。指令选择:清零用 xor 而非 mov,判断用 jle(有符号,因为 long 有符号),处处都是第 3 章讲过的脾气。
图 5-1:同一函数两版产物的逐项对照
改写的边界:什么不会被优化掉
编译器大胆,但不是无限大胆——它只能在"可观察行为不变"的约束内改写。三个反例值得知道,它们解释了性能代码里一些看似奇怪的写法。其一,带 volatile 的变量绝不优化:每次读写都必须真实访存,内存映射寄存器与信号处理器场景靠它保命。其二,有副作用的调用不能删:函数调用可能改全局状态,编译器看不到函数体时一律保守保留。其三,除法与浮点运算的改写有精度红线:整数除以常数可以变乘法加移位(5.3 节会实测),但浮点表达式的结合律改写默认禁止(除非开 -ffast-math),因为浮点不满足结合律,改了结果可能不同。
这份约束清单反过来就是优化产物的阅读心法:反汇编里看到的每处"怪改写",背后必有一条允许它改的规则;看不懂时,先问"这个改写保持了什么不变",而不是"编译器为什么发疯"。
还有一个编译产物里出镜率极高的现象值得单独拆解:中间值的消失。C 源码里看似存在的临时变量,在优化产物里可能找不到任何痕迹——不是被删了,而是它从来只存在于源码的记法里,真实的计算在寄存器间一步完成。回看 -O2 版产物:源码里的 i、s 以及 arr[i] 的地址计算中间值,全都活在 rdi 与 rax 的流转里,没有一个落过栈。这解释了调试器里一个高频困惑:"监视表达式 i 求值失败"或"值看起来跳变"——变量已被优化,调试器显示的是它最后存在过的位置,或者干脆无位置可显示。遇到这种情况,换用寄存器窗口直接看 rax 与 rdi,比和已被消除的变量较劲有效得多。
⚠️ 常见坑:拿 -O0 产物的行号对应关系去调试 -O2 版本。优化后指令被重排、合并、删除,逐行对应已不存在——断点"跳来跳去"不是编译器出错,是源码到产物的映射从"一对一"变成了"多对一"。性能分析要用产物视角,调试定位要么换回 -O0,要么学会在优化代码里按函数与循环边界设断。
💡 关键直觉:读优化产物像读速记——单个符号认不出,但模式是有限的。本节四个识别点(提升、变形、前置、指令选择)覆盖了一般 C 代码的多数产物形态,模式库存到十个左右,中等复杂度的函数产物基本能通读。
本节要点回顾
- -O0 是教学镜:变量住槽位、逐行直译,用它学习 C 到汇编的映射规则最合适。
- -O2 四板斧:变量提升进寄存器、循环改指针推进、守卫前置、指令选择替换——合法前提是可观察行为不变。
- 叶子函数免栈帧:4.2 节协议的省略条款在真实产物里随处可见。
- volatile 与副作用是优化禁区:读到"反复访存""看似多余的调用",先想到这两条红线。
产物里所有跨函数的 call 都遵循着同一份契约。下一节把这份契约逐条拆开:参数怎么传、现场谁保存、返回值放哪。