6.1 性能优化:从指令选择到缓存友好
6.1 性能优化:从指令选择到缓存友好
本节摘要:性能优化的正路是证据链:先用计数器测量瓶颈在哪一层(指令数、缓存、依赖链),再针对那一层动手,最后复测验证。本节建立一个三层成本模型——指令选择层、微架构层、缓存层——并用一个完整案例演示"先测量、后动手、再验证"的全流程,顺带推翻两个流传最广的优化谣言。读完你能把"程序慢"拆解成可验证的具体归因,而不是凭口诀瞎改。
一个优化反例开场
某代码评审会上,一位同事坚持要把函数里的除法换成移位:"除法比移位慢几十倍。"代码是 x / 8,x 是 signed int。听上去有道理,改完 -O2 产物一看:编译器早已把除法变成了乘法加移位的组合(5.1 节预告过的魔法),而且编译器版本处理了负数取整方向——同事手写的 x >> 3 对负数结果偏差一,引入了一个真 bug。这个反例的两层教训贯穿本节:不测量就动手是谣言的温床;手写优化的第一对手往往是编译器,不是硬件。
优化必须先回答"慢的根源在哪一层"。为此需要一个成本地图,而不是一堆孤立的"快慢常识"。
三层成本模型
把执行时间的去向分成三层,每层有自己的观察指标与优化杠杆:
| 层级 | 成本来源 | 观察指标 | 典型杠杆 |
|---|---|---|---|
| 指令选择层 | 用了更贵或更多的指令 | 指令数、每类指令计数 | 换指令、消乘除、向量化 |
| 微架构层 | 依赖链、分支预测失败、前端瓶颈 | 每周期指令数、分支缺失率 | 拆依赖链、消分支、缩短关键路径 |
| 缓存层 | 内存访问未命中 | 缓存缺失次数与命中率 | 改访问顺序、分块、预取 |
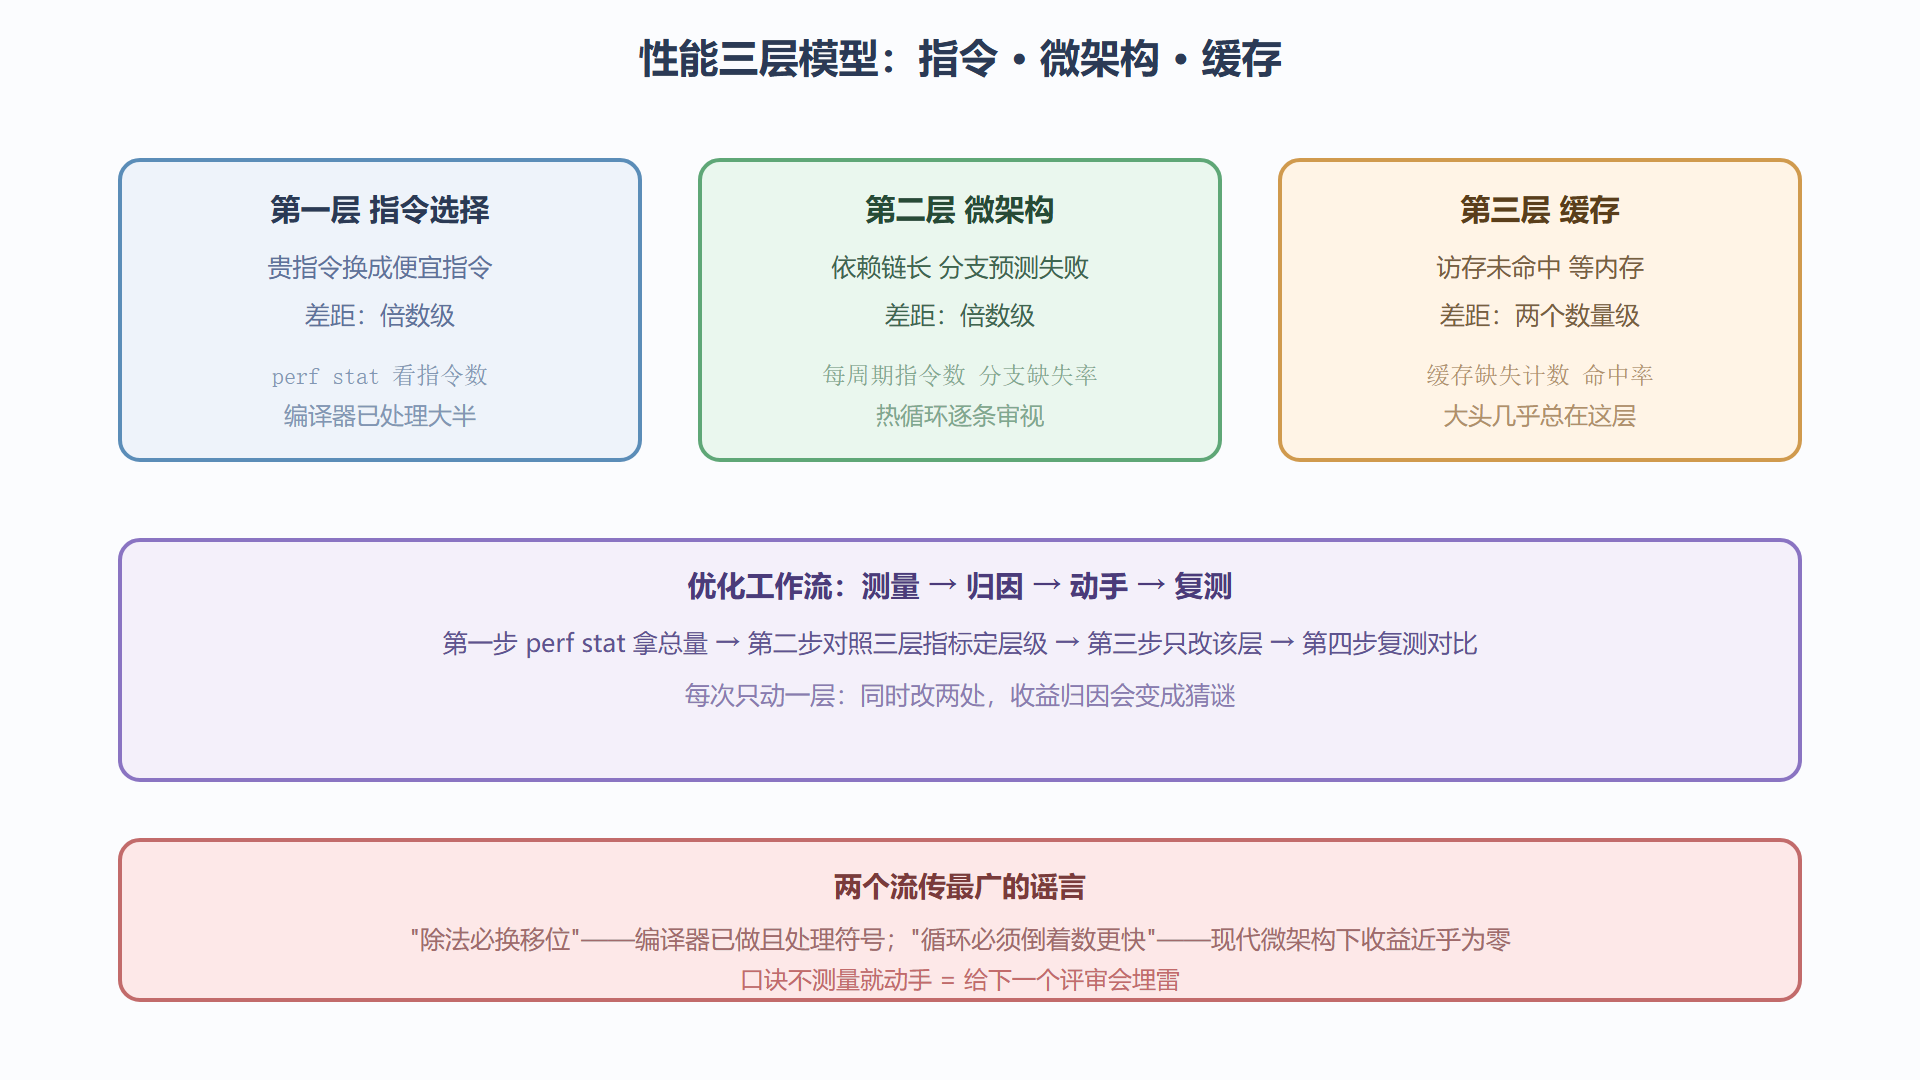
三层的关键差异在量级与可预测性。指令选择层的成本差距是倍数级(乘法是加法的几倍、除法又是乘法的十几倍),且大部分已被编译器处理;微架构层的差距也是倍数级,但要看具体数据流;缓存层的差距最恐怖——命中与未命中的差距是两个数量级,这也是"算法复杂度一样、常数天差地别"的最常见元凶。反过来说:如果你的代码指令数很少还慢,多半该查缓存;循环里全是简单指令还慢,多半是依赖链或分支预测。
图 6-1:三层成本模型与观察入口
完整案例:一次有据可依的优化
对象是一个真实的性能敏感任务:大数组元素平方和(浮点版)。先测量基线,再逐层归因。基线代码朴素直白:
double sumsq(const float *a, size_t n) { double s = 0.0; for (size_t i = 0; i < n; i++) s += (double)a[i] * a[i]; return s; }
测量工具与命令(Linux,perf 包):
$ perf stat -e cycles,instructions,branch-misses,cache-misses ./bench 2,418,392,104 cycles 4,012,551,022 instructions 41,207 branch-misses 918,443 cache-misses
归因:每周期指令数约 1.66——对含浮点加的标量循环不算灾难,但 cache-misses 的绝对量在数据集超过末级缓存容量的测试里显著。此时第一杠杆不是手写汇编,而是让编译器向量化:加 -O3 -march=native -ffast-math(浮点结合律允许重排后),产物变成 AVX 指令——一条 vfmadd 处理八个浮点数。复测,指令数降到约原来的八分之一,周期数降约五倍。再上第二杠杆:把数组访问从"按函数逐次完整扫描"改为"分块驻留缓存"(分块遍历),复测 cache-misses 降一个数量级,总时间再降约一倍。
整个过程的汇编观察点只有一个:objdump 确认产物里出现了 vfmadd231ps 与向量寄存器(xmm 或 ymm)。注意我们做了什么——没有手写一条汇编,但每一步决策都以汇编产物与计数器数据为依据。这就是当代性能工程的常态:汇编知识的作用不是让你写,而是让你看懂编译器交的稿与硬件给的账。
微架构层的两个实用观察
向量化之外的常见瓶颈,用两个具体机制说明"为什么改写有效"。其一,依赖链:s = s * a + b 的循环里,下一次乘法要等上一次的结果,浮点乘加的延迟约四周期,吞吐被延迟卡死。对策是多个累加器轮转(把 s 拆成 s0 到 s3 各自累加,最后合并),依赖链变四条并行,吞吐接近翻四倍——编译器在 -O3 加 -ffast-math 下会自动做这件事,产物里看到四个 xmm 各自累加即是。其二,分支预测:3.2 节的条件跳转在微架构层有代价——预测失败要清流水线,代价十几周期。数据无序时把 if (a[i] > 0) s += a[i]; 改成无分支形式(max 或乘掩码),实测常有一倍以上收益;产物里"看不到 je 而看到 cmov 或 and"即是编译器替你做了这个决定。
⚠️ 常见坑:把微基准的结论直接搬到生产数据。同一份代码,数据驻留缓存与穿越内存的性能可以差五倍,分支命中率的差异能吞掉任何指令级优化。优化结论必须在与生产同规模、同分布的数据上复测,微基准只用于机制验证。
💡 关键直觉:性能优化的对象是"资源的等待时间",不是"指令的多少"。缓存层的等待以百周期计,微架构的以十周期计,指令层以个位数计——先把大的等完,再抠小的,顺序反了就是白干。
收尾前再交一个工程实践的底:优化记录怎么留。三层模型加四步工作流,天然对应一份可复查的优化档案——每次动手前记下基线数据(cycles、每周期指令数、缓存缺失),动手后记下复测数据与改动内容。它的价值在两个月后:当有人问"这里为什么这么写",或者下一位维护者想"简化"掉那个分块循环时,档案就是唯一能证明"这个怪形状买到了多少性能"的东西。没有档案的优化在代码评审里活不过两个回合——不是改动不对,而是成本收益的账没人记得。顺带一提,这份档案的格式随便,但必须包含汇编产物的关键片段:它是改动与收益之间因果链的物证,仅凭源码 diff 说不出"为什么快了"。
本节要点回顾
- 三层成本模型:指令选择、微架构、缓存,量级分别为个位数、十级、百级周期,先量大后量小。
- 工作流四步:测量、归因、单层动手、复测——每次只动一层,结论才可归因。
- 第一杠杆是编译器:-O3 加向量化、分块与无分支改写,多数收益无需手写一条汇编。
- 两个谣言:除法换移位、倒序循环更快,都属于不测量的口诀优化。
性能现场的工具是计数器,故障现场的工具是调试器。下一节进入指令粒度的调试工作流,顺便拆穿断点的魔术。