1.1 洛伦兹1961年数值事故复盘
1.1 洛伦兹1961年数值事故复盘
本节摘要:敏感依赖初始条件的第一次现场记录,来自一次纯粹的实验室意外——洛伦兹为了省事,用截断后的中间数据重启天气模拟,结果轨迹与原来彻底分道扬镳。本节复盘这次事故的完整过程:他截断了什么、两次运行的差异有多小、分离用了多长时间、翻倍时间如何估计,以及这次事故为何构成对"测量更准就能预测更远"的直接反驳。
上一章地图里我们把本章定位为"看见混沌"的起点,而看见混沌的具体地点,就是本节要复盘的这间实验室。后面的章节会反复用到从这里得到的直觉:第 3.3 节复现洛伦兹系统的完整数值实验,第 4.2 节把"分离得有多快"提炼成 Lyapunov 指数。先把事故本身看仔细。
学习目标
阅读完本节,你应当能够:
- 完整复述洛伦兹事故的起因、操作与结果,指出被截断的量及其精度;
- 用"误差翻倍时间"的语言描述轨迹分离的速度,并说明它与预报时限的关系;
- 解释为什么这次事故不是计算失误,而是系统性质的暴露;
- 动手用一个最小数值实验重演"小数点后几位之差导向截然不同的轨迹"。
一、事故现场:为了省事的一次重启
先把背景交代足。二十世纪五十年代末,洛伦兹在麻省理工学院做的是一件听起来很保守的工作:用微分方程组模拟大气加热与流动,看对流怎么发展。他当时用的模型并不复杂——后来以他名字命名的三变量方程组正是在这类工作里提炼出来的——但在 1961 年那次运行时,用的还是一个十二变量的简化大气模型。所谓模拟,就是让机器按固定步长一步一步往前推:给出当前时刻的大气状态,算出下一时刻的状态,循环往复,最后把某个量的变化曲线打印在纸上。
事故的起因是一次典型的"想偷懒"。洛伦兹想仔细看一段已经算过的天气过程的细节。完整重跑太慢,他决定从中间某处接着算:找出打印纸上那一行的状态数值,敲进机器,让它从那里继续往前推。按当时所有人的预期,这是安全的——从几乎相同的状态出发,模拟应当沿着几乎相同的轨道走下去,新算的段落会和旧结果严丝合缝地接上。
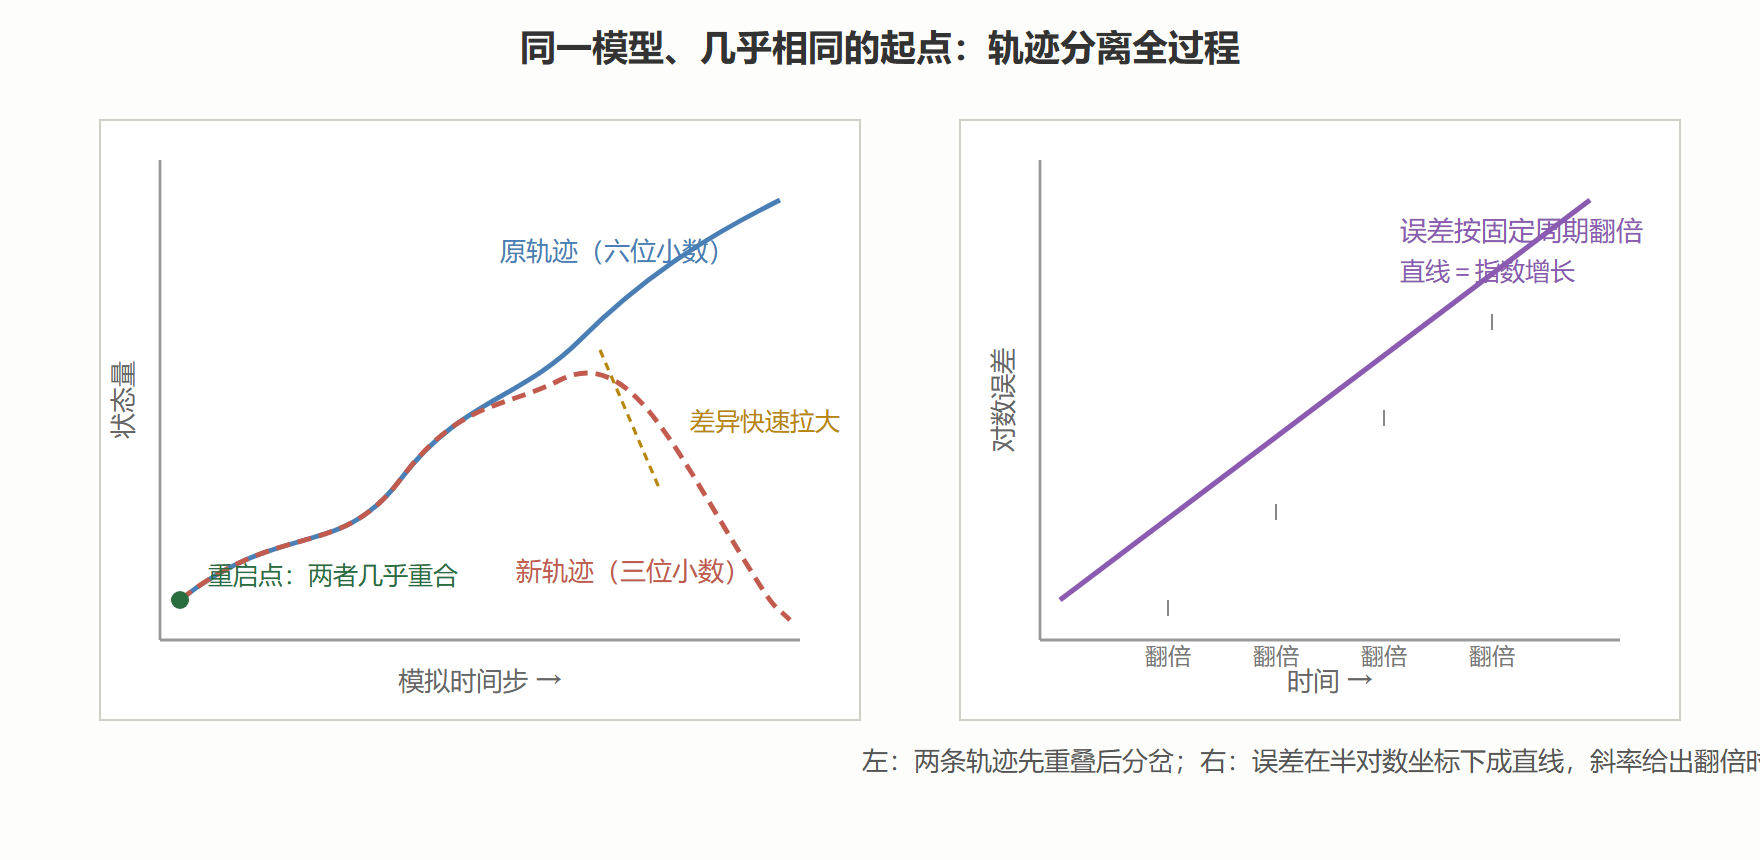
他敲进去的数,是打印纸上的三位小数。而机器内部运算用的是六位小数。那被丢掉的后三位,量级在千分之一上下——比任何仪器能测出的大气差异都小得多。如果他当时知道后来的结果,大概会把六位数老老实实敲完。
二、操作复盘:两次运行怎么分开的
洛伦兹等待机器跑完去喝了一杯咖啡,回来看到的是意料之外的画面:新轨迹并没有贴着旧轨迹走。起初两者还难以分辨,但差异每过一段固定的时间就大约翻一倍,逐渐从最后一两位数字蔓延到首位数字,最终两条曲线截然分开——新轨迹里的天气走向了与旧轨迹完全不同的状态,一个原本预期的稳定格局变成了另一种振荡。截断量级为千分之一,后果却是整体命运的改变。
把这件事翻译成数值语言,就是一条指数增长的误差曲线:初始误差 δ₀ 经过时间 t 后变成 δ₀ 乘以二的 t 除以 τ 次方,其中 τ 就是"翻倍时间"。洛伦兹从打印结果里估出这个模型的翻倍时间大约相当于四天的真实天气演化。这个数字的杀伤力在于它的乘法性质:预报八天需要初始精度提高一档,预报二十天就需要再提高好几档,而想预报一个月,初始数据就必须精确到超出任何观测手段的物理极限——你永远无法把全大气的每个探空、每片云、每缕风都测到小数点后六位。
图 1-1 两次运行的分离过程示意:误差随时间指数增长
三、结果解读:这不是机器的错
事故之后最有价值的动作,是排除"计算失误"这种省事的解释。洛伦兹很快确认:机器运转正常,两次运行用的是同一个方程、同一个程序;唯一的差别是起点数值末尾那几位。换句话说,分离不是数值方法引入的人为噪声,而是这个系统对初始状态的一种固有性质——初始状态里微小到无法观测的差异,会在演化中被系统自己放大成宏观可见的不同命运。后来这个性质被命名为敏感依赖初始条件,成为混沌的第一张名片。
值得停下来想一步:放大机制为什么存在?直观版本是"自我加强的循环"。大气里温度影响流动、流动反过来改变温度的分布,每一步都在把上一步的小偏差卷进下一步;偏差一边被输送、一边被放大,像利息滚本金。只要这种正反馈占上风,误差就指数增长。第 2.2 节会把这个直觉提炼成"拉伸与折叠"的几何机制,第 4.2 节则给出测量放大率的正规办法。
还要纠正一个常见误会:敏感依赖并不意味着"结果完全乱来"。两次运行早期几乎重合,说明短期的演化依然高度规律;分道扬镳需要时间累积。所以混沌的预报观是分层的——短期可报,中期概率化,长期只能谈统计性质。现代数值天气预报的集合预报思路(第 6.1 节),正是把这套分层预报观变成了日常业务。
四、变式实验:自己把事故重演一遍
复盘的最后一步是自己动手。下面这个最小实验不需要任何气象知识,它只用一行迭代式 x 的新值等于四乘 x 乘以一减 x(这就是第三章的主角 logistic 映射,取参数四时敏感依赖最强),从两个只差千万分之一的初值出发各迭代若干步,打印两者的差:
迭代规则: x <- 4 * x * (1 - x) 初值 A = 0.2000000 初值 B = 0.2000001(仅千万分之一的差异) 步数 轨迹A 轨迹B 差值 1 0.6400000 0.6400003 3.2e-07 2 0.9216000 0.9216003 2.5e-07 3 0.2890137 0.2890152 1.5e-06 5 0.7738990 0.7739234 2.4e-05 8 0.3191887 0.1644165 1.5e-01 10 0.8673515 0.9654866 9.8e-02 12 0.4586131 0.1326825 3.3e-01
输出里能看到清晰的阶段感:前几步差值纹丝不动,随后开始爬坡,七八步之后两条轨迹已经毫无关系。这个演示和洛伦兹的咖啡间隙故事在结构上完全同构——起点之差小到任何观测都分辨不出,结局之差大到任何人都无法忽视。建议你顺手改变初值差再跑一次:把差异再缩小一百倍,分离只会推迟几步,不会缺席。这恰恰是敏感依赖的冷酷之处:提高精度买来的是时间,不是确定性。
再看一遍那张分离表的时间刻度,会有额外收获。演示里千万分之一的初值差经过七八步迭代就长大到与信号同量级,翻倍周期约两步一次;洛伦兹的原始事故里,翻倍以积分步计,一杯咖啡回来结局已换。两个系统的翻倍时间表完全不同,但“误差按固定倍数翻滚、结局提前锁定”的结构一模一样——敏感依赖关心的从来不是具体步数,而是这种可预算的增长结构,第 4.2 节会把翻倍周期提炼成标准化的指数,让不同系统的翻倍时间表可以直接比较。
数值口径上还有一个容易忽略的细节值得点破:演示故意选参数四的 logistic 映射,因为此时误差翻倍最快、演示最省步数;同样的初值差放到参数三点七的周期轨道上,会被轨道逐渐压平,演示直接失败。演示系统本身也是被挑选过的——这正是 8.1 节要展开的道理:实验设计里每一个“显然”都值得问一句为什么。
本节要点回顾
- 事故本体:用三位小数的中间值重启六位精度的模拟,轨迹在短暂重合后彻底分离,一次省事暴露了系统级性质。
- 翻倍时间:误差按固定周期翻倍,预报每多看一段未来,需要的初始精度就指数式提高,"测量更准"买不来无限预报。
- 性质归属:分离来自系统的正反馈放大机制,不是机器故障或程序错误——这正是它能推广为科学概念的原因。
- 分层预报观:短期轨道可预报、中期需概率化、长期只剩统计性质,现代气象业务就建立在这个分层上。
- 可重演性:一行迭代式即可复现事故结构,缩小初值差只会推迟分离,改变不了结局。
下一节我们回溯这道裂缝的思想史前传:在洛伦兹之前半个多世纪,庞加莱已经在一个更古老的难题里摸到了同一块暗礁。