5.1 系统发生树:家谱图的数学形态
5.1 系统发生树:家谱图的数学形态
本节摘要:系统发生树是表示物种亲缘关系的数学对象:叶子节点代表现存类群,内部分叉代表共同祖先,拓扑结构(分叉顺序)才是亲缘关系的核心。读树有严格语法——姐妹群、外群、根、单系支;而树空间存在组合爆炸,物种稍多,可能的树就多到无法穷举,这正是建树必须依赖算法搜索的根本原因。
上一节我们说第 5 章要"画谱",但"谱"到底是个什么东西,得先把它钉死。很多人以为系统发生树就是生物课本里那棵好看的树状图——远不止。它是一类有严格定义的数学对象,读它的语法错了,结论就会反过来。本节先学语法,再理解为什么"树"不能靠肉眼画。
一、树的构件与读法
一棵系统发生树由两类元素构成:节点和枝。终末节点(叶子)代表现存类群,通常是物种或物种以上的单元;内部节点代表分支事件,即某两个类群最后共同祖先的节点;根是最古老的分叉点,代表所研究全部类群的最近共同祖先;连接节点的枝代表一个谱系沿时间延续。把一个节点下分出的所有分支合起来叫一个支(clade),若它包含一个共同祖先及其全部后代,就是单系支——第 3 章讲阶元合法性时用的正是这个概念。
读树有两条铁律。第一,转一下节点,亲缘不变。一棵树的分支可以绕着内部节点旋转(把左边的分支旋到右边),它依然是同一棵树——读者不能因为画法上的左右位置而得出亲缘结论。第二,看分叉,不看距离。亲缘关系由分叉顺序决定,而不是由图上画的"相隔远近"决定。这两条铁律是新手最容易违反的,违反的后果是:在同一张图里读出完全相反的两套亲缘。
判断一组类群谁和谁最近,标准动作是找姐妹群——同一内部节点下两个直接分叉出来的分支。而确定树根的方法,是引入外群:选择一个确定在该类群之外、亲缘足够远的类群,把它一并纳入建树,树根就落在"最晚与外群分叉"的位置。没有外群的树是无根树,只能读出相对分叉顺序,读不出演化方向。
上面的图里,物种 A 与物种 B 是姐妹群(共享节点 X),物种 C 与物种 D 是姐妹群(共享节点 Y),AB 与 CD 共享更早的祖先节点;外群 O 提供了根的参照。注意:A 和 B 在图上"挨着",C 和 D 在图上"挨着",但 AB 这一组与 CD 这一组的亲缘关系,是由它们分叉的先后决定的,不是由画法决定的。
二、树空间的组合爆炸
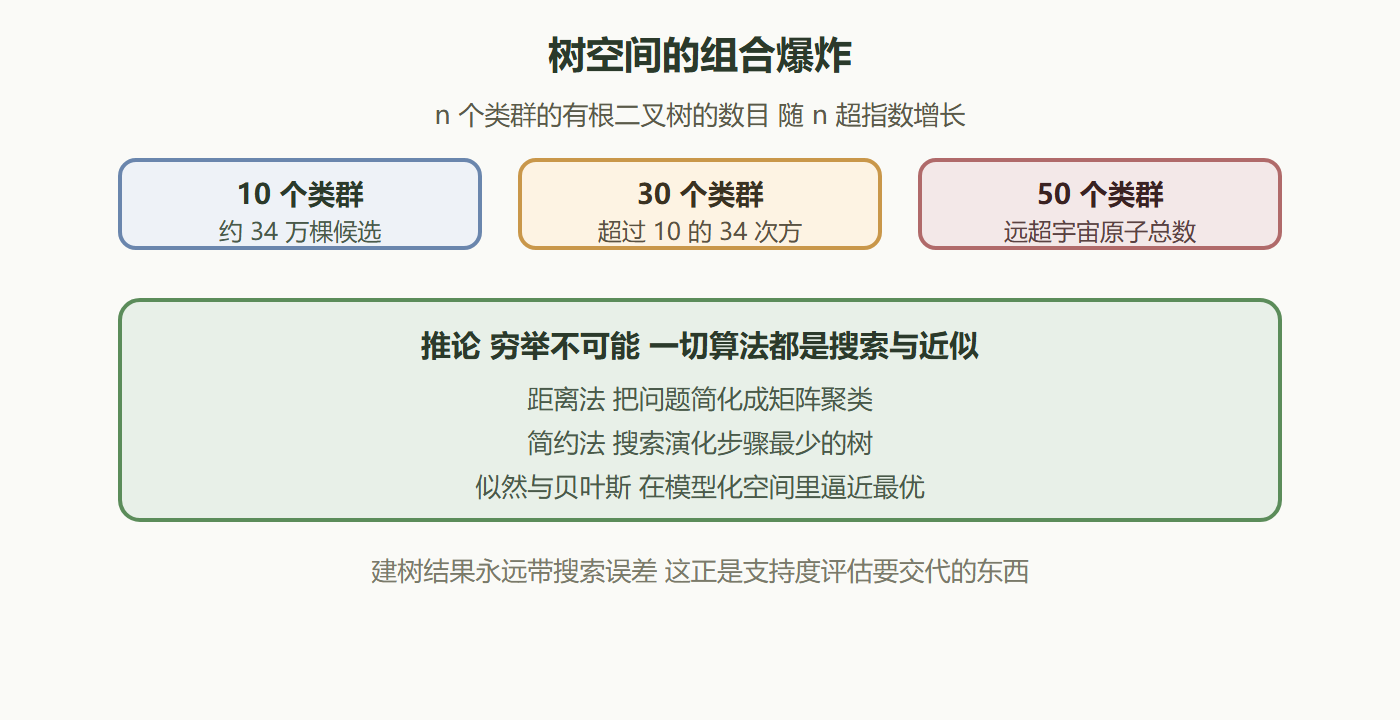
现在回答一个根本问题:为什么建树不能靠肉眼比对?因为候选树的数量大得离谱。对 n 个类群,有根二叉树的数目按公式 (2n-3)!! 增长——n 等于 10 时约 34 万棵,n 等于 30 时超过 10 的 34 次方,n 等于 50 时这个数字已经远超可观测宇宙中的原子数。生物学数据库里动辄几百个类群参与建树,穷举所有候选树在计算上完全不可能。
这个"树空间组合爆炸"是所有建树算法的出发点:没有算法能保证找到"绝对最优树",一切算法都在做"搜索与近似"。距离法把问题简化为距离矩阵上的聚类;最大简约法在树空间里搜索"演化步骤最少"的树;似然法与贝叶斯法在模型化的树空间里搜索"最可能解释数据"的树。它们的共同点是在一个巨大到无法穷举的空间里,用启发式策略逼近最优解——这意味着建树结果永远带搜索误差,这就要靠第 5.3 节的支持度评估来交代不确定性。
三、分支长度:时间、变化量与不确定性的编码
节点和拓扑之外,树还有第三个维度——枝长。枝长是元数据里的"数字",它记录的是从分支事件到终末类群之间发生的变化量。在分子树里,枝长通常代表序列的替换量;在标定过分子钟的树里,枝长可以换算成分化时间。读枝长要注意:枝长不等于"重要性",它只是变化速率的估计;短枝不代表类群不重要,可能代表演化速率慢或分化时间近。
更麻烦的是,枝长本身也带不确定性。同一个分支事件,在不同模型设定下算出的枝长可能差出几倍;化石标定点的年代误差、分子钟模型的松弛程度,都会沿着枝长传导到分化时间估计上。所以严谨的论文会给枝长画置信区间,或者用"节点高度分布"表示不确定性。第 5.3 节会把这些不确定性系统化——本节先立起这个意识:树的每一根枝都不是钢笔画的,是统计估出来的。
四、树的边界:为什么说"树"是一种必要的隐喻
第 2 章结尾留下过一个问题:生命之树是不是已经被"网状演化"动摇了?本节给一个清醒的答案。水平基因转移(细菌间交换基因像握手一样常见)、杂交渐渗(熊科、桦木科、甚至人类祖先谱系都有记录)、多倍化事件(植物里频繁触发瞬时物种形成),这些过程都让"严格分叉的树"无法完整描述生命关系——部分谱系的关系更像网,不是树。但这是否意味着系统发生树作废?不是。树仍然是绝大多数亲缘关系的良好近似,是唯一可计算、可检验的框架;网状过程是树框架之上的修正项,而不是替代品。分类实践里的处理是:对已知存在广泛杂交的类群,用"网状网络"模型补充;对绝大多数类群,树照建不误,只是要在方法部分交代"本类群已知或疑似的网状演化风险"。这正是一种工程取舍:先保证可计算,再逐步逼近真实。
五、回到本案:LN-2026-0717 要建什么样的树
把语法落到案子上。LN-2026-0717 的建树设计应该是:叶节点 = 它自己 + 同属与近缘属的代表种(每个已知种至少一个个体);外群 = 选定一个确定的近缘属(通常是与该属最近的姐妹属)作为根参照;建树数据 = COI 加一到两个核基因的联合矩阵(避免单基因独裁,第 4 章讲过);输出 = 一棵带支持度的树,重点看 LN-2026-0717 落在哪个支上、它的姐妹群是谁、支持度多高。这三个问题答清楚,"它归谁家"就有了数据支撑。至于选什么算法、怎么评估支持度,是接下来两节的事。
本节要点回顾
- 树 = 节点 + 枝,拓扑(分叉顺序)是亲缘核心,枝长是时间与变化量;
- 读树两铁律:节点可旋转亲缘不变,亲缘看分叉不看图上距离;
- 外群定根:没有外群只能读相对分叉顺序;
- 树空间组合爆炸:穷举不可能,一切算法都是搜索与近似;
- 枝长是统计估计,带不确定性;树是良好近似加网状修正项。
下一站进车间——把第 4 章收集的性状与序列,编码成建树要用的数据矩阵。