5.3 支持度:证据有多硬
5.3 支持度:证据有多硬
本节摘要:支持度评估回答"这棵树的结论有多可信"。自展值靠重复抽样测"结论重现率",后验概率靠模型测"结论可信度",两者统计含义不同、适用范围不同。支持度高不等于结论真——系统性错误(同源位点偏差、模型设定失误、采样偏倚)能制造看似坚硬的高支持度。读懂数字,更要读懂数字是怎么来的。
上一节我们把矩阵编好了,算法跑完,输出一棵带数字的树。现在到了最考验判断力的环节:这些数字——自展值 95%、后验概率 0.99——到底在说什么?很多人把它们当"正确率"读,这一节先把这个误读纠过来,再教你怎么在三种硬度计量之间做选择。
一、自展值:结论的重现率
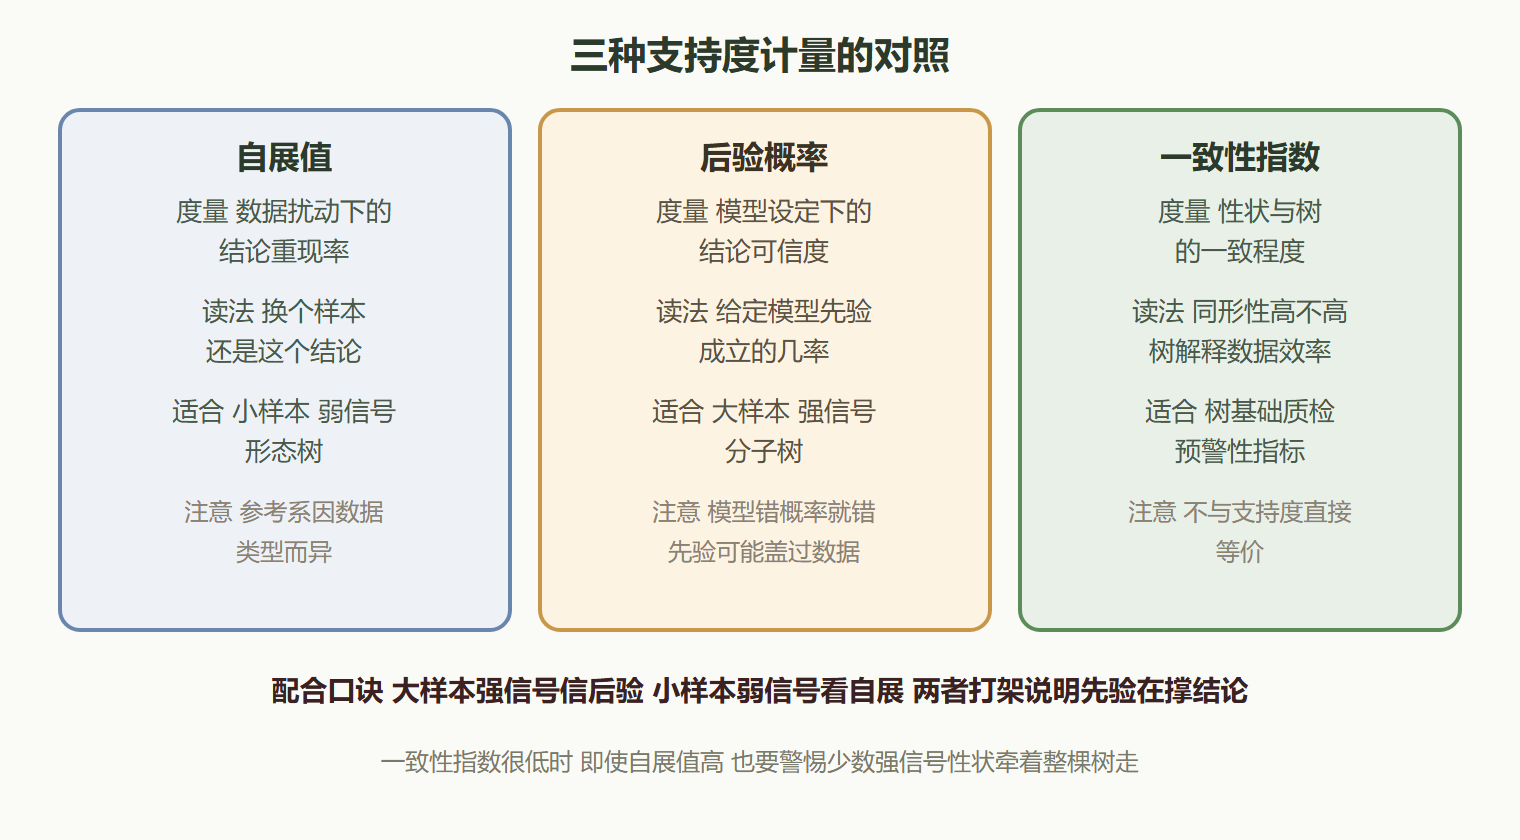
自展法(bootstrap)的思路朴素得近乎粗暴:把原始数据矩阵当"母体",随机重抽样出大量新矩阵(每列重新抽,可重复),对每个重抽样矩阵重跑一遍建树,然后数"某个分支在多少次重抽样里重现"。重现比例就是自展值。比如自展值 95,意思是:在随机重抽样的一百份数据里,这个分支在九十五份里都建出来了。
注意它度量的是什么:不是"这个分支为真的概率",而是"这个分支在数据扰动下的稳定性"。数据稍有扰动结论就变,自展值就低;数据再怎么扰动结论都不变,自展值就高。这层区别极其重要——自展值高说明"换个样本还是这个结论",但它不能说明"结论本身符合演化现实"。一个常见的误读是把自展值 95 当成"百分之九十五正确",那是把频率统计读成了概率判断。
自展值的另一个坑是它的参考系:自展值在形态树和分子树之间没有统一标尺。形态数据性状少、信息弱,分支自展值普遍偏低;分子数据位点多、信息强,自展值普遍偏高。所以"自展值大于七十就算硬"这种江湖规则,换数据类型就得重新校准。比较靠谱的用法是看相对值:同一棵树里,哪些分支的自展值明显高于邻居,那些分支才是"数据支撑更稳"的。
二、后验概率:模型下的可信度
贝叶斯法走另一条路。它先给演化过程一个模型(核苷酸替换模型、分子钟、树先验),再算"在数据与模型下,这棵树的概率"。每个分支的后验概率就是"给定这一切,这个分支成立的概率"。后验概率 0.99 的直观读法确实是"极大概率",但它的前提条件必须说全:给定模型设定与先验选择。模型错了,0.99 也就错了。
贝叶斯的软肋在"先验"。树先验(比如假定物种形成速率恒定)、分子钟先验(严格钟还是松弛钟)、替换模型先验(GTR 还是更简模型),每个先验都是一张"我们相信什么"的牌。样本量小、信号弱的时候,先验的作用会盖过数据;快速辐射类群尤其危险——分化事件挤在很短时间内,数据几乎不携带分叉顺序的信息,后验概率会主要由先验决定,而研究者往往不知道这一点。
三、两种计量怎么配合
实务里的配合口诀是:大样本、强信号的分子树,后验概率可信;小样本、弱信号或形态树,自展值更稳。更深一层:两者并不总一致,不一致本身就是信息——如果一个分支自展值 60% 而后验 0.99,说明数据对分叉顺序没把握,是模型的先验在"撑着"这个结论;这种分支必须降级对待,不能因为有一个漂亮数字就当成定论。
第三类计量是约简一致性指数(如 CI、RI),它度量"性状与树的一致程度":一致性低说明大量性状在树上反复"走回头路"(同形性高),这棵树解释数据的效率差。它不直接度量支持度,但能预警树的基础是否扎实——CI 很低的树,即使自展值高,也要警惕是不是恰好被少数几个"强信号"性状牵着走。
四、假高支持度:数字漂亮,结论是错的
支持度最大的陷阱不是数字低,而是"假高"——系统性错误制造的看似坚硬的高支持度。四种常见来源:
同源位点偏差:全基因组里选了受同一选择压影响的位点群,等于把同一个信号重复了一万遍,自展值当然"稳定",但稳定的是错误。模型设定失误:用了过简的替换模型,无法容纳真实的演化速率差异,算法把"模型没解释的部分"硬塞进某个分支,制造高后验。采样偏倚:外群选错(选了个近缘的当外群),整棵树的根摆错位置,支持度依然可以很高。平行演化的位点:快速辐射类群里,趋同位点在亲缘近的物种间"共享"得更频繁,让算法误以为它们同源,制造出坚挺的假分支。
识别假高支持度的方法论,其实在第 4 章就埋下了:交叉验证。同一数据用不同算法建树、用不同模型设定重跑、把有争议的位点删掉重跑,看结论动不动。结论越稳,支持度越可信;一换设定就翻案,那再高的数字也只是纸糊的。这也是为什么严谨的系统发生论文会同时报告多种方法的结果——不是形式主义,是防假高。
五、完整案例:被"漂亮数字"带偏的一次定案
背景:某团队重建一组濒危蛙类的亲缘,单线粒体矩阵建树,所有关键分支自展值都超过九十,论文顺利发表,还把其中一个分支拆成了新属。操作:另一团队复核时用核基因组重跑,发现线粒体树上的"新属"根本不存在——蛙类中线粒体基因存在线粒体渗入(近缘种杂交后,母系线粒体被"借"过来,让物种甲的线粒体树与物种乙混在一起)。结果:新属被撤销,原论文撤稿,两家团队陷入长达数年的争论。解读:这个案例是"假高支持度"的标准教科书——单基因、强信号、高自展值,每一步都"合规",却因为线粒体渗入这个系统性偏差全盘皆错。教训有三条:单基因树永远只当假说;线粒体在近缘种里存在杂交污染风险;支持度再高也要经得起"换数据源重验"的考验。变式:LN-2026-0717 的建树若只测 COI(线粒体基因),就暴露在同样的风险下——这正是第 4 章证据计划里坚持"COI 加核基因"的原因。
六、回到本案:怎么给 LN-2026-0717 的支持度把关
给本案列一份"质检清单":第一,多基因联合建树,COI 与核基因分别建树再对照,防线粒体渗入;第二,至少用两种算法(似然法与贝叶斯法)交叉,看拓扑是否一致;第三,报告支持度时同时给自展值与后验概率,不一致的节点标注为"存疑节点";第四,把一致性指数低、同形性高的位点做敏感性分析——删掉重跑,看关键分支动不动。这四条做完,LN-2026-0717 的"归谁家"结论才算过得了关。
本节要点回顾
- 自展值测结论重现率,后验概率测模型下可信度,两者都不是"正确率";
- 配合口诀:大样本强信号信后验,小样本弱信号看自展,打架说明先验在撑;
- 一致性指数预警树的基础质量,CI 低时高支持度要打问号;
- 假高支持度四大来源:同源位点偏差、模型失误、采样偏倚、平行位点;
- 防假高的唯一办法是交叉验证:换算法、换模型、删位点,结论不动才算数;
- 本案质检四步:多基因对照、双算法交叉、双指标报告、敏感性分析。
树画好了,支持度也验过了。第 6 章拿着这棵树回到最初的问题——LN-2026-0717 到底算不算一个物种。