3.1 分子演化引擎
3.1 分子演化引擎
本节摘要:分子演化引擎是病毒在复制过程中制造、整合并筛选遗传变异的一整套机制,核心部件包括突变、重组与选择压力。它的转速由复制酶的校对能力决定:RNA 病毒缺乏校对,突变率比 DNA 病毒高出好几个数量级,于是在宿主体内形成一团不断漂移的变异云,也就是准种。这台引擎既给了病毒快速适应的能力,也把病毒推到"错误灾难"的悬崖边——突变太多,整个种群就会崩掉。看懂引擎,等于拿到了理解流感年年换疫苗、HIV 快速耐药的一把钥匙。
本节导读
阅读完本节,你应当能够:
- 说出 RNA 病毒与 DNA 病毒突变率差异背后的分子原因。
- 解释"准种"是什么,以及它为什么比"单一病毒序列"更能反映真实感染。
- 区分突变、重组与重配三种变异来源。
- 说明误差阈值与错误灾难的含义,并各举一种诱变抗病毒的思路。
一、问题与直觉:为什么流感疫苗年年要换
每年秋天去打流感疫苗,我们都会被提醒:今年用的是新配方。同一种病毒,怎么就跟去年不一样了?答案不在免疫系统,而在病毒自己的复制机器上。流感是 RNA 病毒,它的复制酶做事马虎,一边抄遗传信息一边出错。抄一遍错几个字母,抄一百遍,就抄出了一整个变异家族。
我把这种出错的能力比作一台发动机。发动机转速越高,车跑得越快,但抖动和翻车的风险也越大。病毒复制酶的保真度,就是这台发动机的转速调节器。保真度低的病毒,转速高,变化快,能迅速甩开免疫系统的追击;可一旦油门踩过头,发动机自己就散了架。这一节我们要拆的就是这台发动机:它由哪些零件组成,转速怎么调,什么时候该踩刹车。
二、突变率:发动机的转速
先看最基础的零件——突变。病毒复制一次基因组,平均会引入多少个错误,就是它的突变率。这个数字在不同病毒之间差得惊人。
RNA 病毒几乎站在高转速的一头。它们的 RNA 依赖 RNA 聚合酶没有校对功能,抄错了也不回头改。流感、新冠、登革病毒,突变率大约在每碱基每代十万分之一到千分之一的量级。这个数字看起来不大,但病毒基因组只有几万到十几万个碱基,复制一代往往就带上几个新错误;再加上一个感染者体内能复制出天文数字的病毒粒子,两个数一乘,就是一个庞大的突变库。
DNA 病毒站在另一头。它们的 DNA 聚合酶带着校对和错配修复两道保险,突变率低到每碱基每代十亿分之一左右。疱疹病毒、腺病毒走的就是这条路:基因组稳定,代价是适应速度慢。一个直观的后果是,天花病毒在人类中稳定传播了几千年,最后因为几乎没有变异空间,被疫苗一次性根除。
逆转录病毒夹在中间偏快的位置。HIV 的反转录酶同样不校对,而且它要经过"RNA 到 DNA 再到 RNA"两步,突变率比纯 RNA 病毒还高一点。这正是它难以被单一药物长期压制的根源。
下表把三类病毒并排放在一起,转速差一眼就能看出来:
| 病毒类型 | 代表成员 | 复制酶校对能力 | 突变率量级 | 演化后果 |
|---|---|---|---|---|
| RNA 病毒 | 流感、新冠、登革 | 无校对 | 每碱基每代约十万分之一到千分之一 | 变化快,易逃逸,也易逼近崩溃 |
| 逆转录病毒 | HIV | 反转录无校对 | 与 RNA 病毒相当或更高 | 准种极多样,耐药速度快 |
| DNA 病毒 | 疱疹、腺病毒、痘病毒 | 有校对与错配修复 | 每碱基每代约十亿分之一 | 基因组稳定,适应慢 |
⚠️ 常见坑:别把"突变率高"直接等同于"进化一定快"。突变率再高,如果产生的大多是有害错误,反而会拖累整个种群。转速和生存之间有一条临界线,就是我们下面要讲的误差阈值。
三、准种:不是一支军队,是一团云
教科书常把一种病毒画成一个固定的颗粒,但真实感染远不是这样。在一个人体内复制出来的病毒,是一团高度相似又不完全相同的变异体。分子演化里把这团东西叫准种(quasispecies)。
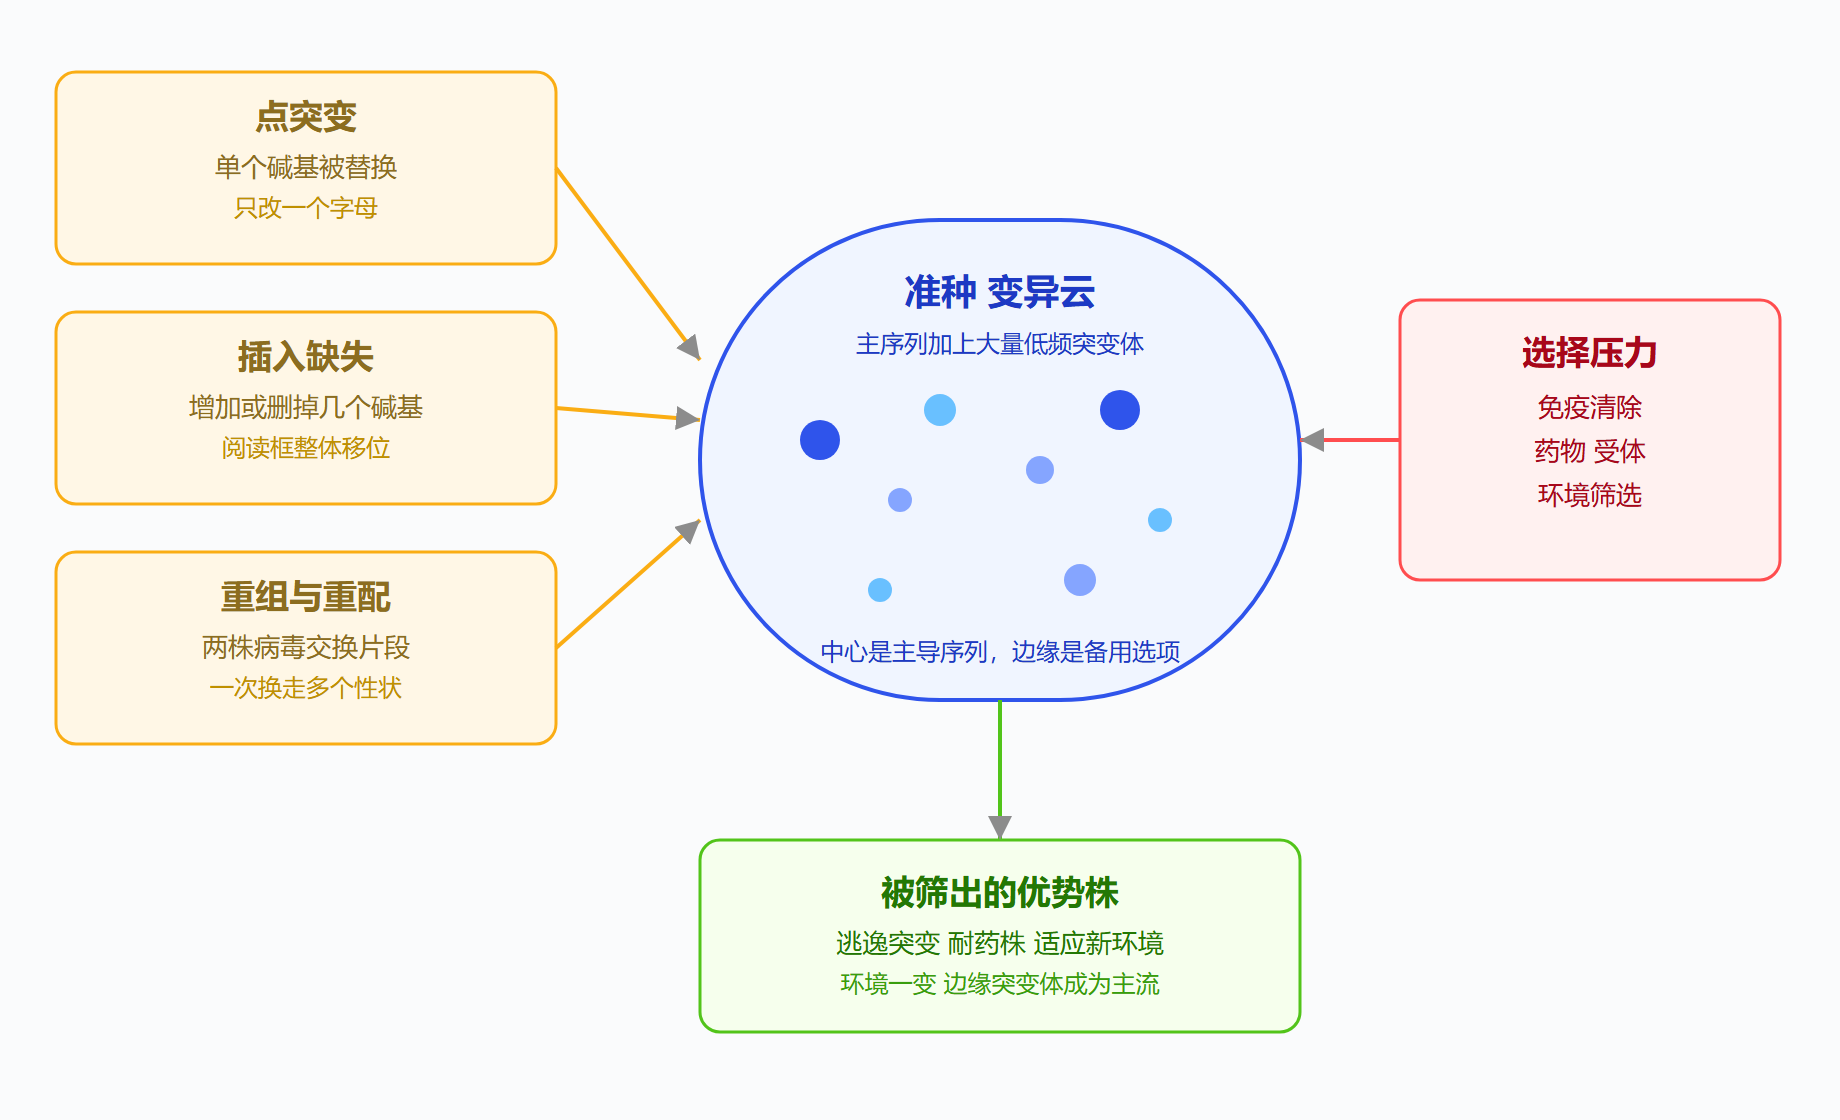
准种这个词值得多花一句。它不是说病毒有"种",而是说一个病毒群体像一个由主序列加上大量突变体组成的云。云的中心是那条最常见的序列,边缘是各种低频突变体。为什么这个概念重要?因为选择压力作用的对象不是单条序列,而是整团云。某个突变体今天只占万分之一,明天环境一变——比如病人开始吃药——它可能一夜之间变成主流。
可以拿股市做个类比。准种就像一只股票在一段时间内的价格分布:多数时候在某个价位附近波动,偶尔有几笔偏离很远。一旦大盘环境变了,那些原本边缘的价格反而可能成为新常态。病毒群体也一样,永远保留着一批"备用选项",等着环境翻牌。
准种的存在,让"单个突变决定成败"的说法站不住脚。一个抗药突变是否出现,取决于突变库里有没有这个备胎;一个逃逸突变能不能扩散,取决于它在当前选择压力下有没有优势。下一节的宿主适应、再下一节的跨种跃迁,本质上都是这团云被环境筛出来的结果。
四、重组与重配:发动机的改装件
突变是"一个字一个字地改",重组和重配则是"整段整段地换"。当两株亲缘病毒同时感染一个细胞,它们的遗传物质可以互相交换,一次产出全新的组合。这相当于给发动机做了一次大改装。
同源重组发生在序列相似的区域之间。复制酶在一条模板上抄着抄着,跳到另一条模板上,把两段拼成一段。冠状病毒是这方面的好手,它的基因组里有若干个容易发生交换的热点区。
重配是分节段病毒的独门绝活。流感病毒的基因组分成八个片段,两株病毒共感染同一个细胞时,八个片段像八张牌一样重新洗牌发牌。1957 年和 1968 年的两次流感大流行,都源于禽流感与人类流感的重配,各换走了一两个关键片段,让原本只在禽类里传的病毒突然能在人之间传播。
重组和重配的杀伤力在于,它们能在一次事件里同时改变多个性状。突变要一步步爬,重组可以直接换装。这也是为什么我们监测流感时,最警惕的不是单个点突变,而是"禽源片段"和"人源片段"的意外组合。
五、错误灾难:油门踩过头的后果
回到那台发动机。突变率不是越高越好,它上面悬着一把剑,叫误差阈值。
原理很简单。一个病毒的基因组长度是固定的,它能承受的有害突变数量是有限的。如果每个复制周期引入的错误超过某个临界值,那么后代里几乎每个个体都带着致命错误,种群的"平均健康度"会被拖垮,最后整团灭掉。这种现象叫错误灾难。
这条阈值线给抗病毒药物提供了一个巧妙思路:与其直接杀死病毒,不如往它的发动机里掺沙,把突变率抬过阈值。利巴韦林、莫洛匹拉韦这类诱变剂走的就是这条路。它们在复制时冒充核苷酸混进去,让错误成倍增加,把病毒种群逼向崩溃。
💡 关键直觉:诱变剂不是在"杀"某个病毒,而是在"淹"整团准种。单个病毒可能侥幸没事,但整团变异云一旦被错误淹没,就再也爬不起来。这是理解诱变疗法的核心。
不过这条路也有代价。诱变剂同时会作用于宿主的核酸合成,副作用不低;而且病毒如果恰好把突变率控制在阈值边缘,反而可能借机产生更多逃逸突变。因此诱变剂通常只用于特定场景,而不是一线首选的万金油。
图注:同一台引擎的两条出路——错误适中时供养准种、推动适应,错误过多时越过阈值、走向崩溃。
图:突变类型与演化驱动力示意
六、工程实践要点:怎么用这台引擎
理解引擎,最终要落到"怎么用"上。我把实践里的取舍归纳成三点。
第一,监测要盯准种,而不是盯单条序列。临床测序如果只报一条"共识序列",会把低频的耐药突变藏起来。真正有意义的做法是看突变云的组成变化,尤其是抗药突变在群体里的占比趋势。一个突变从千分之一爬到十分之一的过程,往往比它最终占据主流更值得预警。
第二,联合用药比单药更稳。单一药物只给病毒留一条逃逸路,突变库里只要有对应备胎,耐药株很快冒头。几种药一起上,等于同时堵住几条路,病毒要同时拿到多个突变才能逃脱,概率上低了一个数量级。这是 HIV 三联疗法的底层逻辑。
第三,警惕重组带来的"跳跃"。点突变是渐变,重组是跃变。监测系统如果只盯着已知突变位点,会漏掉重组产生的新组合。对流感和冠状病毒,把"片段来源"和"重组断点"纳入常规监控,比单纯报突变位点更能提前发现危险。
⚠️ 常见坑:用诱变剂时要看剂量窗口。剂量太低,等于给病毒喂了一剂"进化加速剂";剂量过高,宿主细胞也受不了。这类药物的治疗窗口很窄,必须在"能压垮病毒"和"不伤自己"之间精确卡位。
要点速记
- 突变率由复制酶校对能力决定:RNA 病毒无校对、转速高,DNA 病毒有校对与错配修复、转速低。
- 准种是真实感染的基本形态:一群高度相似又互不相同的变异体,选择压力作用在整团云上。
- 重组与重配是"换大件":一次交换多个性状,是流感大流行的重要来源。
- 误差阈值是病毒的生死线:突变超过临界值,种群平均健康度崩溃,走向错误灾难。
- 诱变剂借阈值杀毒:把突变率抬过临界点,让准种被错误淹没。
- 监测与实践要盯准种、用联合用药、防重组跃变:这是把引擎知识转化为防控能力的三个抓手。
分子引擎解决的是"变异从哪来、能走多快"的问题。但变异只是原料,原料要变成真正的适应优势,还得看宿主环境怎么筛选。下一节,我们跟着这团准种进入宿主体内,看免疫系统与受体如何一票一票地把病毒"选"出来。