6.1 合成病毒学与功能解码
6.1 合成病毒学与功能解码
本节摘要:合成病毒学是把病毒基因组当作可设计、可合成、可组装的"工程图纸",从头构建或改造病毒,再用功能解码把基因序列和生物学表型一一对上号。它和传统病毒学的区别在于:传统是"观察病毒猜功能",这里是"造一个病毒验证功能"。核心手段有两条路——从头化学合成整段基因组,以及反向遗传学从互补 DNA 拯救病毒;主要用途是把病毒改造成基因递送工具、疫苗载体和治疗平台。读完本节,你能分清这两条路线,也能看懂"合成"和"解码"怎么互相喂数据。
本节导读
阅读完本节,你应当能够:
- 说清合成病毒学和传统病毒学在研究思路上差在哪里。
- 区分"从头合成"与"反向遗传学"两条路线,判断各自适合什么场景。
- 解释为什么"功能解码"必须回到实验,而不能只靠序列比对。
- 举例说明病毒怎样被改造成基因递送工具、疫苗载体和治疗平台。
- 说出合成病毒学在成本、安全上要付出的代价。
一、为什么要把病毒"造"出来
传统病毒学研究功能,靠的是一个字:等。等自然变异冒出来,或者用药、用辐射逼出突变,再看表型变了没有。这条路慢,而且绕——你看到的是一个已经组装好的成品在出错,却很难确定到底是哪个零件出的问题。合成病毒学的想法很直接:既然隔着成品猜结构费劲,不如自己动手造一个。
打个比方。传统做法像站在一间运转中的工厂外头,透过玻璃猜哪条生产线负责哪道工序。合成病毒学则直接走进工厂,把某个车间的电闸拉下来,看整条产线哪里停了。车间就是基因,电闸就是定点改造。你想验证"VP40 蛋白决定病毒颗粒组装",就造一个 VP40 被改动或删掉的病毒,看看组装是不是真的卡住。看到了卡住,结论才扎实。
这背后还有一层更现实的动机:造病毒的能力,本身就是造疫苗、造药物载体的能力。同一个"照着图纸造病毒"的技术,既能用来回答基础问题,也能用来生产治疗工具。这也是这一节名字叫"合成病毒学与功能解码"的原因——合成是手段,解码是目的,两者合起来才是一条从基因到功能的完整通路。
二、两条路线:从头合成与反向遗传学
要把一段病毒基因组"造"出来,工程上有两条成熟路线:从头化学合成,以及反向遗传学。两条路的起点都是序列,终点都是能复制的活病毒,中间走的工序不一样。
从头化学合成
这条路把病毒基因组当成一张长长的"零件清单",交给 DNA 合成仪一段段地造。现在单段合成能做几百个碱基,长基因组就拆成很多段,再像拼积木一样接起来。马尔堡病毒这种约 19 千碱基的基因组,就是拆成几段分别合成、再组装起来的。
从头合成的最大好处是不依赖天然样本。你手上只要有序列,哪怕原始毒株早已销毁、只剩数据库里的一串字母,也能在实验室把它重新搭出来。这对研究已经灭绝或高度受限的病毒尤其有用。代价也很清楚:序列越长,合成和拼接出错的机会越多,成本越高。所以长基因组往往要分层组装——先做几个中等大小的模块,各自验证没问题,再拼成全长。这有点像盖楼,先浇好每一层的预制件,再吊装拼接,而不是一口气从地基浇到顶。
反向遗传学
RNA 病毒的直接材料是 RNA,但 RNA 既不稳定又不好改。反向遗传学绕了个弯:先把病毒 RNA 基因组反转录成互补 DNA 抄本,在 DNA 层面随便改,改完再转录回 RNA,转染进细胞里"救"出一个活病毒。因为这条路是"从 DNA 抄本反向重建病毒",所以叫反向遗传学。
反向遗传学的优势是改动精准,可以逐个碱基地试。你想知道某个氨基酸是不是关键,就在 DNA 抄本上把它换掉,再救病毒看效果。它和从头合成并不冲突,经常配合着用:从头合成负责把大块基因组搭出来,反向遗传学负责在上面做精细改动。前者管"从无到有",后者管"从有到精"。
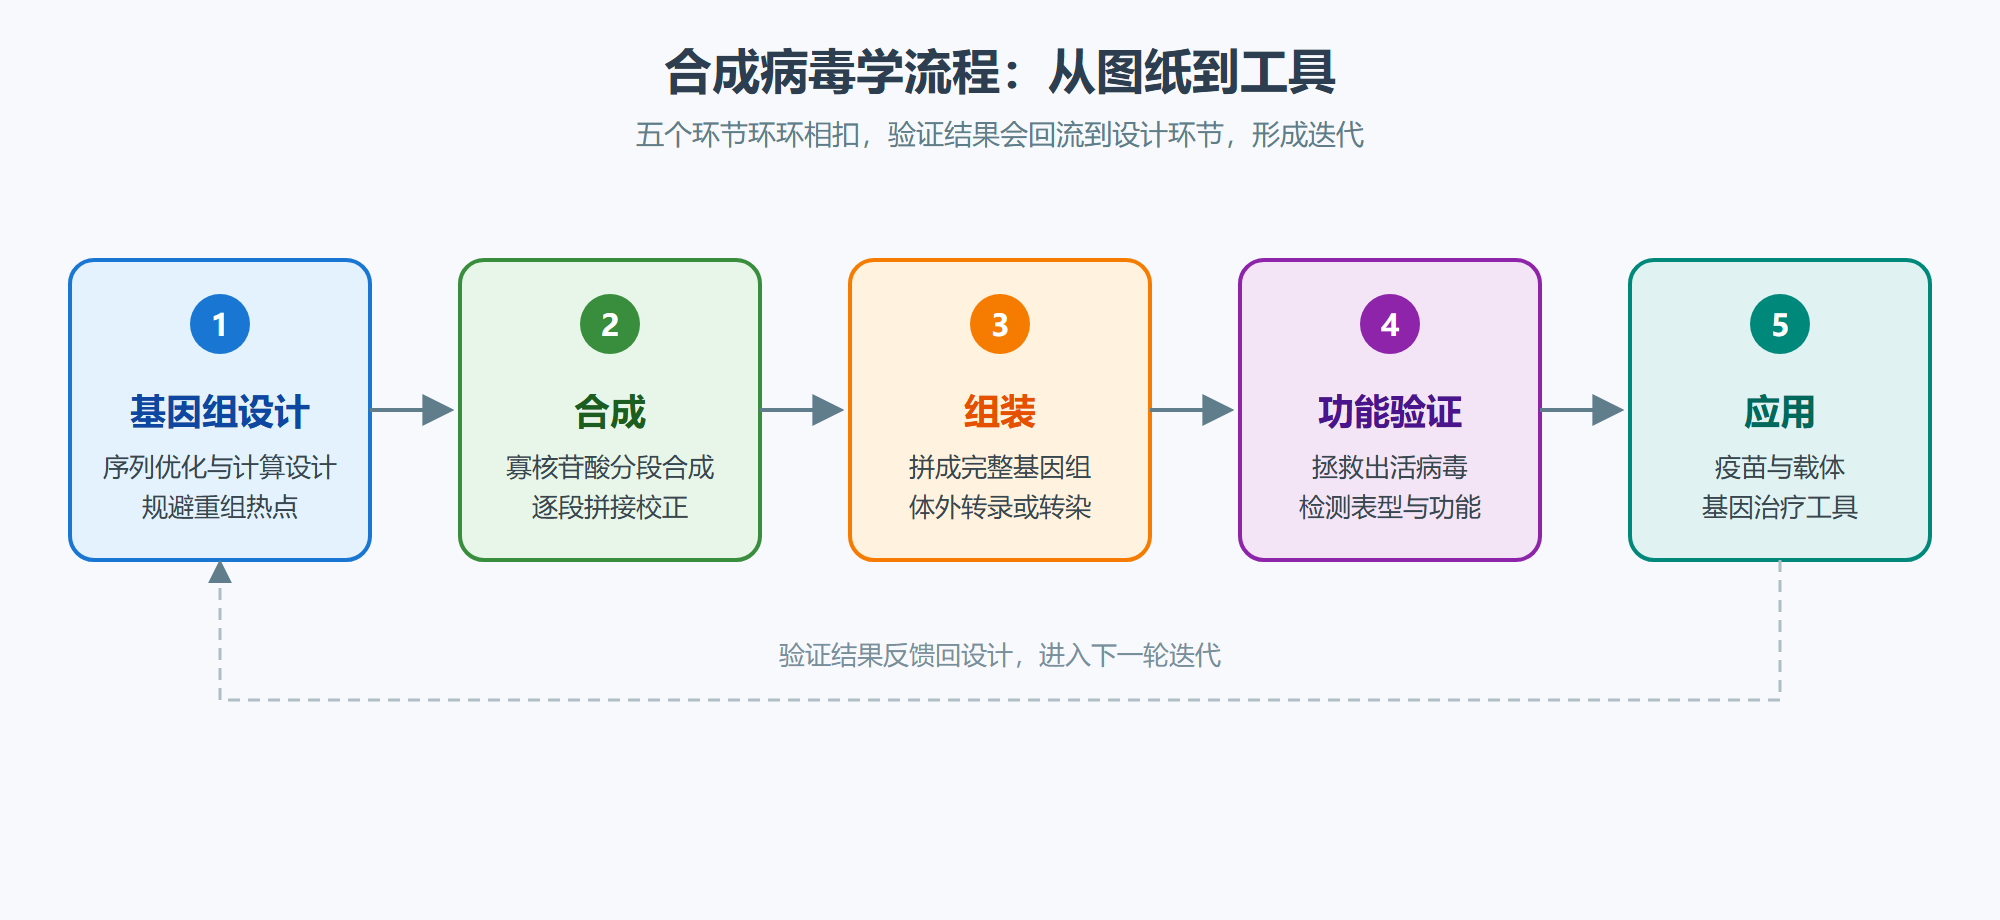
两条路最终汇到同一个出口:救出活病毒,再去做功能验证。选哪条,取决于你要的是"从无到有重建",还是"在已有基础上精改"。
三、功能解码:把序列和表型对上号
合成出来的病毒只是半成品,真正有价值的是"解码"这一步——搞清楚哪段序列对应哪个功能。只看序列比对是猜,功能解码是要用实验把猜变成证据。
常用的做法有三类。第一类是"删":删掉一个基因或一段调控区,看病毒还能不能复制、复制效率掉多少。第二类是"换":把某个氨基酸换成另一个,看表型怎么变,也就是点突变。第三类是"扫":深度突变扫描,把某个蛋白的每个位点都系统地变一遍,一次拿到一张"位点—功能"的完整地图。
回到工厂的比喻:删基因等于关掉一个车间,换氨基酸等于把一个工人换成另一个,深度突变扫描等于把整条产线每个岗位都轮着换人测一遍。前两种回答"这个部件重不重要",第三种能进一步回答"这个位置换成谁效果最好"。比如要优化一个衣壳蛋白,就把它的每个位点都换成另几种氨基酸,看哪些替换让转导效率上升、哪些让免疫原性下降,最后得到的是一张能直接指导设计的表,而不是一句笼统的"这个蛋白很重要"。三种手段越往后越细,成本也越高,所以实际项目里常常是先删后换、最后再扫,按需升级精度。
💡 关键直觉:功能解码的价值不在于"证明某个基因有用",而在于把模糊的相关性变成精确的因果。"基因 A 和致病性相关"是猜,"A 蛋白第 127 位决定组装效率"才是能用、能预测的结论。判断一个研究靠不靠谱,就看它有没有跨过这条线。
四、病毒作为工具:基因递送与治疗
解码能力一上来,病毒就从"研究对象"变成了"生产工具"。最典型的是腺相关病毒载体。它的天然衣壳靶向性一般,还容易被人体已有抗体中和。合成病毒学的解法是定向进化:造一大批衣壳突变体,先放进含血清抗体的环境里筛,活下来的就是能逃避免疫的;再放进目标细胞里筛,富集出靶向更好的。几轮下来,衣壳就能进化出天然病毒没有的属性。这相当于给病毒做"定向育种",只不过育种的是衣壳蛋白。
这套思路已经用在不少治疗场景里:改造过的载体能更准地把治疗基因送进肝、送进神经系统;溶瘤病毒被设计成只在肿瘤细胞里复制、顺带激活免疫;合成减毒疫苗则是用计算机设计稀有密码子,把病毒复制速度降下来,免疫原性留住,让疫苗既安全又有效。前面反复出现的 mRNA 疫苗,虽然不是造完整病毒,但"人工设计一段序列去编码目标抗原"的思路,跟合成病毒学一脉相承——差别只在于它跳过了"造完整病毒"这一步,直接造了最关键的抗原片段。
五、工程实践:取舍与坑
两条合成路线各有代价,选之前先把账算清。
| 维度 | 从头化学合成 | 反向遗传学 |
|---|---|---|
| 起点 | 只要序列即可 | 需要病毒 RNA 或互补 DNA 抄本 |
| 擅长 | 从无到有重建、长基因组 | 精细定点改动、逐个碱基测试 |
| 主要代价 | 合成与拼接成本高、易出错 | 依赖初始材料,RNA 不稳定 |
| 代表场景 | 重建已灭绝或受限病毒 | 研究单个位点、构建减毒株 |
| 关键风险 | 序列错误随长度累积 | 转染与拯救效率波动 |
⚠️ 常见坑:只盯着"能不能救出病毒",忽略了功能验证。救出活病毒只是拿到了一个能跑的样品,如果不做解码,你对它还是一无所知。很多项目卡在"造出来了,但说不清它和原型差在哪",就是因为把"合成"当成了终点。
💡 关键直觉:把"合成"和"解码"当成一条流水线的两段,而不是两个独立课题。合成给解码提供可对照的样品,解码给合成指出下一轮要改哪里。谁把这段回路跑通了,谁就能把迭代周期从年压到月。
安全上,任何涉及高风险病原的合成都必须在受控环境下进行,合成序列还要能被追溯。这是这类研究的底线,不是可以讨价还价的可选项。
这里我们必须把"双刃剑"三个字说透。合成病毒学的工具本身是中性的,它既能造出更安全的减毒疫苗,也能把一段早已消失的病原序列重新搭回实验室。真正的风险不在"能不能造",而在"造出来之后谁用、怎么用"。所以这一行的规矩从来不是写完一篇论文就完事:高风险病原的合成通常要经过伦理审查和生物安全评估,序列的来源与去向要有记录、能被追溯,不少机构和期刊还会要求声明没有把技术用在越界的用途上。对研究者来说,底线意识可以压成一句:造得出,不代表就该造,更不代表造出来就该放出去。把"合成能力"和"功能解码能力"分开看也很关键——前者决定你能改变什么,后者决定我们应不应该去改变。缺了后者,前者就只是一把没有刹车的锤子。
本节速览
- 合成病毒学:用工程化思路设计、合成、组装病毒基因组,再用功能解码把序列和表型对上号。
- 两条路线:从头化学合成适合从无到有重建,反向遗传学适合在互补 DNA 抄本上做精细改动,二者经常配合。
- 功能解码:靠"删、换、扫"三类实验把"相关"升级成"因果",而非只看序列比对。
- 定向进化:把衣壳突变体放进选择压力里筛,几轮就能得到天然病毒没有的靶向和免疫逃逸属性。
- 工具化应用:载体递送、溶瘤病毒、合成减毒疫苗、mRNA 疫苗,都是同一条合成思路的不同落点。
- 主要代价:合成成本、拼接出错、安全与伦理约束,决定了它只能用于受控场景。
图 合成病毒学流程
下一节我们去看那些"养不出来、查不到"的病毒——病毒暗物质。合成病毒学卡在"造不造得出来",而暗物质研究卡在更前面一步:连这些病毒的序列都还没摸到。