6.3 人工智能驱动分类革命
6.3 人工智能驱动分类革命
本节摘要:人工智能驱动的病毒分类,是用机器学习模型从序列、结构、宿主等多模态数据里自动判断一个病毒属于哪一类,甚至预测它会不会跨物种传播。传统分类靠专家一条条比对,序列一多就顾不过来;AI 把这件事变成了数据仓库里的自动分拣:序列模型做初判,结构预测补细节,跨物种模型估风险,最后人工校验入库。读完本节,你能说清这三类模型各管一段、它们怎么串成一条流水线,以及这条流水线最容易被什么坑绊倒。
读前必看(上)
阅读完本节,你应当能够:
- 说清 AI 分类和传统专家分类在工作方式上的本质区别。
- 区分序列模型、结构预测、跨物种预测三类模型的输入和用途。
- 描述一条从序列输入到人工校验的 AI 分类流水线。
- 解释为什么"数据偏见"会让 AI 分类出错,以及怎么缓解。
- 指出 AI 分类结果为什么仍然需要人工复核。
一、序列多到人看不过来了
病毒分类的活儿,几十年前还是专家坐在显微镜前、对着比对结果一条条下结论。但测序技术把这件事的量级彻底掀翻了:现在一年新增的病毒基因组序列,比过去几十年积累的还多。人工一条条翻,翻不完,也翻不快。更要命的是,新序列还在指数级地往上堆,人手增长的速度完全跟不上,靠堆人力已经是一条死路。
更麻烦的是,传统比对方法面对新型病毒、重组病毒常常失灵。它靠的是"和已知病毒像不像",一旦来个完全陌生的序列,或者一段衣壳配一段全新复制酶的"混血",比对工具就答不上来。这就像仓库里到货速度越来越快,而分拣员只会按一本旧目录分类——目录上没有的货,就被堆在一边。
人工智能的介入,本质是把"人工翻目录"换成"自动分拣"。它不要求先有现成的答案,而是从海量数据里自己学出规律,再拿规律去判断新来的序列。更重要的是,它把病毒当成"信息实体"来分,而不是当成"形态实体"——分类的依据从"长得像不像"变成"特征分布像不像、演化关系近不近"。
二、三类模型:序列、结构、跨物种
AI 分类不是一个大模型包打天下,而是三类模型各管一段。先分清自己要回答哪个问题,再挑对应的模型,比上来就上最复杂的模型划算。
第一类是序列模型。它直接从基因组序列出发,把序列切成一串串短片段,统计片段频率、找出保守基序,再用神经网络判断"这串序列是不是病毒、大概属于哪一类"。它的强项是快、能处理海量数据,而且可以做无参考聚类——不依赖已有分类,自己把相似的未知序列拢成一堆。这类模型里,有的是用卷积网络扫序列里的短片段模式,有的用注意力机制捕捉长距离的基因关联,已经被拿来在宏基因组数据里做初筛,把病毒片段从海量宿主序列里挑出来。暗物质探索里捞上来的那些"查无此毒"的序列,第一道分拣就靠它。
第二类是结构预测。病毒蛋白的功能藏在它的三维结构里,而结构预测模型能只凭氨基酸序列,把蛋白大概长什么样算出来。有了结构,就能判断两个病毒的关键蛋白是不是同源、功能是不是相近,给序列模型补上"长得像不像"这一维。这在地处序列相似度很低、单靠序列分不出来的场景里尤其有用。因为结构比序列演化得慢,两个序列差异很大、但折叠相近的蛋白,很可能还是同一个家族。
第三类是跨物种预测。它把宿主的信息也纳进来:这个病毒在哪些宿主里出现过、宿主细胞表面的受体长什么样、感染后宿主的免疫通路怎么反应。综合这些,模型给出一个"跨物种传播风险"的判断。它输出的通常是一个风险等级,而不是非黑即白的结论——比如某个禽流感毒株出现了几个关键位点变化,模型会提示它结合人源受体的能力可能上升,值得提前盯住。这一层的目标已经不是"它是什么",而是"它会不会跳到人身上"。
三类模型不是竞争关系,而是互补:序列模型负责"有没有、是哪类"的初判,结构预测负责"为什么这么分"的佐证,跨物种模型负责"要不要警惕"的预警。三路信号汇到一起,才是一个相对完整的判断。
三、一条 AI 分类流水线怎么跑
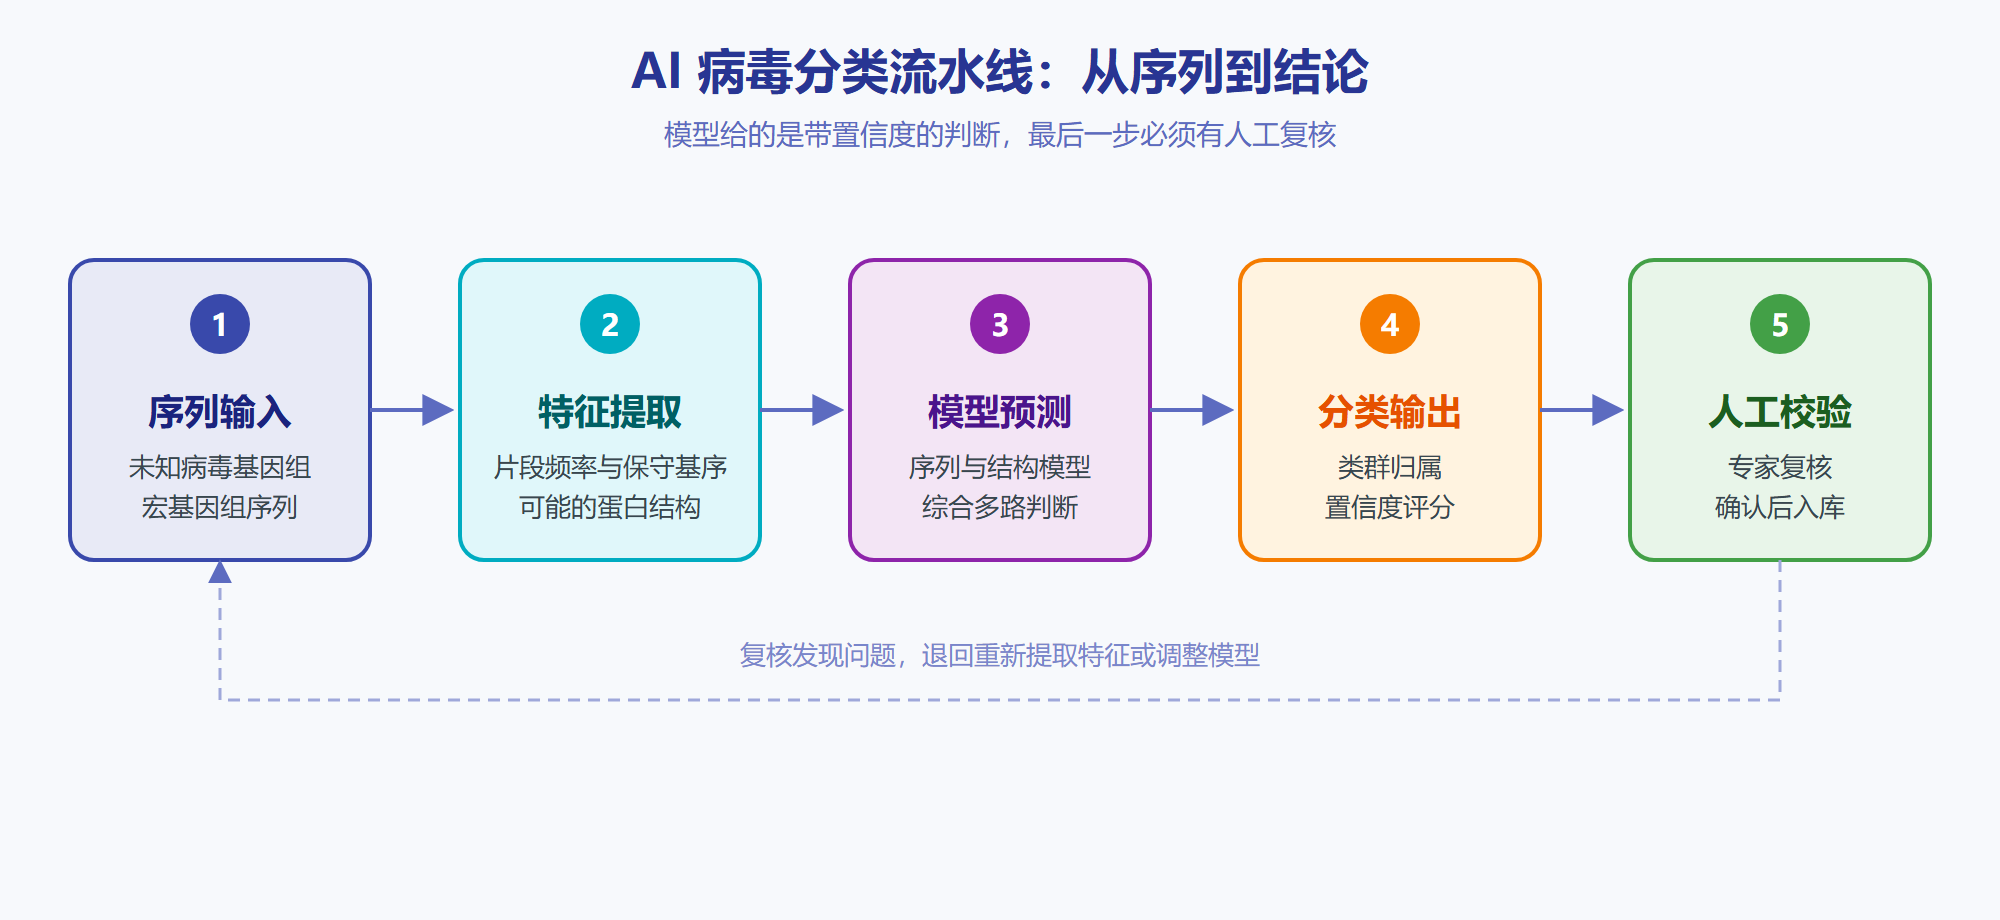
把三类模型拼起来,就是一条标准的 AI 分类流水线。它和前面两节讲的生产线一样,也是分环节的,只是这里搬运的是数据而不是病毒。
第一步是序列输入。进来的可以是单条未知序列,也可以是一整批宏基因组数据。数据先要清洗——去掉接头、低质量片段,把宿主污染尽量剥掉,否则后面全是噪声。清洗时尤其要区分病毒序列和宿主序列的污染,这步做不好,模型再强也是在噪声上训练。
第二步是特征提取。把清洗好的序列转成模型能算的形式:片段频率、保守基序、可能的蛋白结构等。这一步做得好不好,直接决定模型能不能"看懂"序列。
第三步是模型预测。序列模型给初判,结构模型补同源证据,跨物种模型估风险,三个结果一起进综合判断层,输出一个带置信度的分类结论。置信度高低直接决定下一步要不要人介入——低于阈值的,宁可标成"待定"也别硬塞进某个类群。
第四步是分类输出。结果是"属于哪个类群"加上一个置信度分数,可能还附一张风险提示——哪些位点值得关注、跨物种风险有多高。
第五步是人工校验。这一步最容易被人忽略,却最不能省。模型给的是概率,不是事实,得有人复核:置信度低的、结论反直觉的、涉及高致病风险的,都要专家再盯一眼,确认无误才入库。比如一个置信度只有六成、却被判成新属的序列,就必须退回模型重看,甚至回到特征提取那一步重新来一遍。
如果非要在这五步里挑一个最容易翻车的,多数时候是第一步的清洗,而不是模型本身。模型再聪明,喂进去的是带接头、带宿主污染的序列,学到的也还是噪声。宏基因组样本尤其难缠:一份土壤或污水样本里,病毒序列往往只占千分之一量级,宿主和细菌的基因组是压倒性的大多数,稍没剥干净,模型就可能把一段细菌片段误判成"新型病毒",再一路把错误送进下游。这类错报比漏报更隐蔽——漏报顶多少发现一个,错报却可能让一个根本不存在的"新病毒"进了数据库,被后来的人反复引用。所以我们会在清洗后加一道去污染校验,把疑似宿主片段单独捞出来二次比对,宁可这一步慢一点,也不让上游的脏数据流到分类那一步。
图 AI 病毒分类流水线
💡 关键直觉:AI 分的是"信息实体",不是"形态实体"。它不靠"长得像",而靠特征分布和演化关系来判断。所以它能发现人眼和传统比对都看不见的规律,但也因此需要人来把关——因为它"看得见模式,看不见因果"。
四、工程实践:三类模型怎么选
三类模型各有边界,不能指望一个模型干所有事。选型时先想清楚:你现在要回答的是"是不是病毒、是哪类",还是"为什么这么分",还是"会不会跳过来"。
| 模型类型 | 主要输入 | 擅长判断 | 典型局限 | 代表用途 |
|---|---|---|---|---|
| 序列模型 | 基因组序列 | 是否病毒、属于哪类 | 序列差异大时易误判 | 宏基因组初筛、无参考聚类 |
| 结构预测 | 氨基酸序列 | 蛋白同源与功能 | 计算量大、结构有误差 | 佐证亲缘、辅助分型 |
| 跨物种预测 | 序列加宿主信息 | 溢出与传播风险 | 依赖宿主数据质量 | 新发病毒预警 |
⚠️ 常见坑:数据偏见。训练数据如果过度集中在人类病原体上,模型遇到环境病毒或热带地区的新病毒,准确率会明显掉。缓解办法是主动补稀有样本、跨地域验证,而不是只盯着总体准确率这一个数字。另一个坑是黑箱——模型给出分类,却说不清依据,专家不敢采信。所以高风险的结论,必须走人工复核。
💡 关键直觉:AI 分类的价值不在"替人下结论",而在"把人从海量初筛里解放出来"。让人工注意力集中在最可疑、最反常的那一小撮上,才是这套流水线最划算的用法。
还有一个常被忽略的问题是可解释性。模型给出"新属"的结论,专家却不知道它依据的是什么,就难以采信。现在有研究用归因方法把模型看重哪些位点标出来,帮着专家理解判断依据。反过来,也有场景不该硬上 AI:样本极少、又要求极高确定性的法定鉴定,传统比对加专家判断仍然更稳。AI 适合量大、需要快速初筛的场景,不适合那种"错了就出大事"的最终裁决。另外,病毒在持续演化,模型也得跟着持续更新,否则一年前的分类器放到今天,碰到新变种就会失灵。
本章回顾
- AI 分类:用机器学习把病毒分类从"人工翻目录"变成"自动分拣",分类依据从形态转向特征与演化关系。
- 三类模型:序列模型做初判,结构预测补同源证据,跨物种模型估传播风险。
- 标准流水线:序列输入、特征提取、模型预测、分类输出、人工校验,五步缺一不可。
- 人工校验:模型给的是概率不是事实,高风险结论必须专家复核,这是流水线的兜底环节。
- 数据偏见:训练数据偏向人类病原体,会让模型在环境病毒和新区域病毒上失灵。
- 边界意识:AI 看得见模式、看不见因果,所以它负责提效率,人负责下判断。
到这里,本章的三条前沿路线就串起来了:暗物质供货、AI 分拣、合成病毒学质检。它们单看是三个方向,合起来指向同一个未来——一套能把"未知序列"自动变成"可用结论"的下一代病毒分类体系。这也是整本文集想留给你的一句话:分类不是为了归档过去,而是为了提前看清下一个病毒可能从哪来。