8.2 研究级计算范式
8.2 研究级计算范式
本节摘要:研究级计算,指的是把广义相对论从黑板上的方程,变成一组可复现、可证伪、带误差估计的数值结果。它和"跑通一个演示"的差别,不在算得快不快,而在敢不敢对结果负责。本节沿三条生产线展开:数值相对论负责演化真空时空,磁流体模拟负责把吸积盘与喷流这些物质自由度加进去,数据分析负责把探测器波形反演成黑洞的质量与自旋。三条线共享同一套价值观——把误差当核心变量,而不是事后补上的道歉脚注。
学习目标
阅读完本节,你应当能够:
- 解释"三加一分解"为什么要做,以及约束方程在演化中扮演什么角色。
- 区分两类主流演化方案在处理约束违反上的思路差异。
- 说明磁流体模拟相比真空演化,多处理了哪些物理量,代价又是什么。
- 描述引力波数据分析中"从波形到参数"的贝叶斯反演流程。
- 列举一份数值结果里三类最容易被忽略的误差来源。
- 判断一份研究级结果是否"收敛可信",需要向作者索要哪些证据。
图:研究级计算的三条生产线
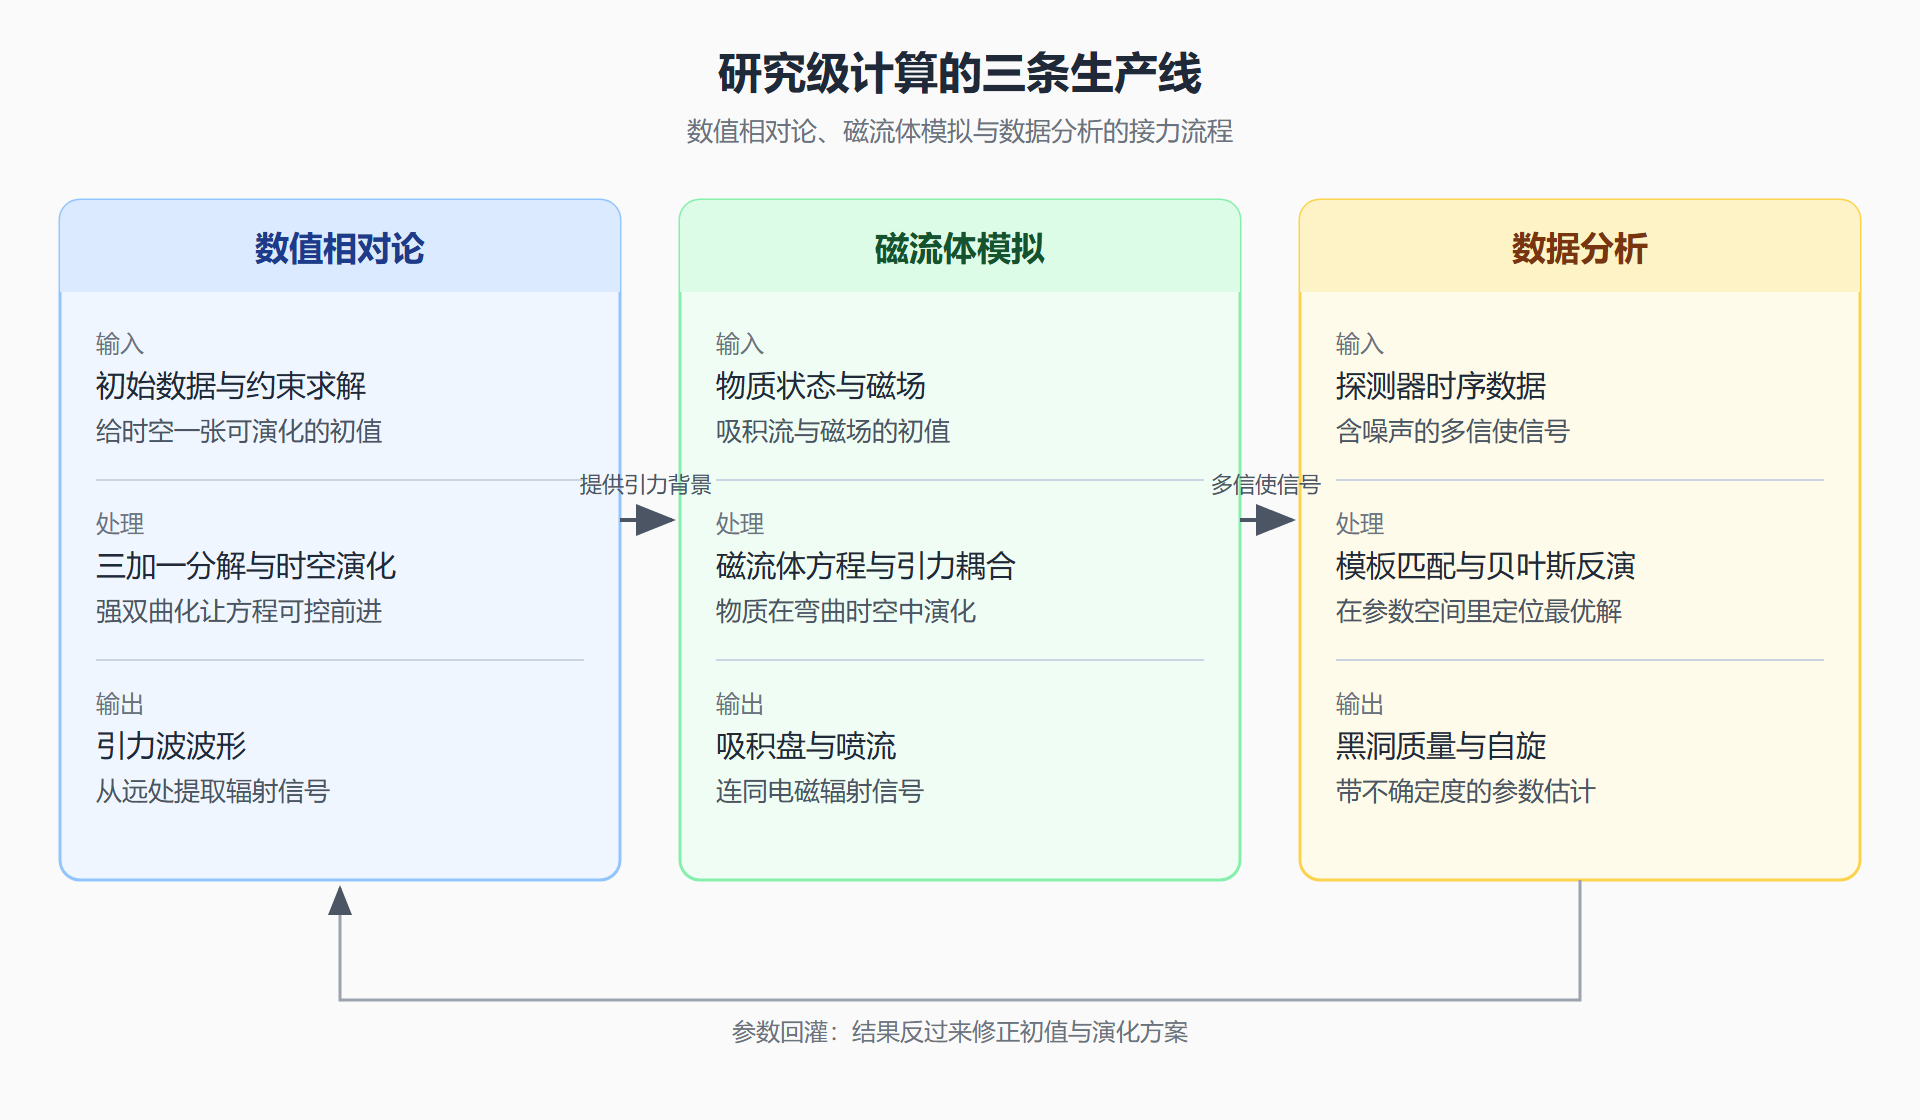
上面这张图是三段接力:真空时空先由数值相对论演化出波形,磁流体模拟再把物质与磁场加进去、产生电磁信号,最后数据分析把多信使信号反演成参数,并把结果回灌去修正前面的初值假设。
一、研究级三个字的含义:三层可信度
"研究级"不是"高性能"的同义词。一台超算可以每秒做百亿亿次运算,却未必产得出一份研究级结果;一个开源代码库可以有几万颗星,若没有系统的验证协议,它的输出仍停留在"现象示意"层面。真正的研究级计算,是三层可信度的交叠。
第一层是物理保真。数值方案必须尊重广义相对论的基本结构:约束要守恒、双曲性要成立、规范自由度要处理干净、渐近行为下的可观测量要定义一致。为什么一组特定的初始数据会成为标准?不是因为它形式简洁,而是因为它精确满足真空约束方程,并且把质量、角动量、分离矢量这些物理量之间的映射写得明明白白——它把"黑洞裸奇点之外"这个物理前提,编码成了一个可构造、可重复的初值问题。
第二层是算法稳健。面对强场区的网格畸变、坐标奇点的逼近、并合瞬间的曲率暴涨,演化方案不能靠"调参的手感"硬撑。两套主流方案之所以被广泛采纳,正在于它们把爱因斯坦方程重写成了强双曲系统,显式分离出动力学自由度与约束传播模态,让数值不稳定的源头变得可诊断、可抑制。它们不是"更好用的旧方法",而是对广义相对论内在结构的一次深度重编码。
第三层是推断可信。当探测器传来一段含噪时序数据,我们真正要回答的从来不是"哪个波形最像它",而是"在所有符合物理先验与仪器响应的参数组合里,哪些最可能生成这段观测"。这已经超出拟合,进入了贝叶斯推理的范畴。此时"研究级"意味着:模板必须覆盖参数空间的奇异区,噪声必须完整建模,采样必须通过多重收敛诊断,误差必须从初值一路传播到参数后验。
这三层构成一个铁三角:它不许诺"完美答案",但承诺"可问责的答案"——每个数字背后都有可追溯的假设、可复现的步骤、可量化的不确定性。
二、数值相对论:把时空切成时间片
数值相对论的第一道门槛,是怎么让计算机"看得见"四维时空。计算机只会在一串离散的格点上存数,而时空是个连续的四维对象。解法就是三加一分解:把四维时空切成一摞三维空间切片,每一片带上它自己的几何与外曲率,再让切片沿着时间一层层往前推。
切片之后,爱因斯坦方程分成了两类,性质完全不同。一类是演化方程,负责告诉下一片切片长什么样;另一类是约束方程,负责在每一片内部检查"这一刻的几何与物质是否自洽"。打个比方:演化方程像电影的放映机,一格一格往下走;约束方程像质检员,每一帧都要检查有没有穿帮。理想情况下,只要初值满足约束、演化方案够好,约束就该一直满足下去。可数值误差会不断往里注入"穿帮",所以约束违反量成了衡量模拟健康度的核心仪表。
初值也不是随便给的。黑洞初值要满足约束方程,而直接写一个满足约束的任意双黑洞初值并不容易。标准做法是先在一个近似的、可解析的框架里构造初值,再通过求解椭圆型方程把约束"补全"。这一步的要点是:初值里已经把黑洞的质量、自旋、轨道运动这些物理信息"雕刻"进了几何纹理,之后的演化只是把这些信息按方程推下去。
演化的主流方案有两类,差别就在怎么对待约束违反。一类引入一组额外的共形变量,把原始方程组重构为准线性双曲组,让特征速度变得清晰;另一类更进一步,把约束本身也当作演化变量嵌进系统里,给约束违反加一个阻尼项,让它像被"驱散"一样衰减,而不是在网格上越积越多。后者的好处在长时演化、高分辨率、极端质量比这些场景里特别明显,但也多了一组需要小心标定的参数。
| 环节 | 要解决的问题 | 关键做法 |
|---|---|---|
| 三加一分解 | 把四维时空变成可演化的切片 | 空间度规与外曲率成对推进 |
| 初值构造 | 给一个满足约束的起点 | 近似解析框架加椭圆求解补全 |
| 约束监测 | 判断演化是否健康 | 每片检查约束违反量 |
| 波形提取 | 从网格数据得到远处信号 | 在外推半径下取极限 |
⚠️ 常见坑:初值里一丁点约束违反,可能在演化中被放大成与真实引力波同频段的假信号。所以研究级流程从来不是"跑完就算",而是要盯着约束违反的曲线看它有没有失控。
三、磁流体模拟:给时空装上物质
真空演化只处理几何,可真实黑洞周围从来不是空的:吸积盘、磁场、喷流,这些才是让黑洞"亮起来"的东西。磁流体模拟的任务,就是在弯曲时空中同时演化物质与电磁场,让它们和几何相互反馈。
多出来的自由度不是小数目。真空演化处理的是几何量;磁流体模拟还要处理物质的密度、压强、速度,以及磁场,再把这些量通过能量动量张量喂回爱因斯坦方程。这带来两个直接后果:一是方程组的耦合复杂度陡增,几何与物质每一步都要同步推进;二是数值上更脆,因为磁流体方程本身可能出现激波、湍流这些强间断结构,需要额外的处理手段去压住。
磁流体模拟的核心输出,是吸积盘的形态、喷流的产生、以及随之而来的电磁辐射。这些信号和引力波信号互补:引力波告诉我们黑洞本身的质量与自旋,电磁辐射则告诉我们黑洞周围的环境、吸积流的成分与温度、喷流的方向。事件视界望远镜那张 M87 照片,本质上就是磁流体模拟与观测相互校准的产物——模拟给出光环应该长什么样,观测再反过来约束模拟里的磁场强弱与吸积流参数。
💡 关键直觉:真空演化回答"时空自己怎么动",磁流体模拟回答"时空里的东西怎么被带着走、又怎么反过来影响时空"。两者叠加,才是一张完整的、会发光的黑洞画像。
磁流体模拟的代价也要说清楚。它比真空演化贵得多,网格要求更高,模型里还塞了大量近似——比如对湍流粘滞、对辐射输运、对电子温度的处理,往往都是唯象的。这意味着磁流体模拟产出的"漂亮图",物理上往往比真空波形更"软",更需要小心地标注假设。
四、数据分析:从波形反演到参数
数据分析和前两条生产线方向相反。前两条是正问题:给初值,往前算出波形。数据分析是反问题:手里只有一段含噪声的探测器数据,要倒推产生它的黑洞参数。
直接"倒推"是做不到的,因为噪声会让无数个不同的参数组合都能"凑出"看起来差不多的信号。正确的做法是贝叶斯反演:不找一个唯一答案,而是给每个可能的参数组合算一个"有多可信"的后验权重。先写一个模板波形模型,再写一个似然函数描述"给定参数时,观测到这段数据的概率",结合物理先验,就能得到参数空间里的后验分布。
这个流程里有两处特别容易出问题。一处是模板覆盖:参数空间有各种角落,极低质量比、极高自旋这些区域如果模板铺得不够密,真实信号可能落在两个模板之间被漏掉。好的模板银行不是均匀撒点,而是按参数空间的"距离"自适应加密,保证任意信号都能找到足够接近的模板。另一处是噪声建模:真实探测器噪声不是理想的高斯白噪声,有非平稳的瞬态、有谱线的污染,这些若不建模,后验分布会被系统性拉偏。
| 概念 | 正问题 | 反问题 |
|---|---|---|
| 方向 | 给初值算波形 | 给数据反推参数 |
| 输出 | 一段确定的波形 | 一组参数的概率分布 |
| 难点 | 数值稳定性 | 噪声与模板覆盖 |
| 典型产物 | 并合波形模板 | 质量自旋的后验区间 |
💡 关键直觉:数据分析输出的不是"一个数",而是"一个分布"。一篇论文里若只写"这颗黑洞质量是某某",而不给不确定度区间,那这句话就没有研究级的含金量。
五、误差是核心变量,不是脚注
把三条生产线连起来看,会发现一个共同的规律:误差从头到尾都在,而且会传染。初值的近似残差,会在演化里被放大成约束违反;约束违反又可能污染提取出来的波形;被污染的波形再喂给数据分析,最终后验分布就会被系统性偏置。最糟的情况是:你高置信度地"精确测定"了一个其实被系统误差污染的参数。
所以研究级实践强制要求一件事:多分辨率收敛性检验。同一个物理问题,用几套不同的网格分辨率独立跑,看关键观测量怎么随分辨率变化。只有当误差按理论预期的阶数衰减、外推结果落在物理合理的窗口内,这份模拟才算"收敛可信"。这背后是一整套关于验证与确认的文化:每次发表的波形要附误差谱,每个发布的参数估计要标注系统误差占比,每套公开的数据要带上完整的收敛性元数据。
回到开头那个问题——研究级计算究竟研究什么?它研究的不是黑洞,而是"我们关于黑洞的知识有多牢靠"。欧几里得用公理与尺规丈量平面,黎曼用度规与联络刻画弯曲空间,今天的我们用初值构造、演化方案、提取协议与推断引擎,在离散网格与概率分布的交界处,重新定义什么叫做"可证成的时空知识"。它不承诺终极真理,但确保每一步都踩在可检验、可批判、可传承的基岩上。
要点串联
- 三层可信度:研究级计算由物理保真、算法稳健、推断可信三者共同撑起,缺一不可。
- 三加一分解:把四维时空切成空间切片,演化方程推进、约束方程质检。
- 初值即物理:满足约束的初值里已经刻进了质量、自旋与轨道信息,初值质量决定后续可信度。
- 两套演化方案:一套重构为强双曲系统,一套把约束当演化变量加阻尼,思路差异在怎么对待约束违反。
- 磁流体模拟的定位:给时空装上物质与磁场,输出吸积盘、喷流与电磁辐射,代价是更贵、更依赖唯象近似。
- 数据分析是反问题:用贝叶斯反演得到参数的后验分布,难点在模板覆盖与噪声建模。
- 误差是核心变量:初值、演化、提取、推断四段误差会传染,多分辨率收敛性检验是研究级的底线。
- 判断标准:一份结果是否可信,要看它有没有误差谱、收敛性元数据与系统误差说明,而不是看画面是否漂亮。
至此,本节的"怎么算"讲完了。整个文集也从"什么是黑洞"一路走到了"怎么把黑洞知识教出去、算出来"。若你打算真正上手,建议从 8.1 的三件教学工具里挑一件先跑通一个最小示例,再用本节的收敛性标准去审视它的输出——这一步,比读再多的文字都管用。