1.1 管线的起点:FFmpeg 的由来与生态位
1.1 管线的起点:FFmpeg 的由来与生态位
本节摘要:本节从 FFmpeg 的诞生背景讲起,说明它如何从一个桌面转码小工具长成整个音视频行业的底层设施,并给出它在技术生态中的位置——不是某个「视频处理软件」,而是一套可拆可组的标准组件集。
本节目标:阅读完本节,你应当能够:
- 说出 FFmpeg 诞生的年份与初衷,理解它解决的「格式碎片化」痛点
- 区分 FFmpeg 的三个层次:命令行工具、库(libav* 系列)、标准
- 举例说明 FFmpeg 在转码服务、播放器、直播系统里各扮演什么角色
一、先回答一个反问
你知道 2000 年前后,一个视频网站要支持三种视频格式,得写多少代码吗?
答案是三份几乎完全独立的播放与转码逻辑。那时 RMVB、AVI、MPEG-4 各自为政,每家的容器、编码、时间戳规则都不兼容,连「一帧数据」是什么都各说各话。Fabrice Bellard(后来还写了 QEMU)就是在这样的环境里发起了 FFmpeg 项目,目标只有一个:把「处理任何音视频格式」这件事收拢成一套统一接口。
今天你打开任何一台 Linux 服务器,ffmpeg 几乎都是预装软件;YouTube 的转码集群、大量播放器的内核、无数直播 SDK 的底层,都站着 FFmpeg。它不是被「设计」出来的标准,而是被无数真实需求「压」出来的事实标准。
二、FFmpeg 的三层结构
很多人以为 FFmpeg 就是一条 ffmpeg 命令。其实它有三层,理解这三层才谈得上「解剖」:
- 命令行工具:
ffmpeg(转码)、ffprobe(探查)、ffplay(播放)。日常 80% 的需求在这一层解决。 - 库集合:
libavformat(封装/解封装)、libavcodec(编解码)、libavfilter(滤镜)、libavutil(公共工具)、libswscale(缩放/像素格式转换)、libswresample(音频重采样)。这是 FFmpeg 的「真身」,命令行只是这些库的薄壳。 - 隐含的接口约定:AVPacket、AVFrame、AVFormatContext 等数据结构定义了数据在这些库之间流动的「接口协议」。第三方项目遵循这套约定,就能接入 FFmpeg 的能力。
一句话概括:库是发动机,命令行是方向盘,数据结构是传动轴。
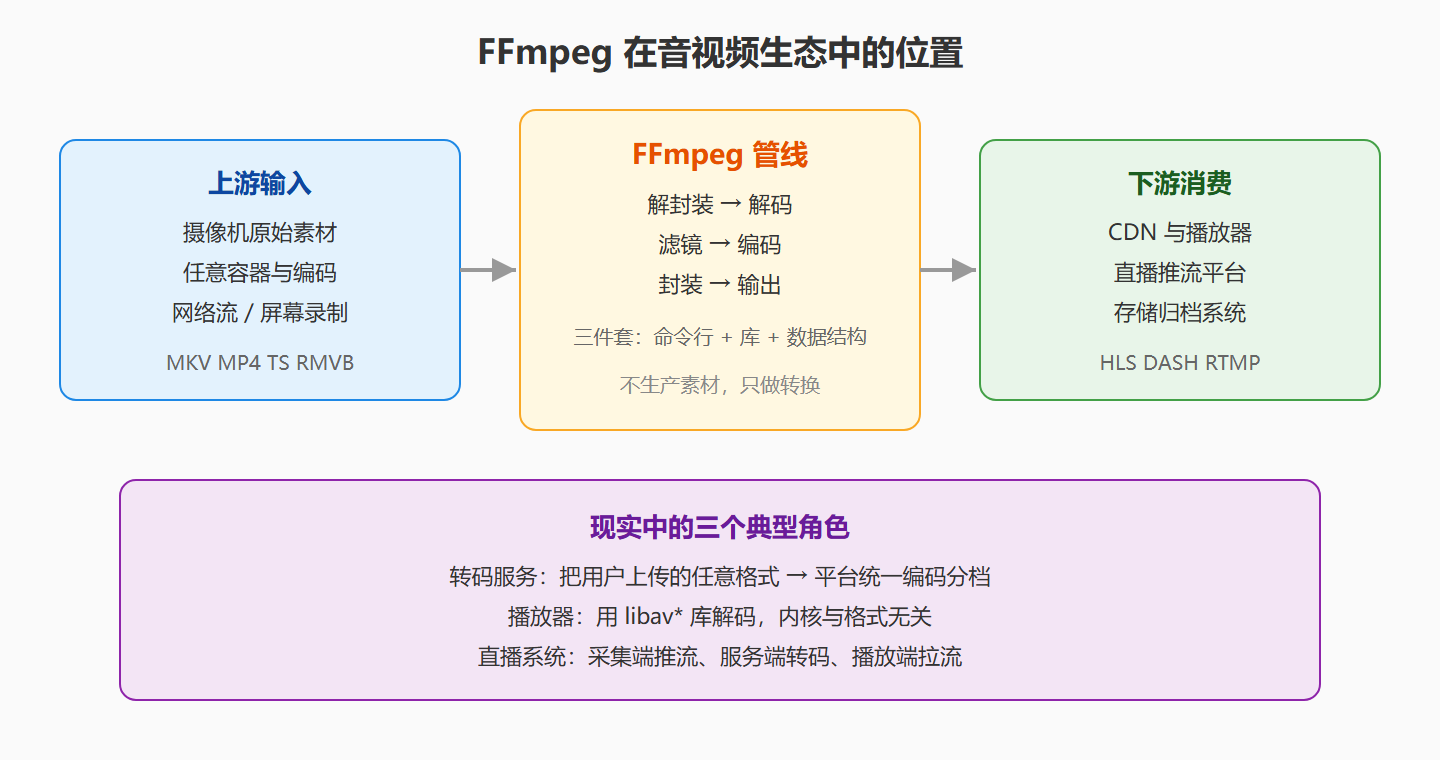
下面这张图给出 FFmpeg 在整个音视频生态中的位置——它既不生产素材,也不消费成品,而是横在「任意输入」与「任意输出」之间的转换层。
FFmpeg 生态位图解说明
上图中的三个下游角色,对应三种典型用法。转码服务只用 ffmpeg 命令行就能搭起来;播放器则是把 libavcodec 等库内嵌进自己的代码;直播系统的服务端转码介于两者之间。理解 FFmpeg 是「转换层」而非「应用」,你就能明白为什么会有那么多封装它的小工具——因为它们各借走了 FFmpeg 的一部分能力。
三、工程实践要点
知道了 FFmpeg 的生态位,实际选型时才有判断依据:
- 只做格式转换:直接用
ffmpeg命令行,够用且稳定。不要一上来就写 SDK 程序,那会把简单问题复杂化。 - 要给自己的应用加音视频能力:优先考虑 FFmpeg 的库,而不是自己造轮子。代价是二进制体积增大(含 libavcodec 通常 20MB 起),且 LGPL/GPL 许可要留意(详见第 10 章)。
- 要和浏览器打交道:FFmpeg 常见搭配是编译成 WebAssembly 在前端运行,但注意浏览器原生已经内置 H.264/AAC 解码,大部分场景不需要把 FFmpeg 搬进浏览器,只有浏览器解不了的格式(如特定 HEVC 或私有编码)才值得。
常见坑:别把「FFmpeg 装了」当成「所有格式都能处理」。FFmpeg 的能力取决于编译时开启了哪些编解码器——某些发行版为了规避专利,默认不编译 H.264 编码器。遇到
Unknown encoder 'libx264'这类报错,先查自己这份 FFmpeg 支持什么,而不是怀疑命令写错。
💡 关键直觉:判断 FFmpeg 生态位最狠的一招是
ffmpeg -version和ffprobe -version——它们会打印编译配置,那才是你手上这份 FFmpeg 的「真实能力清单」。
一个具体的验证动作
纸上谈兵没用,动手最快。装好 FFmpeg 后,随手跑一条最朴素的命令,感受一下「引擎接管数据」的过程:
# 任意拿一个视频,改成 mkv 容器(不转码,只换包装) ffmpeg -i sample.mp4 -c copy sample.mkv
这条命令会经历完整的解封装、流拷贝、再封装流程,但不会动任何一帧画面。跑完之后用文件管理器对比两个文件的大小——你会发现大小几乎一致,这正是「转换层只搬数据不加工数据」的直观证据。把这个例子记在心里,第 2 章讲库的分工时,你会立刻理解 libavformat 和 libavcodec 的分界在哪。
先建立一个「引擎思维」
用 FFmpeg 越久越会体会到,它不像普通软件那样「打开就操作」,而是更像一台引擎:你告诉它输入、输出和中间过程,它自己调度资源跑完。很多新手的不适应,恰恰来自想把 FFmpeg 当成交互式软件用——总想找一个「设置面板」。
一旦切换成引擎思维,很多行为就说得通了:为什么 -i 只能指定一次输入却可以有多个?因为引擎的输入端口不设上限。为什么参数顺序会影响结果?因为引擎按「选项 → 文件」的顺序解析配置。为什么同样的命令在 Windows 和 Linux 上结果可能不同?因为底层依赖的库和编译器版本不同。
这种思维转变带来的实际收益是:你不会再因为「参数放错位置」而抓狂,而是能主动检查自己的命令是否符合「全局选项 → 输入选项 → 输入 → 输出选项 → 输出」的骨架。第 3 章会系统讲这套骨架,本节只需要先在心里种下这颗种子。
本节要点回顾
- 痛点驱动:FFmpeg 诞生于 2000 年前后格式碎片化的环境,本质是为「处理一切格式」提供统一接口
- 三层结构:命令行(工具层)、libav* 库(能力层)、数据结构约定(接口层),库才是真身
- 转换层定位:FFmpeg 不生产素材、不消费成品,它是横在任意输入与任意输出之间的转换层
- 生态位决定了选型:转码用命令行、内嵌用库、浏览器场景先想清楚是否真需要 FFmpeg
- 能力取决于编译:
ffmpeg -version的配置输出才是能力清单,别想当然
下一节我们看这根管线上跑的数据长什么样——采样率、帧率、时间戳,为后面的实操打好地基。