2.2 数据的流动单元:AVPacket 与 AVFrame
2.2 数据的流动单元:AVPacket 与 AVFrame
本节摘要:数据在 FFmpeg 管线里以两种形态流动——压缩包 AVPacket 与原始帧 AVFrame。本节讲清两者分别在管线哪一段出现、各自装什么、怎么互相转换,并解释引用计数为什么能减少大块内存的拷贝。
本节目标:阅读完本节,你应当能够:
- 说出 AVPacket 与 AVFrame 各自出现在管线的哪一段、装的是什么
- 说明「解码 = Packet 变 Frame」「编码 = Frame 变 Packet」的转换关系
- 解释引用计数(refcount)如何避免大块数据拷贝,并指出它带来的使用约束
一、用直觉切入
想象两条不同的运输车队:一条运「整装集装箱」(压缩后的数据包),一条运「拆箱后的散货」(原始画面/声音)。FFmpeg 内部就是这两种车队在接力。
集装箱体积小、数量多、能直接进码头仓库——对应 AVPacket,装着压缩后的编码数据(H.264 的 NALU、AAC 的帧)。散货体积大、重、需要加工——对应 AVFrame,装着解码后的原始像素/采样值。解码就是把集装箱拆成散货,编码就是把散货重新装箱。 这个比喻能让你立即记住两者的分工。
二、两种数据形态的解剖
AVPacket:压缩数据包
AVPacket 出现在解封装之后、解码之前;也出现在编码之后、封装之前。它装的是「还没解码的压缩数据」或「刚编码完的压缩数据」。
关键字段(第 8 章写代码时会用到):
data/size:压缩数据本体与长度pts/dts:第 1 章讲的两个时间戳,解码顺序与显示顺序stream_index:这条包属于哪条流(视频/音频/字幕),多流文件靠它区分duration:这一包数据的持续时间
AVFrame:原始帧
AVFrame 出现在解码之后、编码之前;滤镜加工的也是它。它装的是「能直接处理」的原始数据。
关键字段:
data[i]/linesize[i]:像素或采样数据,多平面存储(YUV 就是 Y、U、V 三个平面)width/height:视频帧的分辨率format:像素格式或样本格式(yuv420p、rgb24、fltp 等)pts:显示时间戳(解码后重排过,通常已对齐显示顺序)nb_samples:音频帧的采样点数量(音频用)
形态转换就是管线的心脏
数据在管线里反复经历「Packet ↔ Frame」的形态切换,每一次切换都是一次编解码:
- 解封装产出 Packet,解码把 Packet 变成 Frame
- 滤镜只在 Frame 上干活,处理完还是 Frame
- 编码把 Frame 变回 Packet,封装把 Packet 写进容器
下面这张图画出完整的数据形态流,标注了每一步的「载体」。
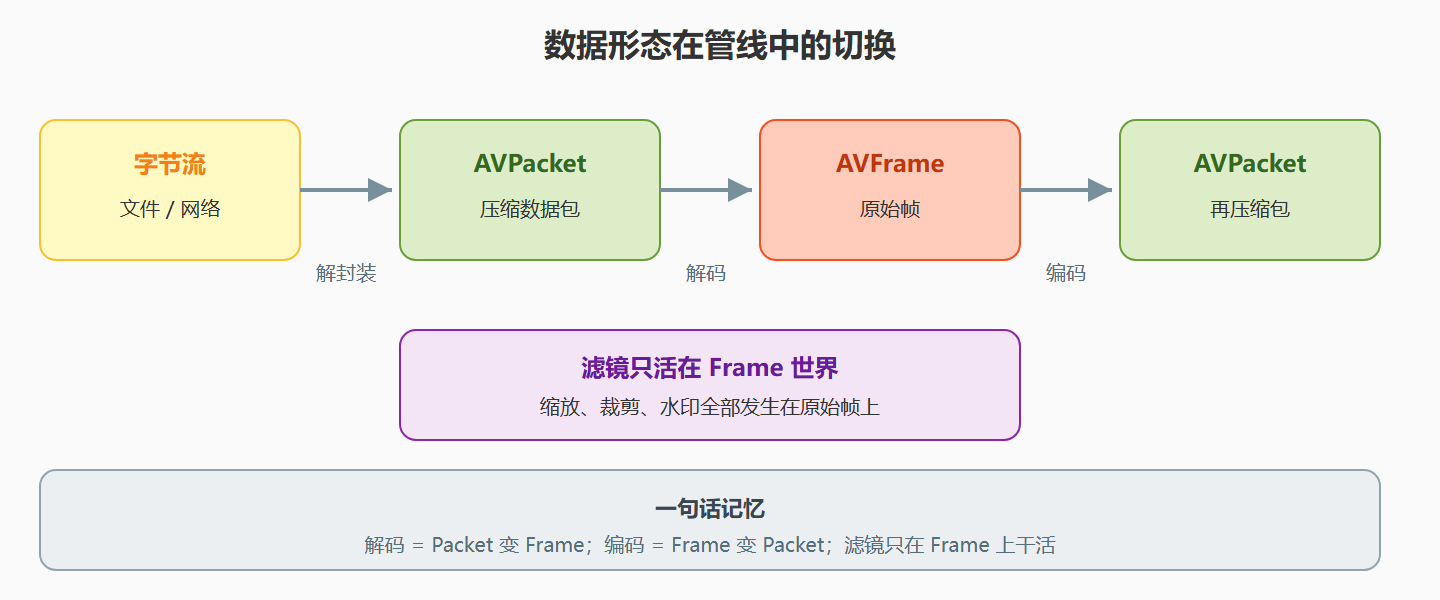
图说明:形态即位置
这张图把「形态」和「管线位置」绑在一起。你看到 AVPacket,就知道数据是压缩状态,还没解码或已编码;看到 AVFrame,就知道是原始状态,可被滤镜处理。-c copy 之所以跳过编解码,正是因为它跳过了 Packet→Frame→Packet 的形态切换。
三、引用计数与内存效率
原始帧很大(1080p 一帧 3MB 级),频繁拷贝会拖垮性能。FFmpeg 用引用计数解决这个问题:多个结构可以共享同一块数据,各自持有一个引用,都不拷贝本体。
调用关系上,av_frame_ref 增加一个引用,av_frame_unref 释放一个引用,计数归零时数据才真正释放。SDK 开发里最常见的悬空指针问题,根源就是「两个 Frame 共享数据,其中一个提前释放了」。
⚠️ 常见坑:命令行用户不太会碰引用计数,但写 SDK 时几乎必踩——
av_frame_clone只克隆结构指针不克隆数据,改了一个「克隆」,原帧的可见数据可能跟着变。要深拷贝得自己复制数据平面。
💡 关键直觉:FFmpeg 的设计哲学是「数据不动、引用动」。看到大块数据要传给下游时,先想「能不能只传引用」,而不是直接 memcpy。
一个动手看清两种形态的实验
想亲眼看到 Packet 和 Frame 的区别,用 ffprobe 就能做到。先看压缩层面的信息,再看解码层面的信息:
# 压缩层面:列出每个包的大小(Packet 视角) ffprobe -v error -show_packets -select_streams v:0 -show_entries packet=size,pts_time -of csv=p=0 input.mp4 | head -5 # 原始层面:列出每帧的分辨率与格式(Frame 视角) ffprobe -v error -show_frames -select_streams v:0 -show_entries frame=width,height,pix_fmt -of csv=p=0 input.mp4 | head -5
对比两种输出:packet 的大小各不相同(因为 I 帧和 P 帧的压缩量差异巨大),而 frame 的分辨率全部相同(都是 1280x720)。这个对比直观地说明:包是「压缩后的形态」,大小随内容变化;帧是「解码后的形态」,规格固定。理解这一点,很多关于「为什么这段视频转码特别慢」的疑惑就解开了——慢的不是帧本身,而是把大小不一的包还原成固定规格帧的过程。
本节要点回顾
- 两种形态:AVPacket 装压缩数据(集装箱),AVFrame 装原始数据(散货)
- 形态与位置绑定:解封装→Packet,解码→Frame,滤镜→Frame,编码→Packet,封装→Packet
- 切换即编解码:数据形态每切换一次,就是一次编解码,这也是
-c copy快的原因——它不切换形态 - 时间戳字段:Packet 同时带 PTS/DTS,Frame 主要带 PTS(已对齐显示顺序)
- 引用计数:共享数据、引用动数据不动,能省内存但引入「共享可变」的隐患
下一节,这条管线要从图纸上跑起来了——第 3 章用命令行实际操作每一个工位。