4.3 音频滤镜:声音的整形与混音
4.3 音频滤镜:声音的整形与混音
本节摘要:音频滤镜处理的是采样点而非像素,最常见的三件事是调音量、混音、加延时与降噪。本节给出音量(volume)、混音(amix)、延时(adelay)、均衡(equalizer)的可运行命令,讲清单输入与多输入滤镜的分野。
学习目标
阅读完本节,你应当能够:
- 用 volume 精确控制音量,理解增益与分贝的关系
- 用 amix 把多路音频混成一路,理解混音与拼接的区别
- 用 adelay、equalizer 做简单的延时与均衡处理
一、场景代入:一段播客的诞生
假设你有一段采访录音,前半段嘉宾声音小、后半段突然爆音,背景还时不时有电流声。这在视频滤镜体系里是「几何变换」无论如何都解决不了的问题——因为处理对象根本不是画面。
音频滤镜处理的是采样点:连续的电压值序列。调音量是乘一个系数,混音是多个序列相加,延时是给序列「挪位置」。理解了对象是采样点,音频滤镜的行为就都说得通了。这也解释了为什么音频滤镜和视频滤镜要分开记:画面管像素,声音管采样,两者毫无交集。
二、核心原理:音频滤镜的三大类
1. 音量控制:volume
# 音量降低一半(约 -6 dB) ffmpeg -i input.mp4 -af "volume=0.5" output.mp4
volume 的值是线性增益倍数:1.0 是原音量,0.5 减半,2.0 翻倍。用分贝表达更直观:volume=6dB 表示 +6 dB(约 1.41 倍),volume=-6dB 减半。注意 dB 后缀必须写全,直接写数字按倍数解释。
工程取舍:音量只能调「范围」,调不了「忽大忽小」。要解决前段小声后段爆音,得用 dynaudnorm(动态范围归一化):
ffmpeg -i interview.mp4 -af "dynaudnorm=f=150:g=15" output.mp4
f 是帧长(毫秒,影响响应速度),g 是最大增益(dB)。它是「自动音量平衡」,适合让音量总体接近一个水平。
2. 混音:amix 与 amerge
混音 = 把多路音频同时播放叠成一路。场景:背景音乐 + 人声。
# 两路音频混成一路,输出时长取最长 ffmpeg -i voice.mp4 -i bgm.mp3 -filter_complex \ "amix=inputs=2:duration=longest:dropout_transition=2" -c:v copy output.mp4
参数拆解:inputs=2 声明两路输入;duration=longest 说输出多长(还可以 shortest 取最短、first 取第一路);dropout_transition=2 是某路结束后音量渐弱的秒数,避免「背景音乐戛然而止」。
混音 vs 拼接要分清楚:混音(amix)是同时叠加,拼接(concat)是先后衔接。播客场景常用混音把片头曲和人声叠一起。
3. 时间类与均衡类:adelay、equalizer
# 左声道延迟 500ms,右声道延迟 1000ms(立体声错位效果) ffmpeg -i input.mp4 -af "adelay=500|1000" output.mp4 # 削掉 60Hz 以下(常见的降噪第一步) ffmpeg -i input.mp4 -af "highpass=f=60" output.mp4
adelay=500|1000 用竖线分隔各声道延迟;highpass 高通滤波,只留 60Hz 以上的声音,能把低频哼声、电流声的一部分滤掉。要削高频噪声用 lowpass,要在某个频段做增减用 equalizer=f=1000:t=q:w=1:g=5(1000Hz 附近 +5 dB)。
三、工程实践要点
音视频滤镜链各管各的
一条命令里可以同时给画面和声音上滤镜,语法用 -vf 与 -af 分开:
# 画面加模糊 + 声音统一音量 ffmpeg -i input.mp4 -vf "boxblur=luma_radius=5:luma_power=1" \ -af "dynaudnorm" -c:v libx264 -c:a aac output.mp4
管线里视频帧走 -vf 链、音频帧走 -af 链,两条链并行,最后在封装时汇合——这正是第 4 章支柱页全景图的结构。
常见坑:采样率不一致
混音时两路音频采样率不同(48kHz 和 44.1kHz),amix 可能直接报错或产出爆音。解法是先把输入统一:
# 先把背景乐重采样到 48kHz,再混音 ffmpeg -i voice.mp4 -i bgm.mp3 -filter_complex \ "[1:a]aresample=48000[bg];[0:a][bg]amix=inputs=2:duration=longest" output.mp4
aresample=48000 把 bgm 转成 48kHz,命名的流再进 amix。「先统一再混合」是音频处理的第一原则。
用一张图总结音频滤镜的分类与典型用法:
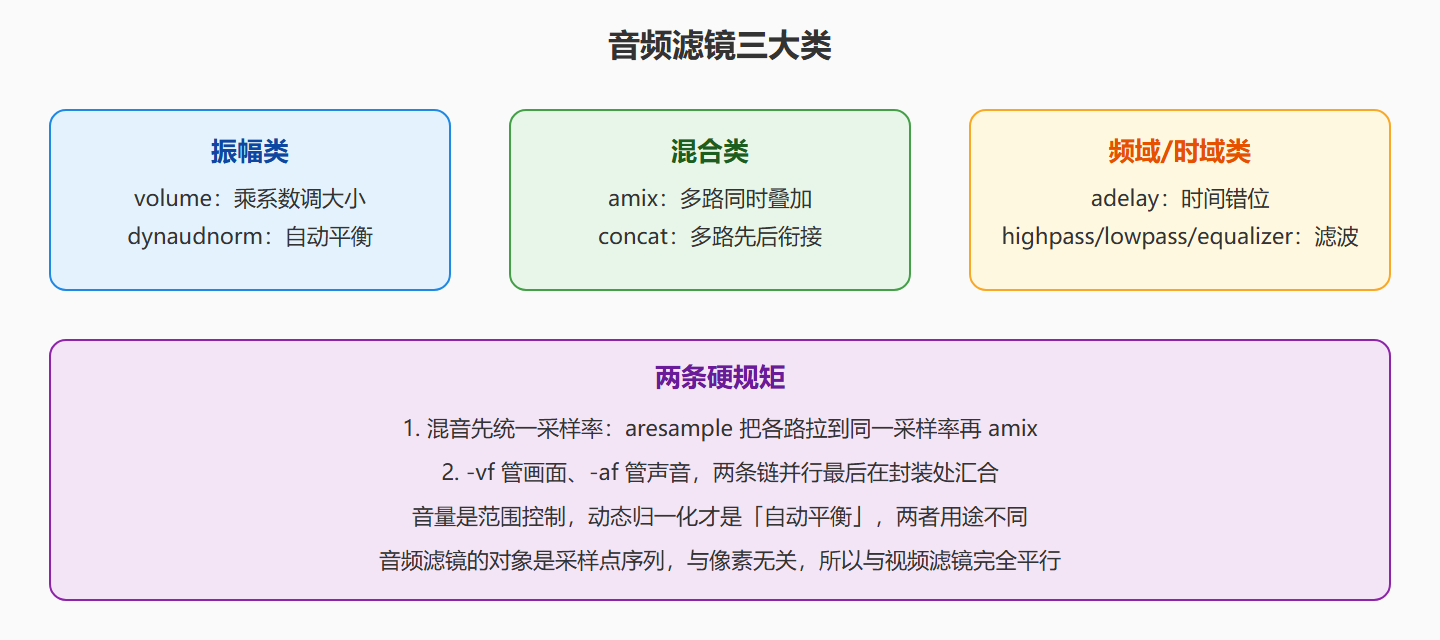
图说明:三类滤镜
振幅类处理「多大」,混合类处理「几路怎么叠」,频域类处理「哪些频段怎么调」。三类互不冲突,可以串成链,但注意顺序:通常先滤波再调音量,混音放最后。
⚠️ 常见坑:
volume=6dB里的 dB 后缀别丢;amix的输入采样率不一致会爆音;拼接用concat、叠加用amix,两个滤镜别混。音频处理完记得检查声道数是否变了(-ac 2强制立体声)。
💡 关键直觉:听到「爆音、失真」先查两个地方——增益是不是过了 1.0 附近、各路采样率是不是没统一。音频问题的根源多半在「数值」和「速率」上,跟画面滤镜完全不同。
要点回顾
- 对象是采样点:音频滤镜处理数值序列,与像素无关,与视频滤镜完全平行
- 音量三兄弟:volume 线性调、dB 后缀表示分贝、dynaudnorm 做自动平衡
- 混音先统一:aresample 统一采样率后再 amix,否则爆音
- 混音 vs 拼接:amix 同时叠加、concat 先后衔接,别混用
- 并行双链:-vf 与 -af 各管各的帧,最终在封装处汇合
下一节走到管线最核心的工位——编码,第 5 章看压缩的本质与参数怎么选。