9.2 监控安防:多路流的高并发处理
9.2 监控安防:多路流的高并发处理
本节摘要:监控平台要同时拉取几十上百路 RTSP 流并转码存储。本节讲清「多路拉流 → 硬解 → 分段存储」的架构,给出单路与多路的可运行命令,并剖析卡顿、掉流、时间戳空洞三个高频故障的排查思路。
学习目标
阅读完本节,你应当能够:
- 说出监控场景「拉流→转码→分段存储」的核心架构
- 写出单路拉流转存与多路并发处理的关键命令
- 排查监控流的卡顿、掉流、时间戳空洞三类问题
一、数字事实开场
一个中型园区监控系统,500 个摄像头,每路 1080p@25fps,7×24 小时不间断。这些数字意味着:同时几百路解码、每天几个 TB 的存储、任何一路的卡顿都要及时发现。监控和短视频是两种完全相反的工程形态——短视频是「峰值高、可排队」,监控是「持续高、不能停」。这决定了它必须用硬解、分段存储和稳定的拉流策略。
二、核心原理:监控链路的架构
单路处理
摄像头的流通常走 RTSP(第 6 章提过,监控领域事实标准)。单路「拉流→存储」是最小单元:
# 拉取一路 RTSP,分段存成 10 分钟一个的 MP4 ffmpeg -rtsp_transport tcp -i rtsp://user:pass@cam_ip:554/stream \ -c copy -map 0 -f segment -segment_time 600 -reset_timestamps 1 \ cam_%03d.mp4
参数解读:
-rtsp_transport tcp:用 TCP 拉 RTSP(默认 UDP,易丢包花屏;局域网用 TCP 更稳)-f segment -segment_time 600:分段输出,每段 10 分钟-reset_timestamps 1:每段重置时间戳,否则每段的起始时间会延续前段
多路并发
500 路如果一路一个进程,机器根本扛不住。正确思路是「硬解 + 尽量 copy」:
- 能 copy 就 copy:存储用途可以直接
-c copy存原始流,省掉全部转码 - 要转码才硬解:只有需要降分辨率、改编码时,才上
-hwaccel(第 7 章) - 进程按核分配:每进程处理 N 路,N 按解码能力实测,别贪多
分段存储的意义
分段存储(segment)有三个好处:
- 断流恢复:某段写坏不影响其他段
- 回放定位:按时间段找文件,比找一个大文件快
- 磁盘管理:可以按策略删除过期段
三、工程实践要点
故障一:画面花屏或马赛克
优先排查传输:
# 强制 TCP 拉流,规避 UDP 丢包 ffmpeg -rtsp_transport tcp -i rtsp://... -c copy out.mp4
局域网摄像头首选 TCP;跨公网拉流丢包严重时,考虑 SRT(第 6 章)或加传输缓冲。
故障二:频繁掉流
排查顺序:网络稳定性 → 摄像头并发限制 → 拉流重试。
# 掉流自动重试:脚本循环,断线立即重启拉流 while true; do ffmpeg -y -rtsp_transport tcp -i rtsp://cam1/stream -c copy out.mp4 \ || echo "retrying..." && sleep 3 done
很多摄像头有「并发连接上限」,被拉流超过上限会主动断。控制每路的拉流端数量,是监控平台必修课。
故障三:时间戳空洞
分段重置时间戳后,如果某段中间断流几秒,视频时间轴会出现「跳秒」。排查时用 ffprobe 看时间戳连续性:
ffprobe -v error -show_entries frame=pts_time -of csv=p=0 seg_001.mp4 | awk 'NR>1 && $1-prev>0.5 {print "GAP at", $1} {prev=$1}'
输出连续两帧间隔大于 0.5 秒的位置,就是断流造成的时间空洞。这类问题要么接受、要么在存储层用「填充」策略补平。
架构一图流
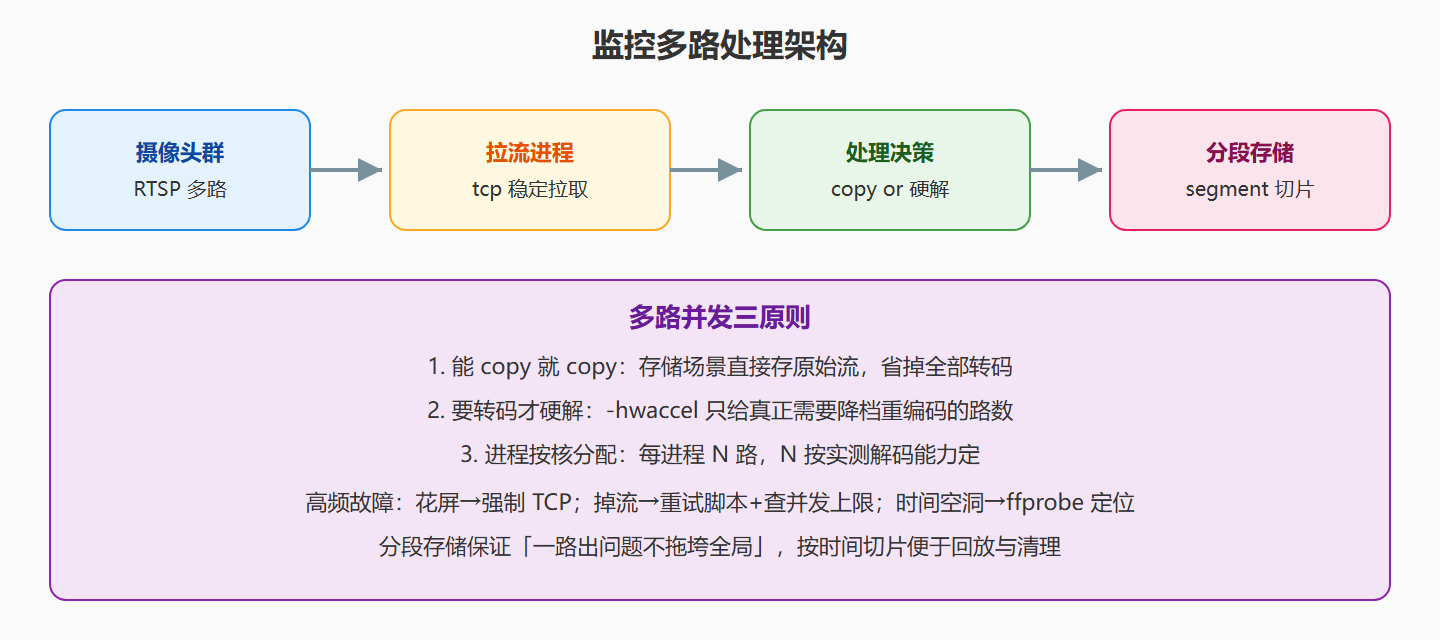
图说明:四段链路与三原则
摄像头群 → 拉流进程 → 处理决策 → 分段存储。三原则决定「每路怎么处理」:省计算靠 copy、转码靠硬解、调度靠实测。高频故障的三个排查点对应各自的命令手法。
⚠️ 常见坑:RTSP 默认走 UDP,局域网偶发丢包就花屏,先试
-rtsp_transport tcp;忘了-reset_timestamps 1,分段文件的起始时间戳会叠加导致回放定位错乱;「一路一个进程」的朴素方案在几十路时就会把机器拖垮。
💡 关键直觉:监控架构的核心是「让每路流尽量不经过转码」。转码是计算大户,能 copy 的流直接进存储,把 GPU/CPU 留给真正需要处理的路数——这就是监控平台压成本的底层逻辑。
存储策略:要多少天、多少清晰度
监控存储的成本通常远超处理成本,存储策略直接决定预算。常规做法是按时间分层:最近 7 天保留全分辨率原码流,7 天到 30 天压缩到低分辨率(720p),30 天以上的只保留运动检测触发的时间段。
# 离线归档:把 1080p 原始录像转成 720p 低码率存档 ffmpeg -i cam_day1.mp4 -vf "scale=-2:720" -c:v libx264 -crf 28 -an archive_720.mp4
-an 去掉音轨(监控画面多数不需要声音),-crf 28 压到较高压缩比。这样的归档文件通常只有原来的四分之一到五分之一。存储分层的关键是「分级清晰、自动执行」——让脚本每天定时跑归档任务,而不是等磁盘满了再手工清理。
要点回顾
- 核心架构:拉流(TCP)→ 处理决策(copy/硬解)→ 分段存储
- 单路命令:-rtsp_transport tcp + -c copy + segment 分段 + -reset_timestamps
- 三原则:能 copy 就 copy、要转码才硬解、进程按实测核数分配
- 三个故障:花屏→TCP;掉流→重试与并发上限;时间空洞→ffprobe 定位
- 分段存储:隔离故障、便于回放定位、支持过期清理
下一节给管线装上仪表盘——质量评估与流健康监控。