4.4 面积与功耗优化
4.4 面积与功耗优化
本节摘要:时序收敛之后,设计要在"面积(资源)、功耗、性能"三个方向上做取舍。本节讲面积优化(资源共享、逻辑化简、位宽裁剪)与功耗优化(时钟门控、频率规划、PLL 分频)的常用手段,最后给出一张三维权衡图,帮你理解为什么"省面积"和"降功耗"常常彼此冲突,以及工程上如何选择侧重点。
一块芯片的账:资源、功耗、性能
先看一组数据。FPGA 的功耗大致分两类:静态功耗(芯片通电就耗,与工作负载无关,主要来自漏电)和动态功耗(工作时切换逻辑和连线产生的,正比于信号翻转率和频率)。动态功耗通常占大头,而且有一个简单的经验规律:翻转变多的逻辑、跑得越快的时钟,耗电越多。这意味着"优化功耗"和"优化性能"天然对着干——性能要快,功耗要省,两者抢的是同一种资源。
面积则是另一个维度:芯片资源固定(LUT、FF、BRAM、DSP 就那么多),省下面积要么能塞更多功能,要么能让布局布线更宽松(4.2 讲过布线宽松对时序的帮助)。所以面积优化不只是"抠门",它还间接改善时序。
面积优化三件套
资源共享:用选择器换大运算单元
同一段逻辑在互斥分支里重复出现时,工具可以合并——这是 3.1 提过的"工具自作主张"之一。但工具做得不够彻底时,你可以显式引导:
// 优化前:两个乘法器,sel 二选一输出 always @(*) begin if (sel) y = a * c; else y = b * c; end // 优化后:一个乘法器,输入用选择器切换,省一个 DSP wire [15:0] mul_in = sel ? a : b; assign y = mul_in * c;
代价是选择器多了一级组合延迟。吞吐要求不高、资源紧张时,资源共享是首选;反过来,资源宽松、时序紧张时,共享反而把选择器插进关键路径,得不偿失。
逻辑化简:让工具少干活
有时候"面积大"的根源是代码写出了冗余逻辑。case 分支里大量重复的输出、没用到的比较位、无谓的宽位运算,都会让工具白费资源。先用工具报告定位"哪些模块吃掉最多 LUT",再看代码有没有化简空间。常见手法:位宽裁剪——只需要 8 位的计数就别写 16 位,每根触发器都要钱;去掉不可能分支——状态机的非法状态合并进 default,别给每个非法组合单独建分支。
复用与参数化:从结构上省
把公共逻辑提成参数化模块(3.1 的 param_fifo 思路),用生成语句按需实例化,比复制粘贴 N 份省心也省资源。这一条在工程管理层面价值大于单纯面积,但确实避免"同一功能被实现两次"的隐性浪费。
功耗优化三条路
时钟门控:别让没事干的逻辑翻
动态功耗正比于翻转率,而没有时钟沿,触发器就不翻转。时钟门控的思想:逻辑暂时不用时,把它的时钟"关掉"。FPGA 里有专用的时钟使能结构(CE 端口),正确用法是让使能信号控制功能块,而不是手动改时钟——这正好呼应 2.2 的纪律"分频不要造时钟",用使能表达节拍,顺便拿到功耗收益。
频率规划:能慢就慢
功耗与频率线性相关:同样的逻辑,跑 200MHz 的功耗是 100MHz 的两倍。所以工程上有个反直觉的省法:别让所有模块都跑在最高频上。低吞吐模块单独用低速时钟域,只有关键路径跑高频。PLL 分频设计在第 6 章 SoC 里会用到——把每个模块配到"恰好够用"的频率,功耗能省下来一截。
数据通路设计:减少无效翻转
一个更细的层面:信号在数据无效时仍然翻转,也在耗电。典型例子是总线空闲时的高位抖动。通过使能信号把"无意义数据"锁住,或用数据有效标志屏蔽下游翻转,能省掉一部分动态功耗。这类优化收益不大但积少成多,适合功耗预算卡得死的产品。
面积、功耗、性能的三角
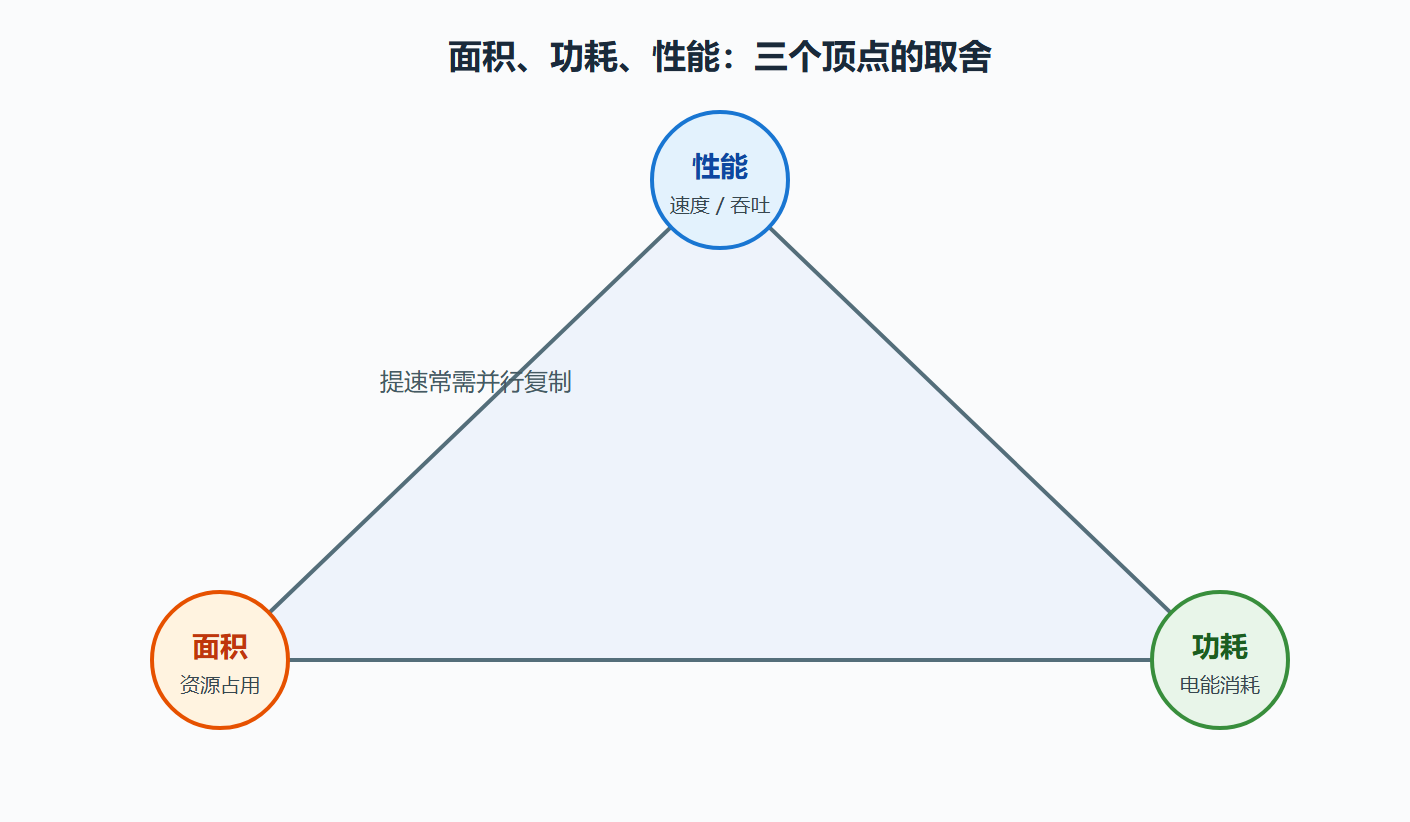
这张三角图是本节的核心结论:任何优化都是在移动三角形的顶点。提高性能常要复制逻辑(面积↑)或提频(功耗↑);省面积靠共享复用(延迟↑);降功耗靠降频降翻转(性能↓)。没有免费的优化,只有"这个项目更看重哪头"的选择。产品定义阶段先定优先级,实现阶段才有取舍依据。
优化的顺序纪律
给一个实际的执行顺序建议:
- 先正确,后优化:功能没稳定就做面积/功耗优化,是最常见的浪费时间方式。优化的代码更难读、更难验证,等 bug 都清完再动。
- 用报告驱动:面积优化先看资源报告找大户,功耗优化先看功耗估计报告找热点,别凭感觉猜。
- 一次只动一处:多处优化同时上,出了问题分不清谁引入的。每改一处跑一次验证,保证没有回归。
- 留余量:把优化指标定在"刚好满足"之下——工具跑出的数字和实测还有差距,别卡着线设计。
一次功耗优化的实测复盘
背景:一个便携设备里的 FPGA,功耗预算吃紧,目标是把动态功耗压下来 30%,同时保持功能和帧率不变。设备里主要耗电大户是一个视频缩放模块,长期满负荷工作。
操作:先看功耗估计报告,确认两个大头:视频缩放逻辑(占动态功耗约 45%)和片内 BRAM 的读写活动(约 25%)。第一刀下在频率规划:缩放模块原本跑在 150MHz,实测它处理的视频流只需要 75MHz 的吞吐——通过 PLL 分频,把它降到 75MHz 单独时钟域,动态功耗直接减半(功耗与频率线性相关)。第二刀下在数据通路:把缩放算法里的中间缓存从"每帧都刷新"改成"数据有效才刷新",无效周期不翻转,又省了一截。
结果:两刀下去,动态功耗降了约 35%,超过目标。验证结果:视频输出帧率不变、图像质量无差异(用仿真和上板双重确认),唯一代价是多了一个 75MHz 时钟域要约束和维护。
解读:这次优化的关键是先看报告找热点,再对症下药。频率规划那刀收益最大,因为它是"结构性"的——从源头减少翻转,而不是在细节上抠门。如果上来就抠逻辑细节,可能忙活半天只省 5%。
变式:同样的思路可迁移到任何"长时间满负荷"的模块——总线桥、加密引擎、图像处理链。先问"这个模块真的需要这么高的频率吗",再问"能不能少翻转",这两个问题答完,功耗大头基本就解决了。
⚠️ 常见坑:为了省几个 LUT 把代码写成一团乱麻,结果验证成本远超省下的资源。优化的前提是可读、可验证,这比省 5% 面积重要得多。
本节要点回顾
- 动态功耗正比于翻转和频率:降频、降翻转是降功耗的根本方向。
- 资源共享用选择器换乘法器:省面积,但延迟和时序要还债。
- 位宽裁剪与逻辑化简:让工具少干活,面积自然下来。
- 时钟门控与频率规划:能慢就慢、能关就关,功耗省得最直接。
- 三角无免费:性能、面积、功耗只能同时要两个,优先级在需求阶段就定。
- 优化纪律:先正确后优化、报告驱动、一次一处、留余量。
下一步进入第 5 章:地基、墙体、时序全部就位,开始"封顶"——高速串行收发器与 DDR 存储接口,把数据通道真正跑起来。