8.1 数字信号处理:DSP
8.1 数字信号处理:DSP
本节摘要:数字信号处理是 FPGA 最老牌的主场——通信基带、雷达、音频、医疗成像都靠它。本节从 FIR 滤波器讲起,把"实时滤波"拆解成乘法器阵列加流水线的硬件结构,再上 FFT 的蝶形运算与数字下变频,理解 FPGA 在信号链里"每样本实时处理"的独门价值。
乘法器是 DSP 的发动机
信号处理的数学骨架,绕不开两个运算:乘(加权、相关、卷积)和加(累加、求和)。FIR 滤波器、FFT、数字下变频、通道均衡——拆到底都是"乘加"的排列组合。所以 DSP 应用的第一步,永远是问:我手里的乘法器够不够、快不快。这就是 1.2 讲过的 DSP 切片(硬核乘法器)的价值所在:一个中端 FPGA 有几百个 DSP 切片,每个都能在一个时钟周期内完成一次乘法,配合流水线,每秒能跑出几千亿次乘加。
软件处理器处理信号的瓶颈在于"串行":样本一个个进,乘法一个个做。FPGA 的答案是把"算法形状"直接刻进电路:每个样本一进来,所有乘法同时发生——这就是"并行 + 流水"的硬件信号处理。
FIR 滤波器:最直观的流水线案例
FIR(有限脉冲响应)滤波器做的事很朴素:当前输出是最近 N 个输入样本的加权和。写成公式是 y[n] = sum(h[k] * x[n-k]),其中 h 是滤波器系数。它在通信、音频里无处不在——去除噪声、整形信号、匹配滤波。
软件实现:循环累加 N 次乘法。硬件实现:把 N 个乘法器摆成一排,样本流过时每个乘法器同时算一项,流水线把累加串起来。数据像流水一样流过这条"乘加链",每时钟周期吞吐一个样本,延迟固定、吞吐恒定。
FIR 流水线结构
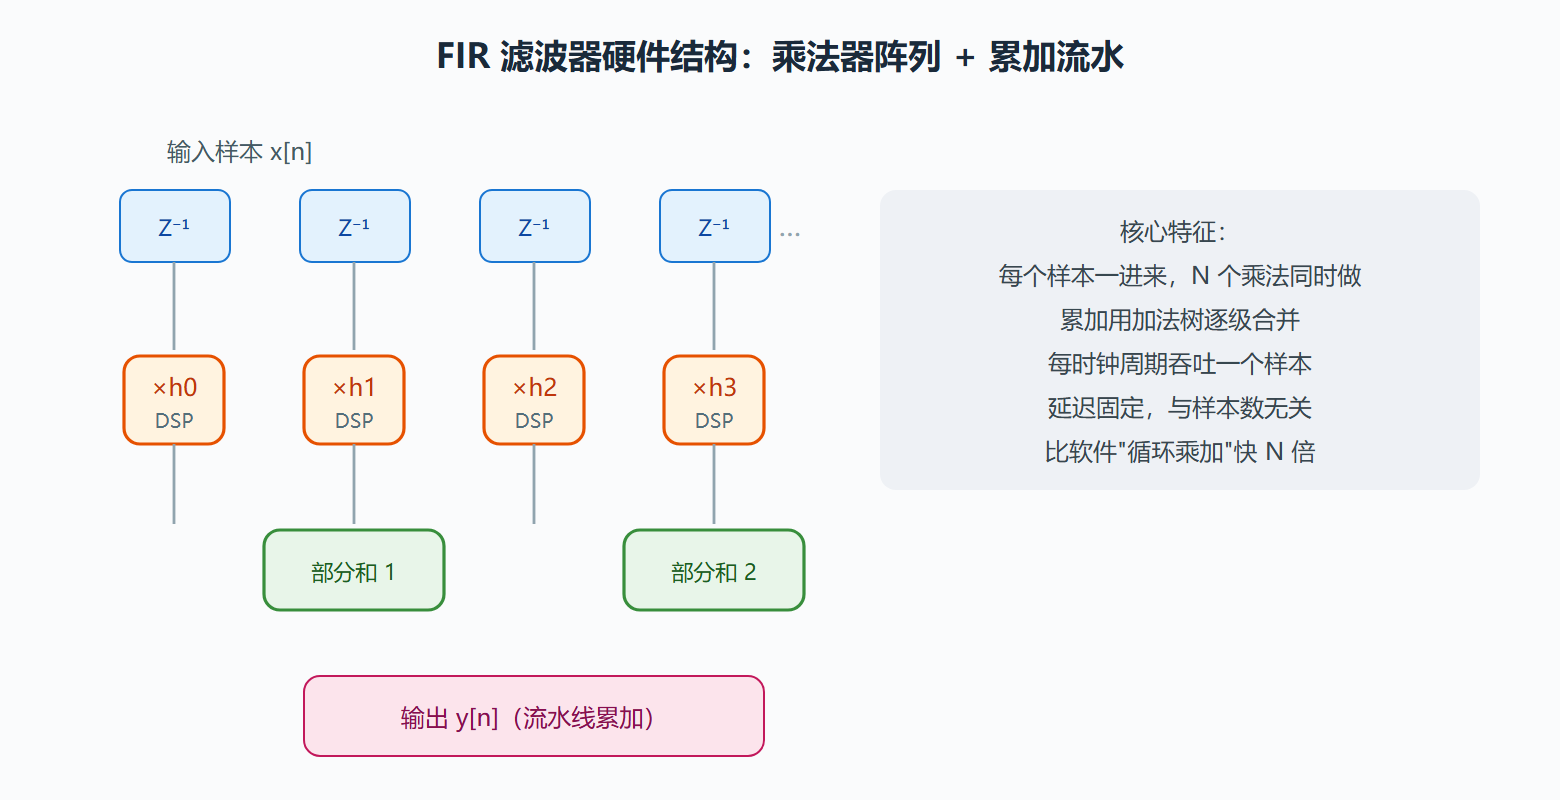
这张图是 FPGA 信号处理的"图腾":流水线深度决定处理速度,DSP 切片数量决定并行度。FIR 滤波器把这两件事的账算得明明白白——同样的滤波器,软件要 N 次串行乘加,硬件一帧全并行。这正是通信基带选择 FPGA 的原因:数据是连续流,必须"每个样本实时处理",不允许排队。
FFT 与数字下变频:进阶组合
FFT(快速傅里叶变换)把时域信号变到频域。它的计算核心是蝶形运算(两个复数加减乘的组合),N 点 FFT 有 N/2 × log2(N) 次蝶形。FPGA 实现 FFT 有成熟的 IP:把蝶形处理器流水化,或者把多级蝶形并行展开。雷达测距、频谱分析、OFDM 解调全依赖它。工程上没人手写 FFT——用厂商 IP 配参数(点数、位宽、流水模式),这是 IP 复用的标准范例。
**数字下变频(DDC)**是通信接收机的地基:把中频信号搬到基带。流程是混频(乘本地振荡信号)→ 低通滤波(FIR 的用武之地)→ 抽取(降采样)。这条链路在 FPGA 里就是"DSP 切片 + 滤波器 + 计数器"的组合,是教科书级的 FPGA 信号链案例。
一个完整案例:音频降噪的 FIR 落地
用一个小而完整的例子,把"滤波器系数 → 资源估算 → 上板验证"的链路走通。
背景:一段音频信号混入了高频噪声,要设计一个低通 FIR 滤波器把噪声滤掉。采样率 48kHz,通带 0~10kHz,阻带 12kHz 以上。用设计软件算出系数,发现需要 32 阶(33 个系数)才能满足带外抑制要求。
操作:拿到系数后先做三件事——把浮点系数转成定点(Q 格式,这里选 16 位小数精度)、按 8.1 的结构画流水线(33 个乘法器 + 加法树)、估算资源(33 个 DSP 切片,中端 FPGA 轻松满足)。然后在仿真里喂一段含噪声的音频样本,对比输入输出波形,确认滤波效果与软件模型一致。
结果:仿真通过后上板实测,滤波后的音频噪声明显降低,流水线每周期吞吐一个采样点,48kHz 的音频数据量只占了不到 1% 的处理能力——余量绰绰有余。
解读:这个案例暴露了一个工程真相:DSP 项目的难点不是"实现滤波器",而是"把算法约束翻译成硬件参数"。系数定点化损失多少精度、加法树中间结果位宽取多少、要不要在 FIR 前加抽取降采样,这些决策直接决定资源与音质,而且必须靠仿真验证边界——这正是"位宽与精度"那节的核心。
变式:把 FIR 换成 IIR(反馈型,阶数低但稳定性要小心)、把低通换成带通/高通(系数不同结构相同)、把音频换成基带 IQ 信号(两组 FIR 并行)——骨架不变,变的是系数与位宽。这套"先建模仿真、再映射硬件、最后验边界"的流程,适用于几乎所有 DSP 设计。
位宽与精度:DSP 的隐藏工程
软件里浮点随便算,硬件里每个小数点都要花钱。DSP 设计的精度策略:
| 精度方案 | 位宽开销 | 适用 |
|---|---|---|
| 定点整数 | 最省 | 大部分基带与图像处理 |
| 定点小数(Q 格式) | 省 | 需要小数的滤波与增益 |
| 浮点 | 大(DSP 切片吃不消) | 科研、低吞吐 |
| 块浮点 | 中 | FFT 等动态范围大的运算 |
工程惯例是定点为主:提前算好数据的动态范围,选足位宽防溢出,中间过程注意截断与舍入。位宽选多了费 DSP,选少了溢出丢数据——这个平衡要靠仿真验边界。
问题:DSP 切片不够用怎么办
问:设计需要 400 个乘法器,芯片只有 200 个 DSP 切片,怎么破?答:按代价从小到大排四招——查资源报告确认没被浪费(有没有把简单乘法误映射到 DSP、有没有可以共享的互斥乘法);改算法降乘法数(滤波器的对称系数、FFT 的旋转因子复用,都能减一半量);用分布式逻辑补缺口(小位宽乘法用 LUT 拼,速度要求不高时可行);上分时复用(多个数据流轮流用一个 DSP,吞吐折半但资源减半)。判断顺序很重要:先确认需求(真需要那么多并行吗),再改算法,最后才考虑复用时序——很多"资源不够"其实是位宽和结构没优化好。
⚠️ 常见坑:把浮点照搬进 FPGA。浮点乘法一个就要吃掉好几个 DSP 切片,吞吐和资源双双爆表。先把算法转定点,是 DSP 落地 FPGA 的第一道工序。
本节要点回顾
- 乘加是发动机:FIR、FFT、DDC 拆到底都是乘加,DSP 切片是硬件加速器。
- 实时处理是命门:样本流式进入、每周期吞吐一个,是 FPGA 相对软件的核心优势。
- FIR 即流水线:乘法器阵列 + 加法树,延迟固定、吞吐恒定。
- FFT 用 IP:蝶形运算流水化,工程上配参数不复写轮子。
- 精度走定点:浮点吃 DSP,定点省资源,动态范围先算清。
- 信号链是组合拳:混频、滤波、抽取按需组合,就是完整的基带处理。
下一步进入 8.2:信号处理是基本功,AI 加速是当下风口——数据中心与边缘推理里的 FPGA 机会。