4.4 流缓冲区与消息缓冲区:字节流的高速车道
4.4 流缓冲区与消息缓冲区:字节流的高速车道
本节摘要:队列搬运定长元素,但两类高频需求它伺候不好——连绵不断的字节流(串口接收、音频采样)与长短不一的消息(日志行、协议帧)。流缓冲区以"单写者单读者"的架构假设换来无锁高速,触发级机制把唤醒频率变成可调参数;消息缓冲区在它之上保住消息边界。本节讲清两者的结构、触发级的调参逻辑、架构假设被打破时的补锁方法与使用禁区,并用一个串口接收通路完成实战。
本章至此的原语都在"通用安全"上花成本:队列有临界区与两条链表,信号量内部是队列结构。但有一大类场景天生简单——数据只有一个生产者、一个消费者,比如串口中断往里倒字节、解析任务往外取。既然只有两方,竞争格局固定,锁的绝大部分工作可以省掉。流缓冲区就是为这个判断设计的:用架构约束换性能。
一、为什么队列不够用
用队列接串口字节流,会遇到三重不适配。其一,元素边界是假的:字节流没有"一个元素"的概念,硬按一字节进队,接收端拿到的边界毫无意义;按帧进队,帧长不定,深度与元素大小都定不下来。其二,唤醒太频繁:每字节一次入队,一毫秒几十字节的流量就是几十次系统调用与几十次唤醒判断——税负重得离谱。其三,内存浪费:队列按"深度乘元素大小"预分配,字节流的峰值不可预测,要么留大余量要么冒溢出风险。
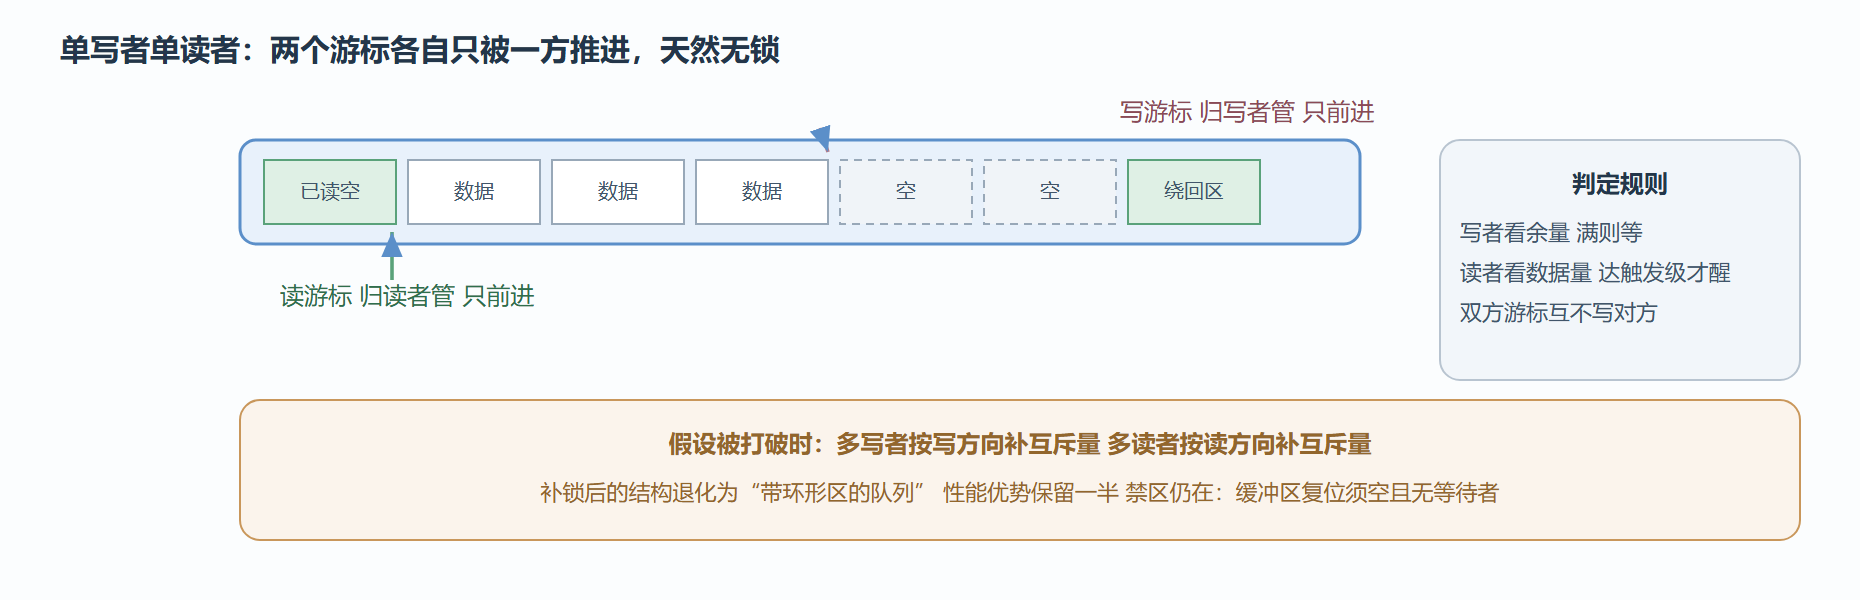
流缓冲区把模型换掉:内部是一块环形字节区加读写两个游标,写入方写任意长度,读取方按需取走——数据没有边界,只有先后。想保边界?上层再叠消息缓冲区(它把"长度头加载荷"整体写入,读出时按头还原边界)。两个缓冲区一层管流、一层管帧,各司其职。
二、触发级:唤醒频率的旋钮
流缓冲区创建时除了总容量,还要声明一个触发级:读取方被唤醒的最低数据量。触发级为一,每来一字节都可能唤醒读取任务(低延迟、高唤醒频率);触发级为八,攒够八字节才唤醒(高吞吐、唤醒次数降为八分之一)。这个参数是延迟与开销之间的旋钮,按业务调:交互式命令行要"键入即响应",触发级为一;批量数据搬运要吞吐,触发级往大了调。写入方的行为则不受触发级影响——写满才阻塞,超时参数管等待空位的耐心。
/* 串口接收通路:中断写入流缓冲区,解析任务按行取出 */ StreamBufferHandle_t xUartRx; void init_uart_path(void) { /* 容量一KB,触发级一:命令行要即时回显 */ xUartRx = xStreamBufferCreate(1024, 1); } void UART_IRQHandler(void) { BaseType_t woken = pdFALSE; uint8_t chunk[8]; size_t n = uart_read_fifo(chunk, sizeof chunk); /* 有多少读多少 */ xStreamBufferSendFromISR(xUartRx, chunk, n, &woken); portYIELD_FROM_ISR(woken); } void parser_task(void *arg) { char line[96]; size_t used = 0, got; for (;;) { got = xStreamBufferReceive(xUartRx, line + used, 1, portMAX_DELAY); used += got; if (used && line[used - 1] == '\n') { handle_line(line, used); used = 0; } else if (used == sizeof line) { handle_overflow(line, used); /* 超长行保护:截断并记错 */ used = 0; } } }
这段实现里有三个值得咀嚼的细节。中断侧有多少读多少、一次写入,把唤醒判断集中到一次调用;解析任务逐字节取在命令行场景成立(触发级为一),若换成定长帧就该按帧长批量取;超长行保护不能省——没有边界的流必须有上限护栏,否则一行超长输入就能把解析任务的栈撑爆(2.4 节的教训在数据通路里同样成立)。
环形区与双游标的无锁协作
三、消息缓冲区:给流装上边界
消息缓冲区在流缓冲区之上只加了一层协议:发送方写入"长度头加载荷",接收方先读头、按头读载荷——边界由此保住,消息长短随意。用法上与队列的差别一句话说清:队列是定长槽位,消息缓冲区是变长信封。日志系统是它的标准舞台:一条日志几字节到几百字节不定,用队列要么截断要么浪费,用消息缓冲区原样进出。
MessageBufferHandle_t xLogs; void log_task(void *arg) { char buf[160]; for (;;) { size_t len = xMessageBufferReceive(xLogs, buf, sizeof buf, portMAX_DELAY); if (len > 0) { uart_write(buf, len); } } } /* 任意任务侧:格式化后整条投递 */ void log_submit(const char *fmt, ...) { char line[160]; int n = vsnprintf(line, sizeof line, fmt, /* 参数 */); if (n > 0) { xMessageBufferSend(xLogs, line, (size_t)n, pdMS_TO_TICKS(5)); } /* 短超时:日志堵不住业务,堵了就丢这一条 */ }
两处工程取舍值得注意:发送方短超时加丢弃(日志是尽力而为的业务,不能反过来阻塞业务任务);缓冲区容量按"峰值消息数乘平均长度"估算,超长单条消息(超过接收方缓冲区容量)会被拒收——所以接收缓冲区的大小要参照系统里最长的合法消息。
四、禁区与补救
流与消息缓冲区的能力来自架构假设,假设之外就是禁区。多写者:两个中断同时往一个流缓冲区写,游标推进互相踩踏,数据交叠损坏——要补一个写方向的互斥量(任务间)或把写方收敛到单一任务。多读者:两个任务同时读,同一段数据被瓜分,消息边界彻底崩溃——读方向同样补锁,或架构上规定唯一消费者。复位接口:只能在缓冲区空且无等待者时调用,否则直接失败——它本来就不是给运行中通路用的。跨核共享:多核构建下双游标操作需要额外的核间保护(内核提供配套说明),单核假设在这里要重新审视。
| 通路 | 元素形态 | 边界 | 多对多 | 典型场景 |
|---|---|---|---|---|
| 队列 | 定长元素 | 天然 | 支持 | 结构化数据、控制命令 |
| 流缓冲区 | 任意字节 | 无 | 禁止 | 串口、音频、采样流 |
| 消息缓冲区 | 变长消息 | 头部保界 | 禁止 | 日志、协议帧、跨核消息 |
💡 判断"该不该用这族原语"只需一个问题:这条通路是否从结构上保证单写者单读者?是——用它们,性能与内存双赚;否——要么补锁(收益减半),要么回到队列(通用安全)。不要在多写者的通路上裸奔使用,损坏的字节流比丢失的数据难查一个数量级。
本节要点回顾
- 队列的三重不适配:假边界、高唤醒、定长浪费——字节流与变长消息需要专用车道;
- 流缓冲区单写单读无锁:环形区加双游标,各自只被一方推进;触发级是延迟对开销的旋钮;
- 消息缓冲区等于流加长度头:变长信封进出,接收缓冲须容下最长合法消息;
- 三道护栏不能省:超长输入截断、发送短超时丢弃、容量按峰值估算;
- 禁区三条:多写者、多读者、运行中复位——结构假设破了就要补锁或换队列;
- 选型问结构不问性能:单写单读是前提,不是优化目标。
第 4 章到此收官:搬数据的、占资源的、对齐的、点对点的、流式的五类通路全部备齐。下一章走进系统里最脆弱的角落——内存:五种堆方案的取舍、碎片如何随时间生长、以及把分配失败挡在上线之前的工程手段。