8.1 常见坑点系统排查:症状到病灶的路径
8.1 常见坑点系统排查:症状到病灶的路径
本节摘要:全册讲过的故障模式散落在各章,本节把它们编成体系:一张排查总流程(取证包先行、症状分类、五区索引、按验证成本递增逐层确认)、一张五区坑点分布地图(配置、中断、内存、时序、通信,每区标注第一名嫌犯与确认手段)、一张症状到嫌疑的速查表。最后用一个新工单走完全流程示范。读完这节,你面对陌生故障时不再依赖灵感,而是执行算法。
前七章的每张工单都在教"怎么确认一个已知嫌疑",本节解决前置问题:陌生工单进门,嫌疑名单怎么列、怎么排序、怎么用最便宜的验证手段逼近。排查能力的本质是逼近算法的质量。
一、总流程:从取证包到病灶确认
标准流程六步,纪律比步骤本身更重要。第一步,读取证包(7.3 节定义的格式:故障寄存器、复位原因、任务快照、堆画像、版本与配置摘要)——没有取证包的现场先补齐观测再复现,这一步省下的时间会在后面加倍还回来。第二步,症状归类:把用户语言翻译成时序语言("偶尔卡一下"是延迟尖峰,"莫名重启"是复位或看门狗,"数字不对"是数据损坏或丢失)。第三步,查速查表列嫌疑清单。第四步,按验证成本从低到高逐个排除——便宜的先做,贵的后做。第五步,病灶确认后修复并做回归(修复必须附带防复发手段:断言、巡检或文档)。第六步,归档进团队坑点库——工单关闭的标志不是修好,是下次同类工单能在五分钟内定位。
验证手段的成本排序,从低到高:读已有日志与取证包(零成本)→ 读水位与统计面板(一条命令)→ 加临时观测脚与 GPIO 翻转(一次编译烧录)→ 开追踪录制窗口(配置切换)→ 上示波器逻辑分析仪(设备与接线)→ 仿真器单步(最贵,且会改变时序)。排序的用途是纪律:任何跳级操作都要有理由——跳过便宜手段直接上仿真器,是新手最常见的时间黑洞。
二、五区分布地图:嫌疑按区域报到
全册的坑点按病理解剖位置分五个区,每区有自己的惯犯。
五区坑点地图
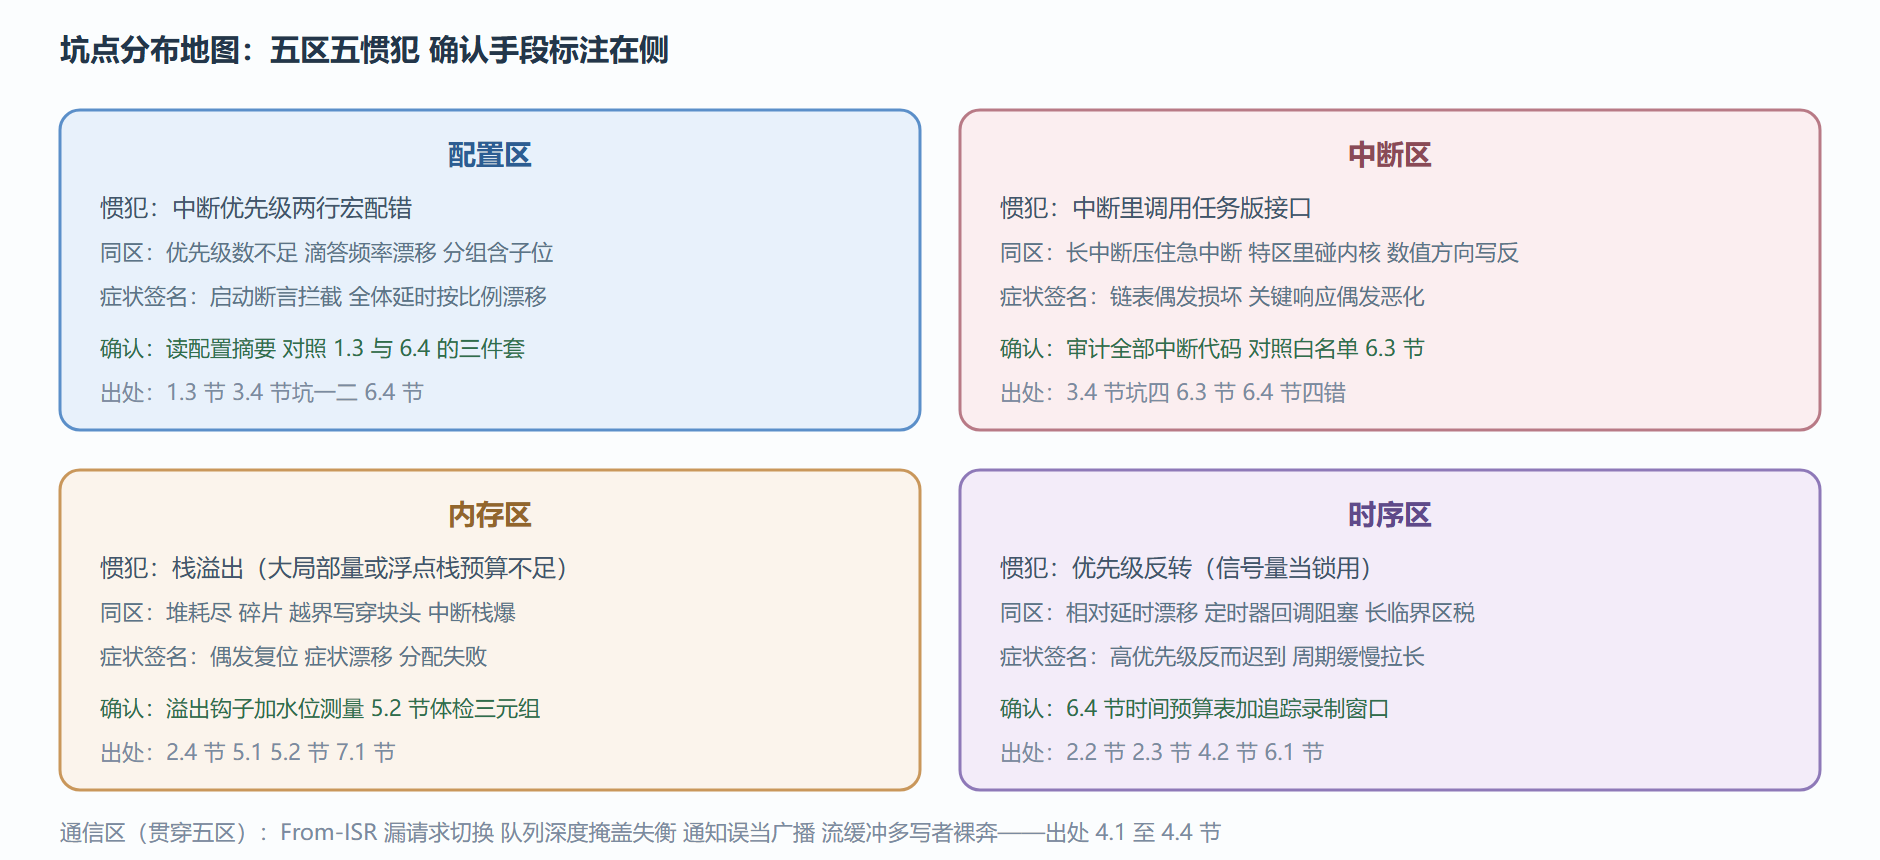
地图的用法不是背诵而是索引:症状签名对上哪个区,就把该区的惯犯排进嫌疑清单前两名。五区的排序也有讲究:配置区最便宜(读配置就能确认)、内存与时序区中等(要测量)、中断区最隐蔽(代码审计加实测)——嫌疑排序时同分情况下便宜的区靠前。
三、症状速查表
| 症状(用户语言) | 时序语言 | 首查区 | 次查区 |
|---|---|---|---|
| 偶发重启或死机 | 复位或看门狗或硬故障 | 内存区 | 中断区 |
| 偶尔卡一下再恢复 | 延迟尖峰 | 时序区 | 中断区 |
| 最急的功能反而慢 | 高优先级响应超标 | 时序区(反转) | 中断区(长中断) |
| 计数偶尔少加 | 丢失更新或事件丢失 | 通信区 | 中断区(漏切) |
| 数据偶发错乱 | 内存损坏 | 中断区(裸调接口) | 内存区(越界) |
| 所有延时都不准(成比例) | 时基漂移 | 配置区 | 配置区 |
| 跑得越久越慢 | 资源泄漏或碎片 | 内存区 | 时序区(负载爬升) |
| 换了批芯片就出事 | 移植与配置差异 | 配置区 | 中断区 |
速查表给的是起点不是终点——它把五分之四的搜索空间排到后面,剩下的靠逐层验证收敛。两个使用心得:先查最近改过什么(版本差异是最高效的嫌疑生成器,取证包里的版本字段为此服务);偶发类问题优先怀疑"无防护的共享"(裸调接口、无锁共享、越界——确定性 bug 早被功能测试抓完了,能活到现场的偶发 bug 几乎都出自时序相关的无防护路径)。
四、示范:一张新工单走完全流程
工单:客户反馈"设备每晚八点左右失去响应,第二天早上自动恢复"。第一步读包:无硬故障记录,复位原因是看门狗之外的"正常运行"——设备没死,是"不响应"。任务快照(故障前的最后一次上报)显示网络任务的栈水位两字,堆画像正常。第二步归类:"不响应但活着"= 心跳类任务在跑、通信类任务卡死。第三步列嫌疑:内存区(栈水位贴线,高嫌疑)、时序区(晚上八点是业务高峰,负载相关的阻塞?)、通信区(队列满导致的长阻塞)。第四步按成本验证:先查水位(复现高峰负载压测,水位没有再降——排除栈);再看统计面板高峰期数据(网络任务占比骤降为零——它在睡);定位到它睡在哪个接口:一次带无限期等待的接收调用,而对方任务的队列在高峰期被挤爆后再无人投递。第五步修复:无限期等待改为长超时加重连状态机,队列深度按高峰过载窗口重算。第六步归档:坑点库新增条目"无限期等待加对端停投递=永久卡死",挂到通信区。全流程用时不到两小时,其中取证包贡献了方向、统计面板贡献了定位——观测体系的复利兑现。
💡 坑点库的维护纪律:每条记录五要素——症状签名、病根、确认手段、修复处方、出处章节。没有"出处"的记录无法回炉学习,没有"签名"的记录检索不到——两者缺一,记录就是死档案。团队每季度把新工单与库内条目对账,命中率就是排查体系的效果指标。
五、排查的准备:功夫在工单之外
流程再好,也需要平时备好的四样东西,缺一样都会在关键时刻掉链子。其一,取证包常驻——观测桩位随固件出厂(7.3 节规范一),而不是出了问题再打补丁版,量产设备没有"重新烧个带日志的版本"的机会。其二,症状速查表本地化——本节的通用表要叠加本项目的专属条目(哪些模块出过事、哪些配置踩过坑、哪些供应商库有前科),通用表加项目表才是完整的索引。其三,最小复现场景库——把历史工单的复现步骤做成可一键执行的压测脚本(高峰负载、异常输入、断电恢复三类起步),复现成本每降一分,排查周期就短一截。其四,双人复核机制——排查超过一天未定位的工单强制换人复审,困在错误假设里是排障最大的时间黑洞,第二双眼睛的价值不是技术而是视角。
还有一条容易被忽视的元纪律:排查过程中产生的每一个临时观测手段,用完别删——临时日志脚、翻转观测宏、压力脚本,整理后归入项目的工具目录。它们是下次同类工单的现成弹药,从零搭建观测的隐性成本,往往比排障本身还高。工单清零的团队与工单缠身的团队,差距通常不在聪明程度,而在这些平时看不见的准备上。
本节要点回顾
- 六步总流程:读包、归类、列嫌、按成本验证、修复加防复发、归档——排查是算法不是灵感;
- 验证成本六档递增,跳级要有理由,直接上仿真器是时间黑洞;
- 五区地图加速查表把搜索空间砍掉五分之四:配置区最便宜先查,中断区最隐蔽慢查;
- 偶发问题优先怀疑无防护的共享:能活到现场的偶发 bug 几乎都是时序相关的裸路径;
- 版本差异是最高效的嫌疑生成器,取证包的版本字段为此服务;
- 坑点库五要素(签名、病根、手段、处方、出处)加季度命中率对账——团队排查能力的资产化。
排查体系建好,下一节谈进取:性能优化。有了观测数据,优化从"感觉慢就改"变成三本账先算后动。