2.2 空间索引技术
2.2 空间索引技术
本节摘要:空间查询要扫全表很慢,靠空间索引加速。本节讲 R 树、网格索引、PostGIS 的 GiST 索引——让空间查询快起来。
核心问题
阅读完本节,你应当能够:
- 理解空间索引的作用
- 知道 R 树怎么工作
- 在 PostGIS 建空间索引
概念脉络
一、为什么空间查询慢
"找 1km 内餐厅"不索引要逐个算距离,表大就慢。空间索引按空间位置组织数据,快速定位候选要素,再精确计算,避免全表扫描。
二、R 树
R 树是空间索引的主流数据结构,用最小外包矩形(MBR)递归组织空间对象:
图 2-2 空间索引(R树)
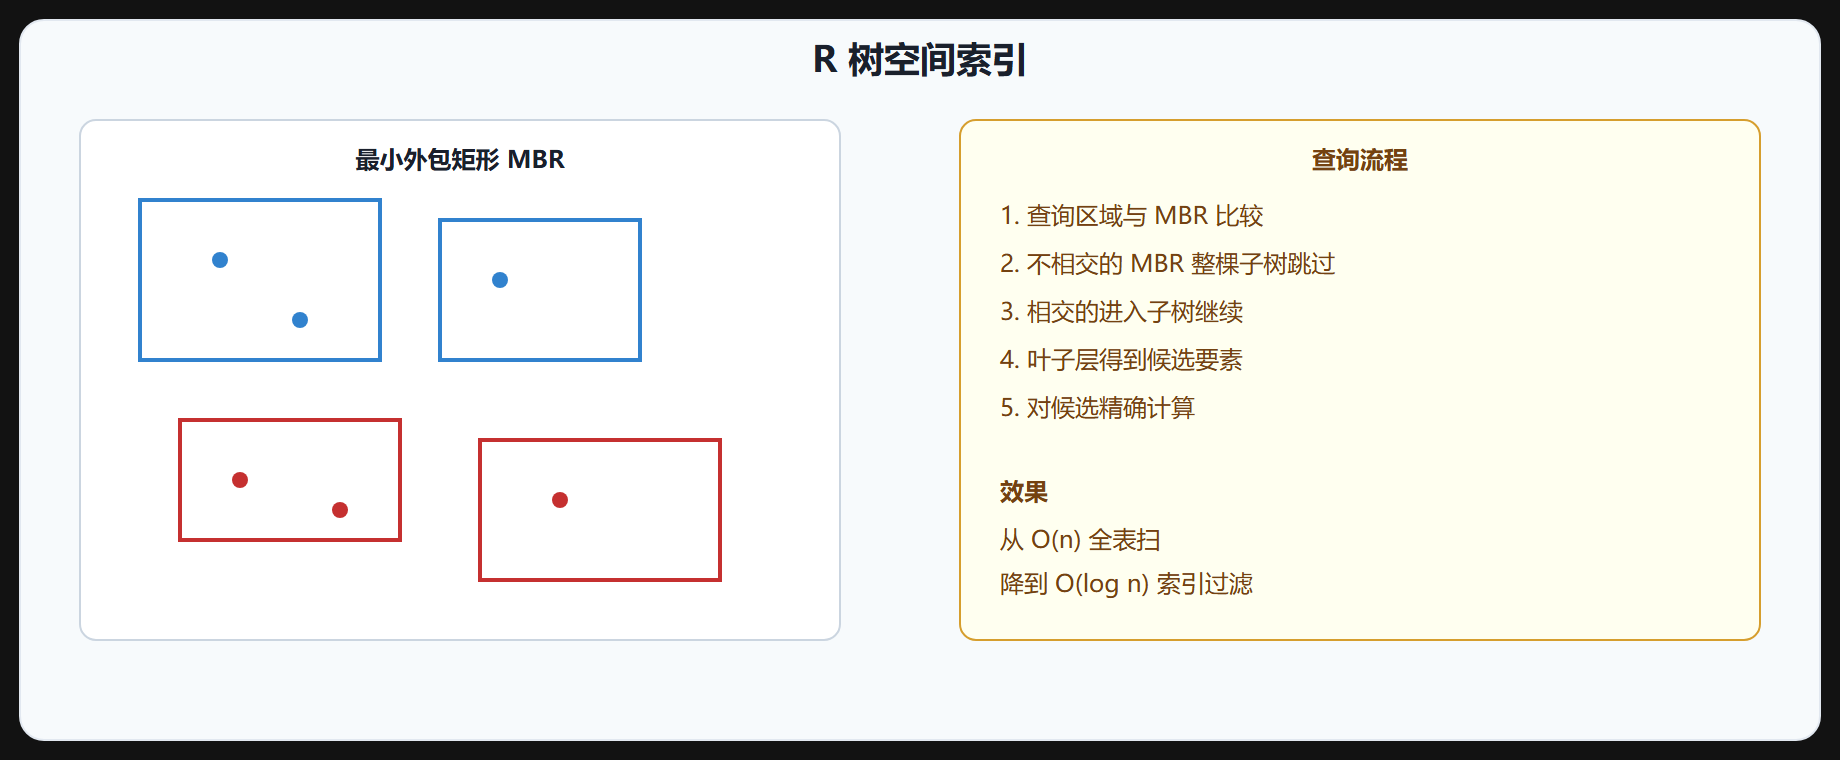
R 树把空间对象按 MBR 分组,查询时先比 MBR,不相交的整组跳过,快速缩小范围。
三、PostGIS 建空间索引
PostGIS 用 GiST 索引实现 R 树:
-- 建空间索引 CREATE INDEX idx_restaurants_geom ON restaurants USING GIST (geom); -- 建完要分析统计 VACUUM ANALYZE restaurants;
建完空间查询自动用索引,ST_DWithin、ST_Intersects 等都能加速。
四、验证索引生效
EXPLAIN SELECT * FROM restaurants WHERE ST_DWithin(geom, my_point, 1000); -- 看 Query Plan 是否用了 GIST 索引扫描
五、空间索引的局限
- MBR 不精确:索引用 MBR 过滤,可能漏进不相交但 MBR 相交的候选,需精确计算二次过滤
- 写入代价:INSERT/UPDATE/DELETE 要维护索引,索引多写入慢
- 统计要新:数据大量变更后要 VACUUM ANALYZE 更新统计,否则优化器选错计划
六、其他空间索引
- 网格索引:把空间划网格,按网格分桶,简单适合规则数据
- 四叉树:递归四分空间,适合二维
- H3/S2:球面六边形/立方体索引,全球级离散化
⚠️ 常见坑:建了空间索引查询还是慢——可能没 VACUUM ANALYZE 统计过期,或查询没用上索引(EXPLAIN 看计划)。
💡 关键直觉:空间索引用 R 树按 MBR 组织,查询先比 MBR 快速过滤候选再精确算。PostGIS 用 GiST 建索引,建完 VACUUM ANALYZE,EXPLAIN 验证生效。
七、R 树的直观理解
R 树为什么快,可以用一个想象场景说明:把一张城市地图按行政区划分成若干大区域,每个大区域再分小格。查"某点 1 公里内的餐厅"时,先判断这个点落在哪个大区域,只翻那个区域里的餐厅记录,而不是把全城餐厅都翻一遍。R 树做的事情就是"把空间对象按位置组织成有层次的外包矩形树",每个父节点只存孩子的最小外包矩形,查询时从根往下剪枝。
它的查找过程分两阶段:
- 粗过滤(索引阶段):从根节点开始,比较查询范围与各节点的 MBR,不相交的子树直接跳过,得到少量候选记录。
- 精计算(过滤阶段):对候选记录逐个调用真实的空间关系函数(如 ST_Distance、ST_Intersects)验证。
所以空间索引的效果上限,取决于查询范围相对数据分布是否"挑得出":查询范围覆盖整张表时,索引几乎帮不上忙,这很正常。
八、不同数据库的空间索引实现
| 数据库 | 索引类型 | 说明 |
|---|---|---|
| PostGIS | GiST | 最常用,基于 R 树 |
| MySQL InnoDB | R 树 | 5.7+ 空间索引 |
| SQL Server | 网格 + 四叉树混合 | 自动选择 |
| Oracle Spatial | R 树 | SDO_INDEX |
| MongoDB | 2dsphere | GeoJSON 地理索引 |
| Elasticsearch | geo_shape | 空间检索 |
实现虽有差异,使用逻辑一致:对几何列建索引,查询优化器自动选择。在 PostGIS 里你也可以用 BRIN 索引(对顺序扫描友好的块级索引),适合只追加、很少更新的海量时序空间表。
九、索引维护的最佳实践
实际项目中索引不是"建一次就完事",维护要点:
- 写入越频繁,索引维护代价越高:批量导入数据时,可以先 DROP 索引导入完成再重建,比边插边维护快很多。
- 定期 VACUUM ANALYZE:大量增删后统计信息过期,优化器可能放弃索引走全表扫描。定时任务里加一条
VACUUM ANALYZE 表名。 - 用 EXPLAIN 验证:发现查询慢,先
EXPLAIN SELECT ...看执行计划里有没有Index Scan using ..._geom,没有就检查条件写法(比如对 geom 列包了函数导致索引失效)。 - 索引不是越多越好:一个表多个空间索引会拖慢写入。按实际查询模式建,删除长期不用的。
-- 查看表上已有的索引 SELECT indexname, indexdef FROM pg_indexes WHERE tablename = 'parcels'; -- 删除后重建(适合大批量导入前) DROP INDEX idx_parcels_geom; -- 导入完成后重建 CREATE INDEX idx_parcels_geom ON parcels USING GIST(geom); VACUUM ANALYZE parcels;
本章回顾
- 作用:空间索引按位置组织数据,避免全表扫描,从 O(n) 降到 O(log n)。
- R 树:用最小外包矩形 MBR 递归组织,查询先比 MBR 跳过不相交的。
- PostGIS:
USING GIST建索引,建完VACUUM ANALYZE更新统计。 - 验证:
EXPLAIN看是否用 GIST 索引扫描。 - 局限:MBR 不精确需二次过滤、写入有代价、统计要新。
- 其他:网格索引、四叉树、H3/S2 球面索引。
下一节讲常用 GIS 数据格式。