8.2 GIS 系统性能优化与运维
8.2 GIS 系统性能优化与运维
本节摘要:GIS 系统数据大、计算重,性能是老大难。本节讲 GIS 架构、性能优化、监控运维——让 GIS 系统跑得稳。
本节地图
阅读完本节,你应当能够:
- 设计 GIS 系统架构
- 优化 GIS 性能
- 做 GIS 运维监控
概念脉络
一、GIS 系统架构
典型 GIS 系统分层:
图 8-3 GIS 系统架构
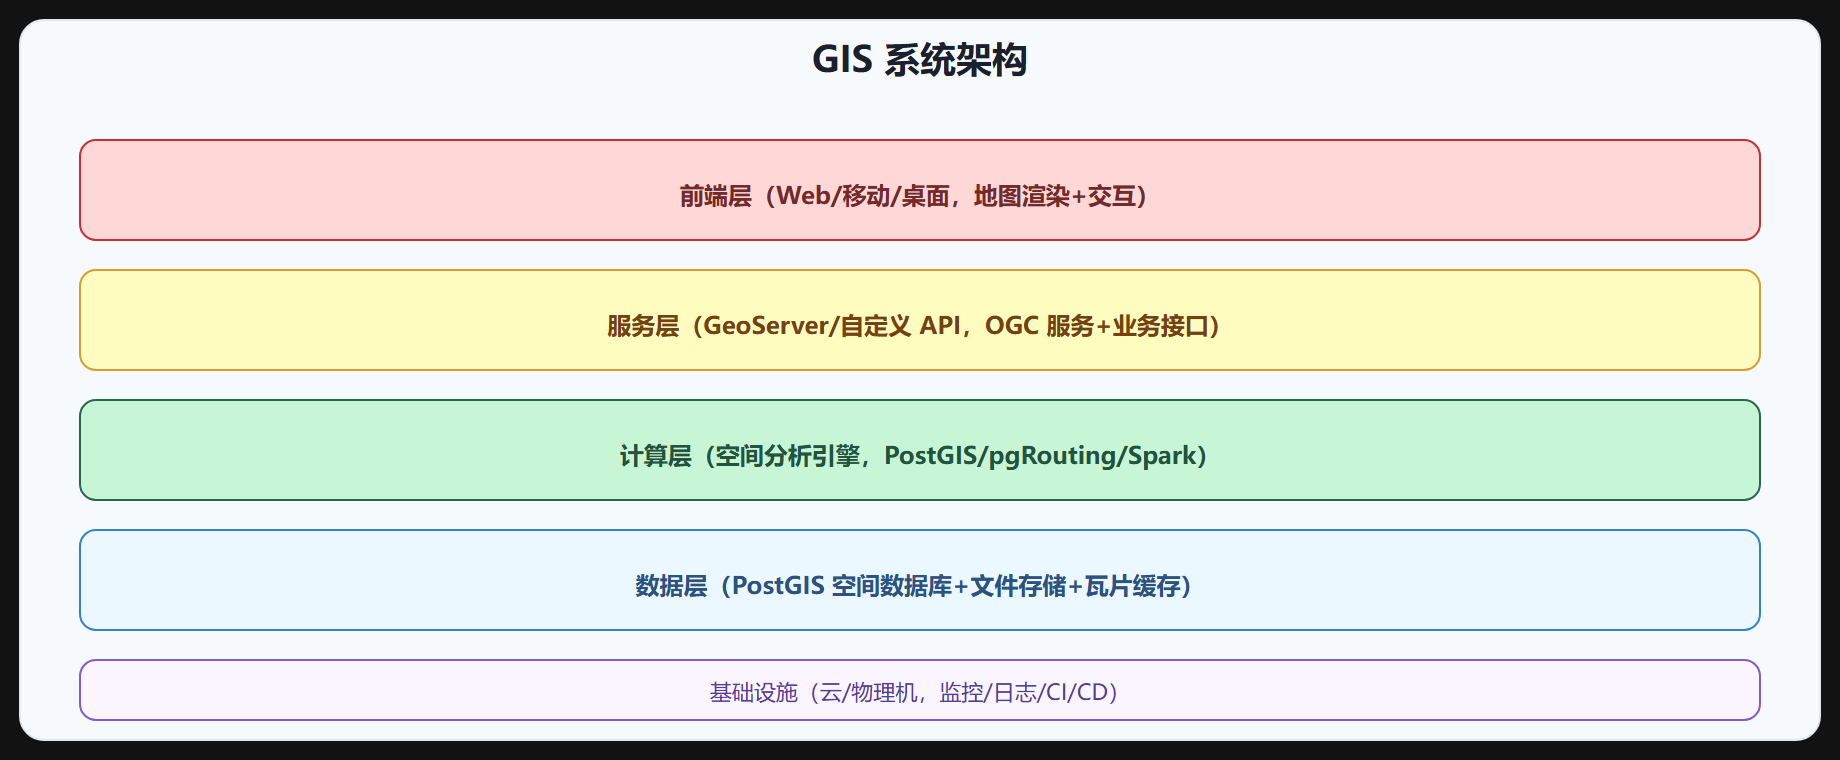
- 前端层:Web/移动/桌面,渲染+交互
- 服务层:GeoServer/自定义 API,OGC 服务+业务接口
- 计算层:空间分析引擎,PostGIS/pgRouting/Spark
- 数据层:PostGIS+文件+瓦片缓存
- 基础设施:云/物理机,监控/日志/CI/CD
二、性能瓶颈在哪
GIS 性能瓶颈常见:
| 层 | 瓶颈 | 优化 |
|---|---|---|
| 前端 | 大数据渲染卡 | 矢量瓦片/聚合/LOD |
| 服务 | 重复渲染慢 | 瓦片缓存 |
| 计算 | 空间查询慢 | 空间索引 |
| 数据 | 大表查询慢 | 分区/分片 |
| 网络 | 数据传输大 | 压缩/增量 |
三、前端优化
图 8-4 性能优化策略
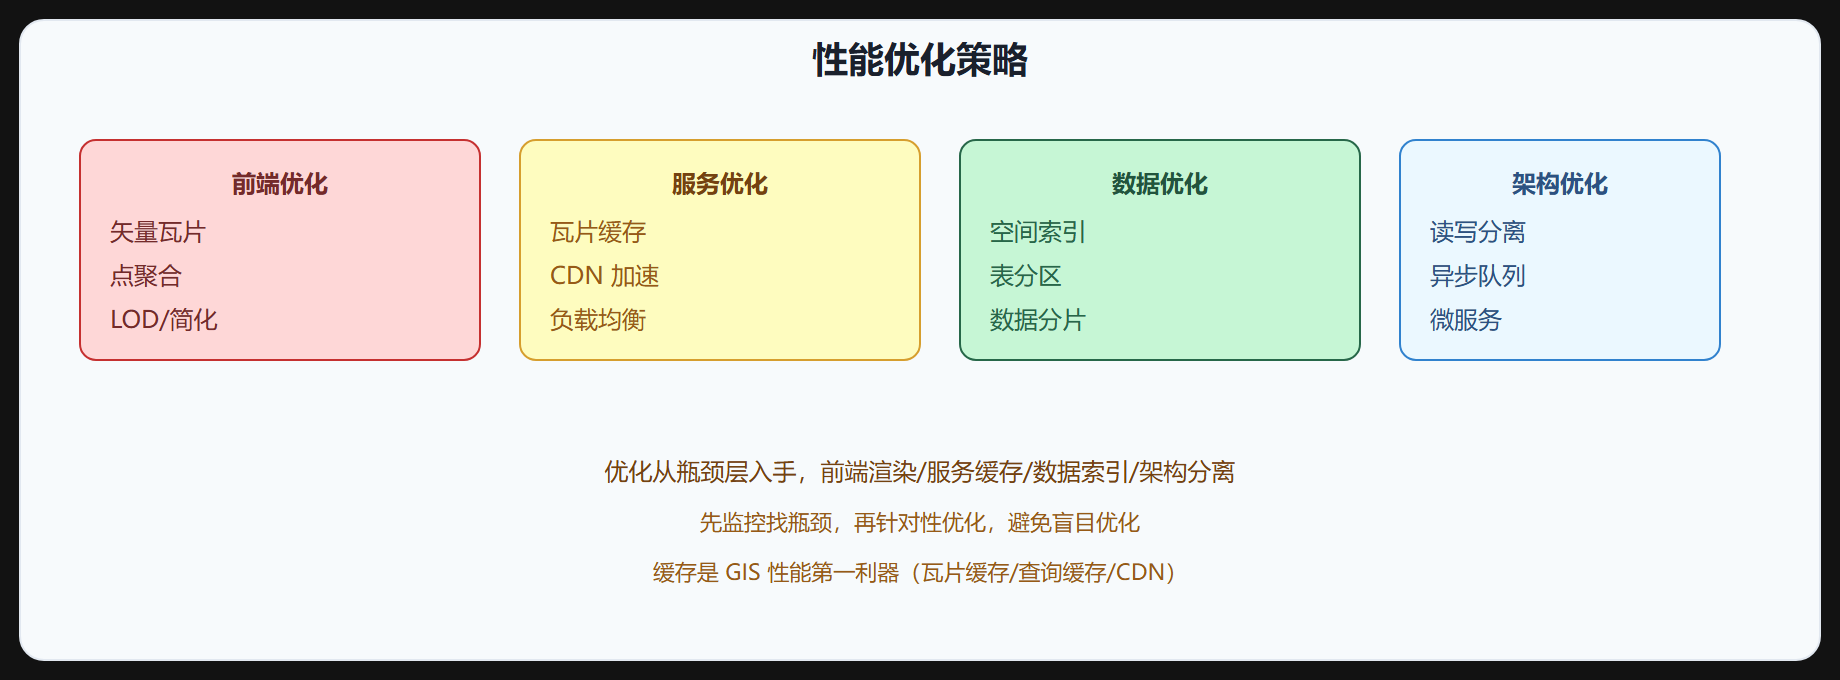
- 矢量瓦片:大数据用 MVT,前端渲染快
- 点聚合:大量点聚合显示,避免重叠
- LOD/简化:远距离简化几何,减少顶点
- WebWorker:重计算放 Worker 不阻塞 UI
四、服务优化
- 瓦片缓存:GeoWebCache 预渲染瓦片
- CDN:瓦片走 CDN 加速
- 负载均衡:多 GeoServer 实例分流
- 连接池:数据库连接池复用
- 压缩:响应 gzip 压缩
五、数据优化
-- 空间索引 CREATE INDEX idx_geom ON parcels USING GIST(geom); -- 表分区(按时间/区域) CREATE TABLE parcels_2024 PARTITION OF parcels FOR VALUES FROM ('2024-01-01') TO ('2025-01-01'); -- VACUUM ANALYZE 更新统计 VACUUM ANALYZE parcels;
- 空间索引:GiST R-树加速空间查询
- 表分区:按时间/区域分区,查询裁剪
- 数据分片:Citus 水平分片
- 统计信息:VACUUM ANALYZE 更新,优化器选好计划
- 读写分离:读走从库,写走主库
六、架构优化
- 读写分离:读多写少,读走从库
- 异步队列:重计算异步,不阻塞请求
- 微服务:按业务拆分,独立扩展
- 缓存层:Redis 缓存热点查询
- CDN:静态资源走 CDN
七、监控运维
| 监控 | 指标 |
|---|---|
| 服务 | 可用性、响应时间、QPS |
| 数据库 | 慢查询、连接数、锁 |
| 资源 | CPU、内存、磁盘、网络 |
| 业务 | 地图加载、查询成功率 |
工具:Prometheus+Grafana 监控,ELK 日志,慢查询分析。
八、运维要点
- 备份恢复:定期备份+恢复演练
- 容量规划:数据增长预估扩容
- 版本升级:灰度升级,回滚预案
- 安全:认证授权、数据脱敏、审计
- 文档:架构图、运维手册、应急预案
⚠️ 常见坑:盲目优化不监控——不知道瓶颈在哪瞎优化。先监控找瓶颈,再针对性优化。
💡 关键直觉:GIS 性能瓶颈在渲染/查询/传输。优化:前端矢量瓦片/聚合/LOD,服务瓦片缓存/CDN,数据空间索引/分区/分片,架构读写分离/异步/微服务。缓存是第一利器。先监控找瓶颈再优化。
九、性能测试方法
优化要有数据支撑,性能测试分三步:
- 定基线:在典型环境记录当前响应时间、QPS、吞吐量,作为对比基准。
- 压测定位:用压测工具对地图加载、WMS 出图、WFS 查询、空间分析接口分别加压,看瓶颈在哪一层。
- 验证效果:每次优化后重测,用同一基线对比,记录提升倍数。
# 简单压测:对瓦片接口并发请求,统计响应时间 ab -n 1000 -c 50 'http://localhost:8080/geoserver/gwc/service/wmts?...'
经验:压测先看 P95 而不是平均值,平均值会被个别慢请求拉低;先压"最贵的查询"(大数据叠加、复杂空间 SQL),它们通常才是真正的瓶颈。
十、缓存策略的分层设计
缓存是 GIS 性能的第一利器,但要分层设计,不是只加一层:
| 层级 | 缓存什么 | 常用方案 |
|---|---|---|
| 浏览器 | 瓦片、静态资源 | HTTP 缓存头 |
| CDN | 瓦片、影像 | CDN 边缘缓存 |
| 应用 | 热点查询结果 | Redis |
| 服务 | 渲染结果 | GeoWebCache |
| 数据库 | 查询结果集 | PostgreSQL 共享缓存 |
设计原则:越靠用户侧的缓存收益越大。瓦片是天然的可缓存资源,一定要给足缓存头;热点空间查询(如城市级别统计)用 Redis 缓存结果,按数据更新时间做失效策略;注意缓存一致性——数据更新后要及时清理相关缓存,否则用户看到旧数据。
十一、监控与告警配置示例
Prometheus 加 Grafana 是开源监控的标准组合。GIS 服务要重点盯的指标:
# prometheus 抓取 GeoServer 的 JVM 和请求指标(示意) scrape_configs: - job_name: 'geoserver' metrics_path: '/geoserver/prometheus' static_configs: - targets: ['geoserver:8080']
关键告警规则:
- 服务可用性:连续 5 分钟请求失败率超过 5%。
- 响应时间:P95 超过 3 秒。
- 数据库连接:连接池使用率超过 80%。
- 磁盘空间:瓦片缓存目录使用率超过 85%。
- 慢查询:数据库慢查询日志每分钟超过阈值。
告警不是越多越好,重点盯"会让人睡不着觉"的指标,避免告警疲劳。
十二、容量规划与演进
- 数据增长预估:按业务增长率估算一年后的数据量和查询量,提前规划存储和节点。
- 分层存储:热数据(近期、高频)放 SSD,冷数据(历史、低频)放对象存储,成本省一半。
- 弹性扩缩:瓦片服务无状态,可水平扩展;数据库读写分离加连接池,扛住突发流量。
- 定期复盘:每季度对照监控数据复盘容量和性能,写进运维月报,提前发现问题。
重点提炼
- 架构:前端/服务/计算/数据/基础设施五层。
- 瓶颈:前端渲染/服务渲染/计算查询/数据查询/网络传输。
- 前端优化:矢量瓦片、点聚合、LOD/简化、WebWorker。
- 服务优化:瓦片缓存、CDN、负载均衡、连接池、压缩。
- 数据优化:空间索引、表分区、分片、统计信息、读写分离。
- 架构优化:读写分离、异步队列、微服务、Redis 缓存、CDN。
- 监控:服务/数据库/资源/业务,Prometheus+Grafana+ELK。
- 运维:备份恢复、容量规划、版本升级、安全、文档。
- 原则:先监控找瓶颈再优化,缓存是第一利器。
第 8 章结束。下一节是附录。
评论区
(0)
U