2.1 语法糖的本质:def、GString 与集合字面量
2.1 语法糖的本质:def、GString 与集合字面量
本节摘要:语法糖不是书写技巧,而是 Groovy 编译器在抽象语法树阶段做的深度语义增强。本节拆解四类最常用语法糖的底层机制——def 的动态类型、GString 的延迟求值、集合字面量与 Range、注解驱动的 POJO 代码生成,并讨论它们各自带来的收益与代价。
先说结论
阅读完本节,你应当能够:
- 解释
def的动态类型推断机制,以及它与显式声明类型的取舍。 - 说明 GString 与普通 String 的区别,解释其延迟求值行为与作为 Map 键时的注意事项。
- 用集合字面量和 Range 写出简洁的数据结构定义,并说出默认实现类型。
- 用
@ToString、@EqualsAndHashCode等注解让编译器自动生成方法,理解 AST 转换的原理。 - 判断哪些场景该用动态写法、哪些该保留显式类型。
一、问题与直觉:样板代码是认知负荷的隐形杀手
先做个实验。你写一个 Java 数据传输对象:私有字段、getter、setter、无参构造、全参构造、equals、hashCode、toString——四十行起步,没有一行是业务逻辑。写十个这样的类,一天就没了。更糟的是,这四十行占据了你读代码时的注意力,让你更难看清真正的业务规则。
软件工程的复杂度可以分成两类:本质复杂度和偶然复杂度。前者来自问题域本身,后者来自工具和语言的局限。Java 的样板代码就是典型的偶然复杂度——它存在只是因为语言要求你写。Groovy 的基本立场很明确:能由编译器代劳的,就不该让人手写。本节讲的四类语法糖,全部指向这个目标:def 省掉类型声明,GString 省掉字符串拼接,集合字面量省掉实例化,注解省掉样板方法。它们不是炫技,是对注意力的重新分配。
二、核心原理:四个语法糖的底层机制
def:动态类型推断,但不是 Object 的别名
def list = [1, 2, 3] 在运行时是 ArrayList,在 Java 里是 List<Integer> list = new ArrayList<>()。区别不仅在于少打字。def 声明的变量被编译器标记为动态类型,运行时由实际值决定类型,方法分派走 MetaClass 机制。它不简单等于 Object——虽然生成的字节码里它常常是 Object 类型,但编译器会注入调用站点缓存来优化动态调用的性能。
💡 关键直觉:
def真正省掉的不是类型本身,而是"决定类型的心智负担"。在探索性代码里这个价值极大;但在团队协作的大型项目里,类型就是契约,全用def等于把契约藏起来。所以经验法则是:公共 API 边界显式声明类型,内部实现用def。
GString:延迟求值,不是简单的字符串模板
def name = 'Groovy' def greeting = "hello, $name" println greeting // hello, Groovy name = 'World' println greeting // hello, Groovy (仍是旧值!)
GString 在编译期被转换为 GStringImpl 对象,内部维护一个值数组。真正的拼接发生在调用 toString() 的那一刻——这就是延迟求值。好处是日志、模板场景效率高;陷阱是如果你把它当 String 存起来再改变量,内容不会自动更新。
语法糖到字节码的旅程
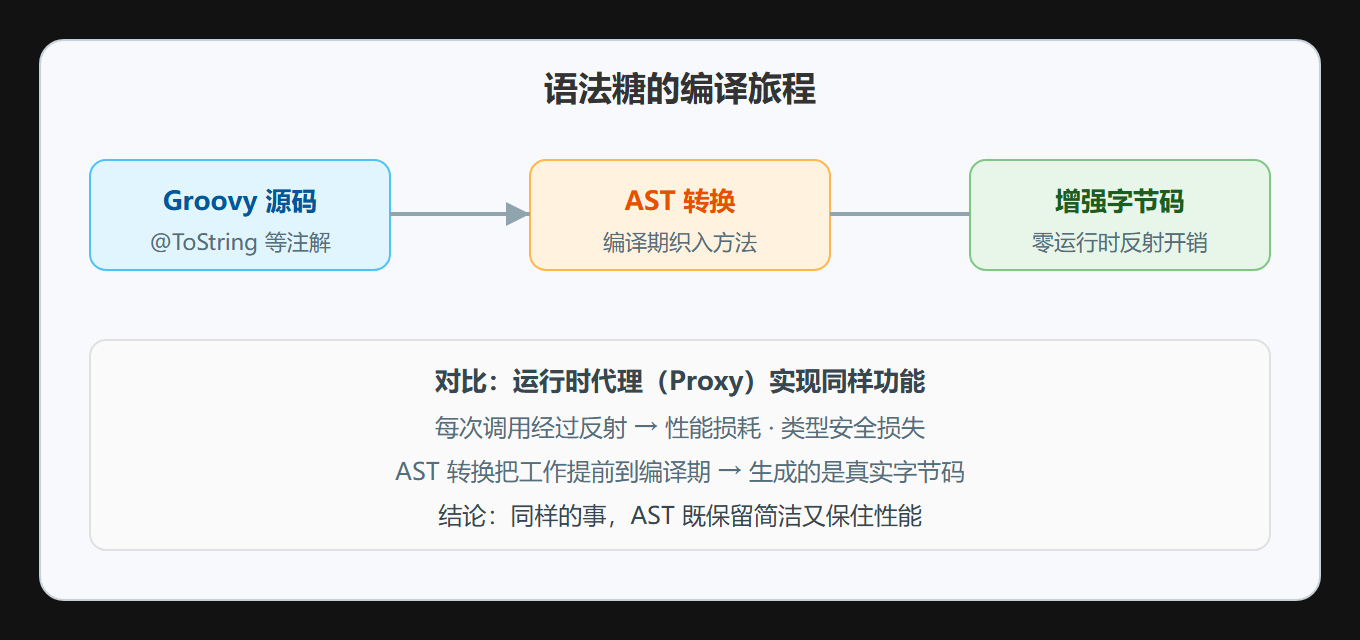
这张图是理解 Groovy 元编程的钥匙:
@ToString、@EqualsAndHashCode、@Canonical这些注解,本质上都是"编译期改写代码结构"的触发器。它们没有运行时反射,所以高频调用也不心疼。
集合字面量与 Range
def list = [1, 2, 3] // ArrayList def map = [a: 1, b: 2] // LinkedHashMap def range = 1..10 // IntRange,实现 List 接口 def evens = (0..20).step(2) // 步进序列
默认实现被隐藏,符合面向接口编程的原则。Range 特别值得一提:它在循环、序列生成、区间判断里都很有表达力,而且底层不复制元素——1..1000000 是轻量对象,不是百万元素的列表。
POJO 简化:注解驱动的代码生成
@Canonical class Book { String title BigDecimal price }
@Canonical 是 @ToString、@EqualsAndHashCode、@TupleConstructor 的组合包,一个注解生成一整套样板方法。AST 转换在编译期自动遍历字段、织入方法。相比运行时代理,它没有性能损耗;相比手写,它不会漏改。这正是"让编译器代劳"哲学的最佳示范。
三、工程实践要点:语法糖的收益与代价
| 语法糖 | 收益 | 代价/陷阱 |
|---|---|---|
| def | 省类型声明,代码更短 | 契约模糊,IDE 提示弱 |
| GString | 插值直观,延迟求值 | 不是 String,作 Map 键要小心 |
| 集合字面量 | 默认实现隐藏,简洁 | 修改默认实现需显式声明 |
| Range | 轻量表达区间 | 误当完整列表使用 |
| @Canonical | 样板零成本 | 生成逻辑不可见,需信任注解 |
| @Grab | 脚本零配置用库 | CI 里依赖应显式管理 |
⚠️ 常见坑:把 GString 直接当 Map 的键。GString 的 hashCode 与普通 String 不同,
map["$key"]可能查不到map[key]存的条目。规范做法是.toString()之后再用。另一个坑是给同一个逻辑起两个名字——def和显式类型混用而不统一,团队里容易产生"这个变量到底什么类型"的争论。
什么时候该收回语法糖
语法糖不是越多越好。三个场景建议收回:一是公共 API 的签名——类型即契约,动态类型会让调用方失去信息;二是性能敏感的核心循环——虽然 AST 转换无反射,但纯动态分派仍有开销;三是跨模块共享的数据模型——显式类型能在编译期抓住错误。反过来,脚本、测试、配置、数据处理这些"变化快、正确性靠运行验证"的场景,放开用。
四、常见问题
def 和具体类型声明性能一样吗?
不一样。def 走动态分派,虽然调用站点缓存让它接近静态,但在高频调用下仍有差距。想要两者兼顾,做法是:先写动态代码快速验证逻辑,性能热点定位出来后,对那段代码加 @CompileStatic。这是 Groovy 的标准优化流程,第 4.3 节会详解。
@Canonical 生成的代码能自定义吗?
能。@Canonical 提供 includes、excludes 等参数控制包含哪些字段;也可以不用组合包,单独用 @ToString(includeNames = true) 这种更细的注解。原则是"默认用组合,需要定制时拆开用单注解"。
GString 什么时候该转成 String?
三处必须转:作为 Map 的键、与 Java API 交互(很多 Java 方法要求严格的 String 类型)、跨模块传递时的序列化。其他场景用 GString 完全没问题。转的方式就是 .toString() 或显式类型声明。
五、深入一点:语法糖背后的两类"代价"
理解语法糖,不能只看它带来什么,还要看它改变了什么。这里讲两类容易被忽视的代价。
第一类是调试可见性的代价。语法糖让源码变短,但断点看到的执行路径变"绕"了。比如 def 声明的变量在 IDE 里显示为 Object,GString 在堆栈里是一大串内部结构,@ToString 生成的代码在源码里根本不存在。调试这类代码,需要有"源码不是全部"的意识——真实逻辑在编译产物里,IDE 的数据流分析能帮你还原一部分。这也是为什么我们强调 Groovy 项目要把 IDE 索引做好,断点配合变量视图观察,比死读源码高效。
第二类是团队契约的代价。def 和 GString 在个人脚本里是效率,在多人协作里可能是隐患——A 写的动态方法 B 调用时找不到签名,C 改了一个 Map 结构 D 的代码静默出错。这不是说团队里不能用语法糖,而是要划定"语法糖的边界":公共 API、跨模块数据结构、对外接口这些"契约位置"收紧;方法内部实现、测试、脚本这些"实现位置"放开。这条边界最好写进团队规范,而不是靠个人自觉。
一个值得了解的进阶特性:类型检查扩展
Groovy 3.0 之后,@TypeChecked 可以和自定义的类型检查扩展配合,让编译器理解你的动态模式。比如你定义了一个 DSL 方法 save(user),默认动态模式下编译器不知道 user 的类型;通过类型检查扩展,你可以告诉编译器"save 的参数是 User 类型",从而在编译期获得补全和校验。这意味着"动态的自由"和"静态的安全"不是二选一,Groovy 提供了灰度切换的旋钮。这个能力的完整介绍在第 4.3 节。
实战中的综合写法
@Canonical class LineItem { String sku int qty BigDecimal unitPrice } def rows = [ ['A-01', 2, 19.9], ['B-02', 1, 49.5] ].collect { sku, qty, price -> new LineItem(sku: sku, qty: qty, unitPrice: price) } def total = rows.sum { it.unitPrice * it.qty } println "合计金额:$total 元"
这段代码同时用了集合字面量、@Canonical、GString、闭包——每一处都是语法糖,但合在一起,读起来已经接近业务描述了。这就是 Groovy 语法糖体系的最终形态:单看每个糖不稀奇,组合起来才见功力。
语法糖如何改变"日常任务"的写法
举一个真实感很强的对比:解析 XML。Java 里要用 DOM 或 SAX,配 Transformer、DocumentBuilderFactory,几十行起。Groovy 里用 XmlSlurper + GPath,像访问对象属性一样访问 XML 节点:
def xml = '<order><item sku="A-1"><qty>2</qty></item></order>' def doc = new XmlSlurper().parseText(xml) println doc.item.@sku.text() // A-1 println doc.item.qty.text() // 2
GPath 是 Groovy 的路径表达式,doc.item.qty 直接沿节点树取值。这种能力背后是 Groovy 的"属性访问即方法调用"模型——doc.item 翻译成对 XmlSlurper 节点的动态方法调用。你不需要理解解析器的每一步,只需要描述"我要哪个节点"。这类内建能力(还有正则、JSON 处理的 DSL)让 Groovy 在处理半结构化数据时特别顺手,也是它能当"胶水语言"的原因之一。
但要注意,这类便利也带走了控制力:GPath 的链式访问对路径不存在时会静默返回空,不像 Java DOM 会明确报错。所以 Groovy 社区的经验是:解析"你知道结构大概是什么样"的数据,用 GPath 飞快;解析"必须严格验证结构"的数据,还是用专门的校验机制,别指望语法糖替你保证正确性。
团队里怎么定语法糖的规范
最后给一个可直接落地的团队规范建议。把语法糖的使用分成三档:允许随意用(方法内部实现、脚本、测试数据构造)、鼓励用但注意可读性(数据处理、配置构建)、需要显式类型(公共 API 签名、跨模块数据模型、序列化边界)。这条规范用一句话概括:语法糖的浓度应该和代码的"契约浓度"成反比——越是内部实现越自由,越是公共边界越克制。把它写进团队的编码约定文档,比每个开发者自己摸索要可靠得多。
还有一个被低估的糖:多行字符串
写 SQL、JSON 模板、Shell 片段时,Java 的字符串转义是噩梦——每个换行要 \n,每个引号要转义。Groovy 的三引号字符串直接解决:
def query = """ SELECT id, name, price FROM products WHERE price > ${threshold} AND status = 'ACTIVE' """
"""...""" 保留换行和格式,还能做 GString 插值。写报表模板、拼接配置文件时,这几乎是"还原文本原貌"的体验。但同样有注意点:多行字符串的缩进会原样保留,格式化时要想好缩进策略;插值表达式里不能有裸的 $,否则需要转义。这类"小糖"积累起来,就是 Groovy 写脚本为什么比 Java 舒服的体感来源。
本章回顾
- def 的本质:动态类型推断,走 MetaClass 分派,不是简单的 Object 别名。
- GString 延迟求值:拼接发生在 toString 时,作 Map 键必须转 String。
- 集合字面量:
[]默认 ArrayList,[:]默认 LinkedHashMap,Range 是轻量区间。 - 注解驱动生成:@ToString/@EqualsAndHashCode/@Canonical 通过 AST 转换在编译期织入方法。
- AST vs 代理:编译期改写没有运行时反射开销,是"简洁与性能兼得"的路径。
- 适用边界:公共 API 和核心路径收紧动态性,脚本和配置层放开。
语法糖把"怎么写"变简单了,下一节我们来看"写什么"的抽象——闭包让行为本身成为一等公民,这是 Groovy 从简洁走向强大的关键一步。