7.1 运行时机制:CallSite、Indy 与对象内存模型
7.1 运行时机制:CallSite、Indy 与对象内存模型
本节摘要:Groovy 的动态性在 JVM 上如何工作?本节从方法分派讲起——CallSite 缓存如何让动态调用接近静态、invokedynamic(Indy)如何把优化交给 JVM,以及 Groovy 对象为何比 Java 对象更重。读完你能解释"为什么动态调用慢、慢在哪、怎么变快"。
本节地图
阅读完本节,你应当能够:
- 解释动态方法分派与静态方法绑定的性能差异来源。
- 说明 CallSite 缓存机制如何降低动态调用开销。
- 理解 invokedynamic 相比传统缓存方案的优势。
- 说明 Groovy 对象内存模型与 Java 对象的差异,及对 GC 的影响。
- 识别动态属性访问在并发下的可见性风险。
一、问题与直觉:动态的列车为什么总在查地图
把 JVM 比作铁轨,静态调用就是在铺好的轨道上高速行驶——编译器早就把目的地标好了。动态调用则像越野车,每到一个路口都要确认路线(查找方法)。Groovy 的动态性赋予了运行时改道的能力,但代价是每次调用都可能触发一次"查地图"。
这个问题不解决,Groovy 就只能是玩具。Groovy 的解决方案分两代:第一代是 CallSite 缓存(语言层面优化),第二代是 invokedynamic(把优化下沉到 JVM)。理解这两代方案的演进,你就理解了 Groovy 运行时机制的全貌,也理解了性能问题的根源与解法。
二、核心原理:三代方法分派
Java 的静态分派
Java 的 obj.method() 在编译期就能确定目标,生成 invokevirtual 指令,JVM 通过虚方法表快速定位,JIT 还能激进内联。这是性能基准线——所有动态语言的优化,目标都是逼近这条线。
第一代:CallSite 缓存
Groovy 动态模式下,obj.method() 的 obj 类型编译期未知,方法甚至可能在运行时被添加。第一代优化是调用站点缓存:首次调用创建 CallSite 对象并缓存解析结果,后续调用直接命中缓存,开销接近静态调用。
CallSite 缓存流程
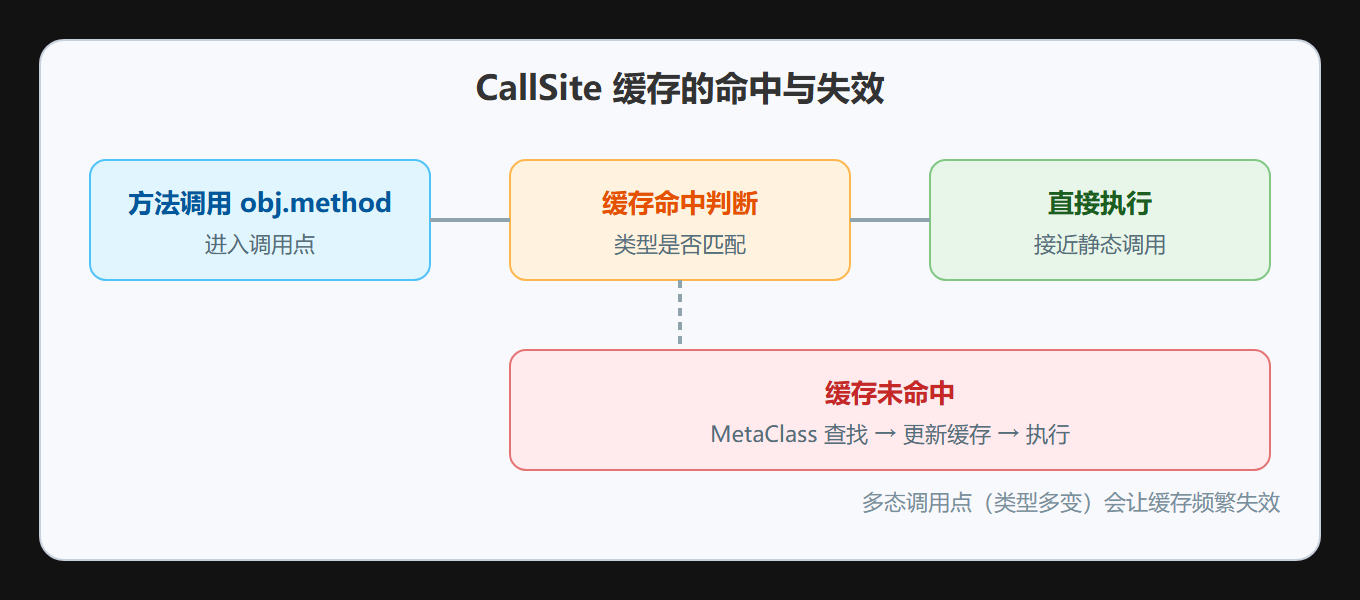
缓存的局限在于:它由 Groovy 运行时维护,JVM 的 JIT 难以穿透这层封装做内联优化。当对象类型变化频繁(多态调用点)时,缓存命中率下降,性能回退明显。
第二代:invokedynamic(Indy)
Java 7 引入 invokedynamic 指令后,Groovy 2.0 全面拥抱它。在 Indy 模式下,编译器生成 invokedynamic 指令 + Bootstrap 方法,由 JVM 接管调用点解析。关键在于:JVM 的 JIT 可以把 Indy 调用点当作普通方法调用优化——内联缓存、甚至完全内联。JVM 还能维护多个类型专用的代码路径,多态调用点也能快速切换,而不会退化为慢速查找。理论复杂度上,传统动态查找最坏是线性搜索,Indy 内联缓存能把平均耗时压到接近常数。
对象内存模型:动态的隐藏成本
动态性不只影响方法调用,还影响对象本身。每个 Groovy 对象要实现 GroovyObject 接口,对象头之外需要存储 MetaClass 引用;动态添加的属性存储在内部 Map 中。相比普通 Java 对象,Groovy 对象的基础开销可能多 8-16 字节,还有动态属性的 Map 结构。后果是:百万级实例的应用堆内存占用更高、GC 压力更大、CPU 缓存局部性更差(属性散落在堆各处)。
💡 关键直觉:把 Groovy 对象想成"带了工牌的工人"——工牌(MetaClass 引用)让你能随时改派任务,但每张工牌都有重量。Java 对象是"赤手空拳的工人",轻但改不了任务。要改任务又要轻装?用 @CompileStatic,在编译期把工牌收回去。
三、工程实践要点:理解代价,选择路径
| 场景 | 执行模式 | 说明 |
|---|---|---|
| 脚本、配置、规则 | 动态(CallSite/Indy) | 灵活性优先,性能够用 |
| 热点循环 | @CompileStatic | 消除分派与内存开销 |
| 高并发共享对象 | @CompileStatic + 不可变 | 规避可见性问题 |
| 大数据批量处理 | 原生 Java 数据载体 | 内存膨胀不可接受 |
⚠️ 常见坑:在内存敏感的大数据处理里用 Groovy 对象当数据载体,导致堆内存暴涨、GC 频繁。对策:数据载体用 Java 类(或原生数组),Groovy 只做逻辑层。另一个坑是动态属性访问在多线程下的可见性——getter/setter 未必是原子操作,共享可变 Groovy Bean 需要显式同步。
如何观察运行时行为
性能问题的第一步永远是观察。三个工具:一是 IDE 的运行时视图,查看对象的 MetaClass 状态与方法来源;二是 JVM 参数开启 CallSite/Indy 相关诊断;三是剖析工具(Async Profiler、Java Flight Recorder)统计方法调用频率与耗时。特别是 MetaClass 相关方法的调用次数,能直接告诉你"动态分派在热点里占了多少"。
与 JVM 进化的关系
invokedynamic 的成功证明了一个趋势:动态语言性能的胜负手,越来越依赖 JVM 自身的优化能力。Groovy 要做的,是生成更利于 JIT 优化的字节码(Indy、静态编译),把优化空间让给 JVM。未来随着 Project Loom(虚拟线程)等新特性落地,运行时机制还会继续演进——理解当前机制,是为了在变化来临时有能力跟上。
四、深入:从字节码到内存布局的观察
想真正理解运行时机制,光看概念不够,要做三个观察。
第一个观察字节码。用 javap 反汇编一个 Groovy 类,动态模式下你会看到大量转发到 GroovyObject.invokeMethod 的调用;Indy 模式下出现 invokedynamic 指令,操作数指向 Bootstrap 方法。这个对比直观展示了"语言运行时托管"与"JVM 托管"的区别。看懂字节码,你就知道静态编译为什么快——它生成的就是 Java 式的直接调用指令。
第二个观察对象内存。在剖析工具里看 Groovy 对象与 Java 对象的内存占用差异,留意 MetaClass 引用与属性 Map 的开销。大数据场景下,把数据载体从 Groovy 对象换成 Java 类,堆内存和 GC 压力会明显改善。这个对比实验能帮你建立"对象即成本"的直觉。
第三个观察调用缓存。用 JVM 诊断参数或剖析工具统计 CallSite 缓存命中率,多态调用点(同一行代码接收不同类型)会让命中率下降。如果你的热点代码类型变化频繁,就该考虑静态编译或重构。观察的价值在于:它把"性能不好"这个模糊感觉,变成了"哪里命中率低、哪里内存重"的具体证据。
一个实践判断清单
遇到 Groovy 性能问题时,按这张清单排查:是不是热点路径走了动态分派(查 MetaClass 调用频率)?是不是数据对象太重(查内存占用与 GC)?是不是多态调用点让缓存失效(查命中率)?是不是动态属性访问在共享对象上(查并发可见性)?四个问题定位后,再决定用静态编译、换数据载体还是重构设计。盲目优化是低效的,清单化的排查是高效的。
五、常见问题
Groovy 启动为什么慢?
启动慢主要来自三块:JVM 本身的启动、Groovy 运行时与元类体系的初始化、首次编译脚本的成本。对一次性脚本影响可接受;对 Serverless 等启动敏感场景,用 GraalVM 原生镜像消除(见第 8.3 节)。日常优化:保持类路径精简、避免启动时加载无关模块、用脚本缓存减少重复编译。
静态编译的代码和 Java 性能完全一样吗?
接近,但不完全。静态编译消除了动态分派与大部分装箱,核心路径与 Java 差距极小;但 Groovy 语法糖(GString 等)在极端场景仍可能有微小开销。判断标准是基准测试而非理论——大多数业务场景,静态编译后的差距已可忽略。
什么时候该放弃 Groovy 性能优化,直接换 Java?
当性能要求超出动态语言合理范围时:纳秒级延迟、超大规模数据载体、极致内存控制。此时 Groovy 适合做"外壳"(配置、规则、编排),核心热路径用 Java 实现(混合模式,见第 6.5 节)。这不是失败,而是把每种语言用在它擅长的地方。
一个综合判断示例
假设你有一个网关服务,路由规则用 Groovy 脚本实现。性能剖析显示:规则解析占 CPU 的 40%,且调用点类型多变。优化路径:第一步,脚本缓存消除解析开销(复用编译后的类);第二步,对规则方法的参数做显式类型声明并加 @CompileStatic,消除多态调用点的动态分派;第三步,若规则数据量大,把数据载体从 Groovy 对象换成 Java 类,降低 GC 压力。三步之后,规则执行路径从"动态 + 重解析"变成"静态 + 已缓存",性能通常有数量级改善。这个例子展示的正是本节的方法论:先剖析定位,再按"缓存 → 静态化 → 减重"的顺序对症下药。
动态性收益的另一面
说了这么多代价,也要还动态性一个公道——它在特定场景的收益远大于代价:规则引擎的热更新、DSL 的词汇扩展、测试的 mock 注入,这些能力用静态语言实现要么极其繁琐要么根本不可能。所以正确的认知不是"动态性不好",而是"动态性要用对地方"。把动态性预算花在"变化频繁、表达力值钱"的场景,把静态性用在"稳定、高频、性能敏感"的场景,两者各得其所。这也是全书反复强调的动静分区方法论在运行时层面的落点。记住这个平衡,你对 Groovy 性能的理解才算完整。
四、常见问题
Indy 模式需要开启吗?
Groovy 2.0+ 默认就是 Indy 模式,无需手动开启。但要注意:某些运行环境(如部分应用服务器)可能需要配置以确保 Indy 生效。验证方法:查看编译产物中是否出现 invokedynamic 指令,或用性能对比确认动态调用路径是否走 Indy。
@CompileStatic 和 Indy 冲突吗?
不冲突,反而互补。@CompileStatic 在编译期确定类型、生成直接调用指令(不走 Indy 动态路径);Indy 优化的是剩余的动态代码。一个管"静态部分",一个管"动态部分",各司其职。理想状态是:核心热点静态化,边缘动态代码交给 Indy 优化。
Groovy 对象为什么不能直接当数据载体?
因为动态性的内存开销。每个实例的 MetaClass 引用 + 属性 Map,加上动态分派路径,让 Groovy 对象在"数量大、访问密集"的场景下效率不高。大数据处理里,用原生 Java 类(或数组/结构体式设计)做数据载体,逻辑层用 Groovy,是常见的架构优化。
本章回顾
- 分派问题:动态调用每次查方法表,静态调用编译期绑定。
- CallSite 缓存:语言层缓存解析结果,多态调用点会失效。
- invokedynamic:下沉到 JVM,JIT 可内联,多态路径快速切换。
- 内存模型:Groovy 对象带 MetaClass 引用 + 属性 Map,更重、GC 压力更大。
- 可见性风险:动态属性访问未必原子,共享可变 Bean 要同步。
- 优化路径:热点静态编译、数据载体用 Java、动态留给边缘。
- 观察优先:剖析工具统计 MetaClass 调用,用数据说话。
理解了运行时机制,再看并发就有意思了——动态性给并发带来了新的变量。下一节看 Groovy 如何在保持动态的同时安全地并行。