1.1 从Stubby到gRPC的演进历程
1.1 从 Stubby 到 gRPC 的演进历程
本节摘要:gRPC 的前身是 Google 内部运行逾十年的 RPC 框架 Stubby。本节讲清三个问题:Stubby 在超大规模实践中验证了什么、它带着哪些私有协议的历史包袱、gRPC 为什么选择在 HTTP/2 上重写而非直接开源旧代码。理解这段历史,才能理解 gRPC 每一处"看起来多此一举"的设计。
学习目标
阅读完本节,你应当能够:
- 复述 Stubby 到 gRPC 的关键时间线与版本里程碑;
- 解释"标准化重写"相对"直接开源"的工程价值;
- 说出 HTTP/2 标准化与 gRPC 诞生时间上的巧合关系;
- 列举 gRPC 开源生态中的三个标志性事件(CNCF、etcd 与 Kubernetes 生态、多语言实现矩阵)。
一、故事从一个"老古董"说起
2015 年 3 月,Google 把内部的 RPC 框架以 gRPC 之名开源。对外界来说这是个新项目,对 Google 内部来说,这是给一位服役超过十年的老功臣换了一副新骨架。
这位老功臣叫 Stubby。早在 21 世纪初,Google 的服务化程度就已经远超那个年代的一般互联网公司——搜索、广告、地图背后的系统被拆成上万个服务,服务之间每秒发生的调用次数以十亿计。Stubby 就是横亘在这些服务之间的统一通信层:调用方拿到一个看起来像本地函数的存根,框架负责连接管理、序列化、负载均衡、鉴权,业务工程师几乎感觉不到"远程"二字的存在。
这套体系验证了一件事:当服务数量突破人的记忆边界后,"接口契约"必须成为机器可校验的东西。上万个服务、几千个团队,靠 wiki 上的接口文档协调联调是不现实的——文档会过期,人会记错,字段会在不知情的团队手里被改掉含义。Stubby 用接口描述语言加代码生成,把契约变成编译期就能检查的对象,这是它最重要的遗产。
但 Stubby 也有明显的时代局限。它跑在私有协议上,与外界标准几乎不兼容;它诞生时 HTTP/2 还不存在,很多能力是自己在私有协议里"发明"的,比如多路复用、双向流;它深度绑定 Google 内部的基础设施,从命名服务到安全体系都离不开内部组件。直接把这套代码开源,外界得到的不是一个框架,而是一堆需要"先理解 Google 再理解框架"的历史包袱。
💡 关键直觉:软件工程里"重写还是复用"的判断,很多时候取决于耦合度——Stubby 的问题不是代码质量,而是它与内部体系的耦合深到无法剥离。
二、为什么是 2015 年:HTTP/2 的成熟
gRPC 选择在这个时间点开源,不是偶然。2015 年 5 月,HTTP/2 正式标准化(RFC 7540)。gRPC 团队等的就是这个:Stubby 私有协议里自己发明的那些能力,HTTP/2 用标准的方式提供了一遍。
对照着看这份"能力对齐清单",你会明白重写的逻辑:
| Stubby 私有协议里的 homemade 能力 | HTTP/2 提供的标准等价物 | gRPC 获得的收益 |
|---|---|---|
| 单连接上交织多个调用 | 多路复用与流机制 | 标准化实现,中间设备可识别 |
| 自定义的双向消息通道 | 全双工流 | 代理、负载均衡器能正确处理 |
| 私有的头部压缩做法 | HPACK 头部压缩 | 元数据传输体积下降 |
| 内部专用的连接管理 | 连接语义标准化 | 可复用互联网基础设施生态 |
于是 gRPC 的策略变成:应用层协议自己定义(怎么描述一次 RPC),传输层完全站在 HTTP/2 标准上。这一次重写换来的是——任何理解 HTTP/2 的防火墙、代理、调试工具,都能与 gRPC 流量共存,不需要专门的私有协议插件。
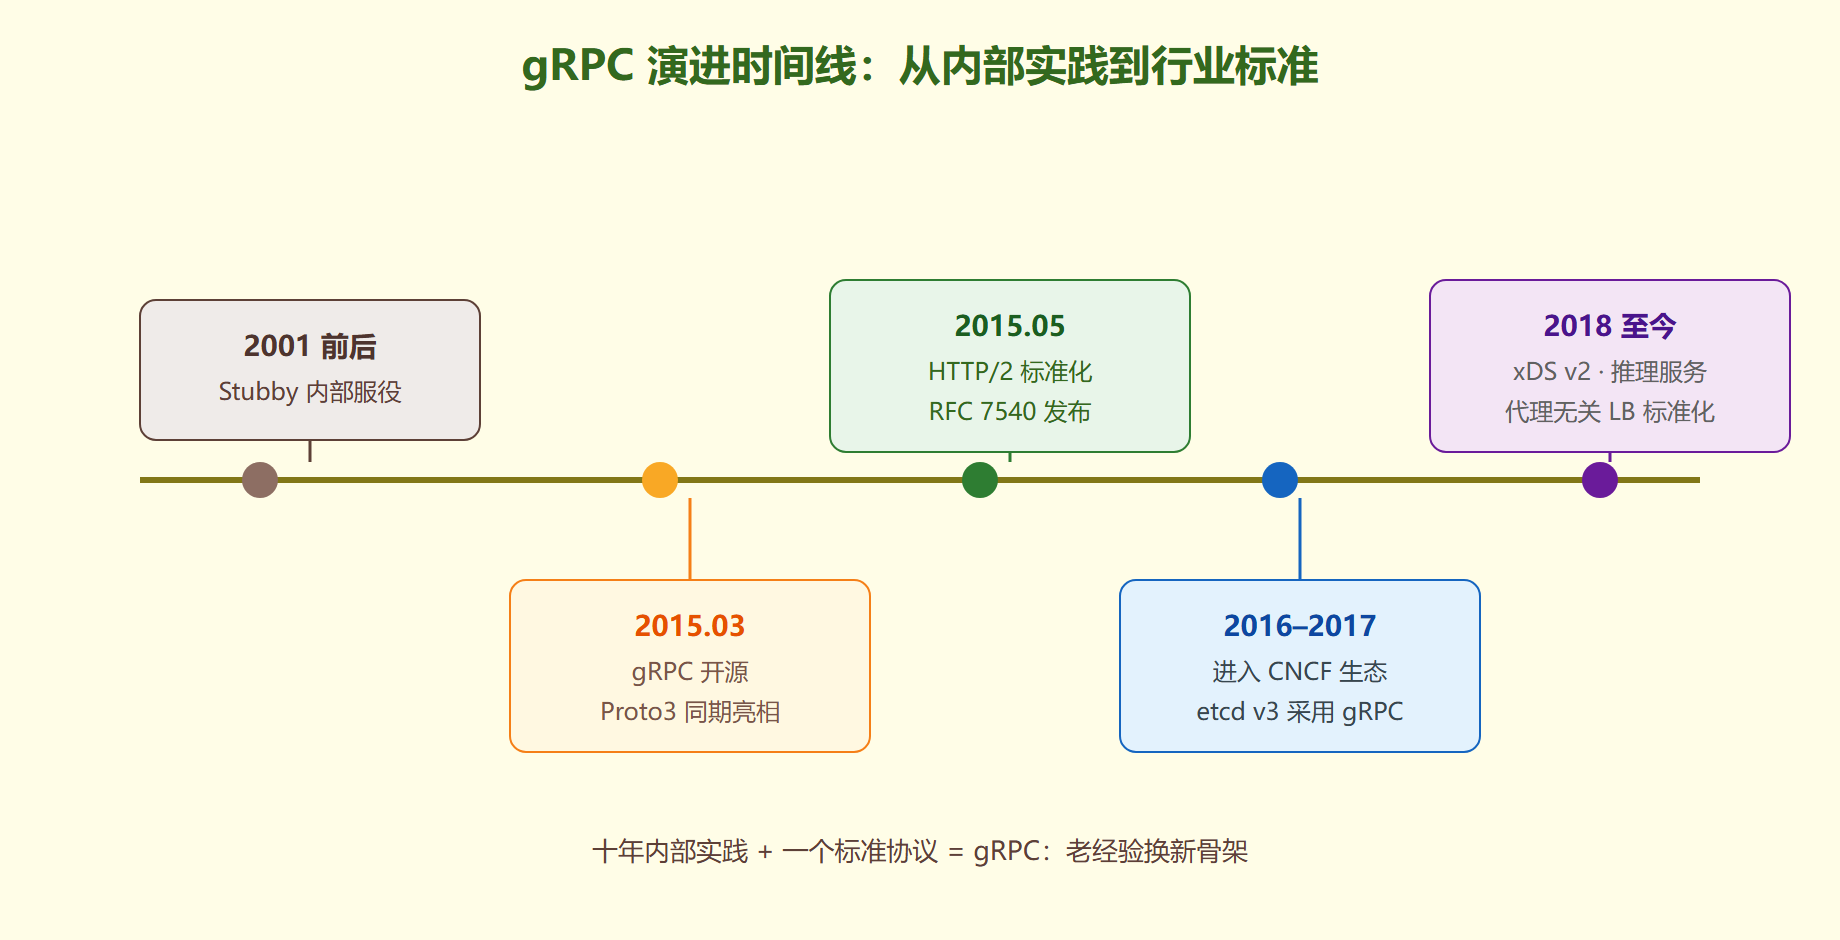
演进时间线全景
三、开源之后的生态位扩张
开源只是起点,gRPC 真正确立行业地位靠的是随后几年的生态渗透。有两条线索值得记住。
**第一条线索是云原生基础设施的采用。**2016 年前后,CNCF 的核心项目陆续把 gRPC 作为控制面与数据面的通信协议:etcd 从 v3 开始全面改用 gRPC 对外提供服务,Kubernetes 的诸多组件与生态工具跟进,Envoy 的 xDS 协议(控制面向数据面下发配置的协议)基于 gRPC 的双向流实现。这一步棋的意义在于——gRPC 先拿下了"基础设施层"的通信,而基础设施是所有业务都绕不开的地基。
**第二条线索是跨边界的场景渗透。**TensorFlow Serving 用 gRPC 承载推理请求,让"模型服务化"有了低延迟的传输通道;各类数据库、消息系统的代理层也陆续出现 gRPC 接口。到今天,"服务之间高频内部通信用 gRPC"在很多技术团队已经是默认选项而非需要论证的创新。
多语言支持是生态扩张的载体。gRPC 之初就覆盖 C++、Java、Python、Go、Node.js、Ruby、Objective-C、Android Java 等语言,后来社区补齐 C#、PHP、Dart、Kotlin 等。同一个 proto 契约,Java 团队生成 Java 客户端,Go 团队生成 Go 服务端,Python 团队写脚本调用——契约只有一份,实现各说各话,这是异构团队协作里最省心的模式。
版本演进的时间线也值得一张简表,帮你建立"什么时候发生了什么"的坐标系:
| 时间 | 事件 | 对使用者的意义 |
|---|---|---|
| 2015.03 | gRPC 开源,proto3 同期定稿 | 现代语法与框架同步起步 |
| 2015.05 | HTTP/2 标准化 | 传输底座有了正式规范 |
| 2016 前后 | 进入 CNCF 生态,etcd v3 采用 | 基础设施层的第一波背书 |
| 2017 前后 | Kubernetes 生态工具链跟进 | 云原生默认选项的地位形成 |
| 2018 前后 | 服务网格兴起,代理 LB 标准化起步 | 治理能力开始下沉基础设施 |
| 2020 至今 | gRPC-Web 与转码成熟、HTTP/3 实验支持 | 边界打开,传输层继续演进 |
对使用者的启示藏在节奏里:gRPC 的核心应用层协议(第 3 章的映射规范)自开源以来高度稳定,持续变化的是外围——传输版本、代理生态、观测标准。这意味着你学到的核心知识保值,外围知识需要按年更新。
⚠️ 常见坑:不少人把"gRPC 开源"记成"Google 把 Stubby 开源了"。两者不是一回事——gRPC 是保留设计思想、抛弃历史包袱的重新实现,这从它的传输层选择就能看出来:Stubby 的私有协议没有出现在 gRPC 的任何角落。
四、历史留给 gRPC 的三个性格
回看这段历史,有三条"性格"沉淀在了 gRPC 的设计里,后面每一章都会反复遇到它们。
**其一,契约至上。**Stubby 时代被"文档失效"坑过,所以 gRPC 把契约放在一切的中心:改接口必须先改 proto,改完 proto 必须重新生成代码,编译不过就上不了线。这套约束在有些人眼里繁琐,但它把一整类运行时错误提前到了编译期。
**其二,性能是入场券而非卖点。**Google 内部的调用量决定了低延迟、高吞吐不是锦上添花而是生存条件。二进制编码、连接复用、流式传输都为性能服务,但 gRPC 的文档从不把"快"当作唯一卖点——因为对大多数业务,契约治理的价值比快出来的那几毫秒更重要。
**其三,务实兼容。**重写在 HTTP/2 上、提供 gRPC-Web 让浏览器曲线接入、提供转码网关让 REST 与 gRPC 共存——gRPC 生态在"坚持核心"与"向现实低头"之间走的是务实路线。这份务实也是它在企业落地时摩擦较小的原因。
顺带回答一个读历史时常被问起的问题:**为什么 Google 内部框架的开源化不少见,成功的却不多,gRPC 算一个?**差别就在于前面说的"标准化重写"——多数失败案例是把内部系统原样搬出来,用户要先理解一整套内部概念才能用;gRPC 反过来,把内部经验翻译成开放标准(HTTP/2、Protobuf、标准状态码),用户带着既有知识就能上手。这个"翻译"而非"搬运"的开源策略,值得所有想把内部基建开放出去的团队借鉴。
还有一个对照视角帮助定位 gRPC 在 RPC 框架谱系里的位置。同期与之后,开源世界还有 Thrift(Facebook 出品,跨语言序列化与 RPC 的一体化方案)、Dubbo(Java 生态的服务治理框架)、Finagle(JVM 上的 RPC 抽象层)等选择。gRPC 能从中跑出来,胜点不在某个单点技术——Thrift 的序列化性能、Dubbo 的治理功能在各自维度都不弱——而在标准协议底座带来的生态位:跑在 HTTP/2 上意味着防火墙放行、代理可管、云原生设施直接兼容,这些"通信之外"的兼容性是私有协议框架难以追平的护城河。
常见问题
问:学 gRPC 之前要先学 HTTP/2 吗?
不用。第 3 章会把需要的 HTTP/2 知识(多路复用、流、帧)从零讲清。带着"单连接怎么同时跑多个调用"这个疑问往下读,效果最好。
问:Stubby 和 gRPC 的接口定义语言是同一个吗?
不是。Stubby 内部使用 Google 早期的接口描述格式,gRPC 配套的是 Protocol Buffers 第三版(proto3),两者语法与语义都有差异, proto3 在 2015 年与 gRPC 同期定稿,第 2 章展开。
问:Google 内部现在用的就是开源 gRPC 吗?
是同源的演进关系:开源 gRPC 的设计回流到内部体系,内部的大规模实践持续反哺开源实现。这条双向通道正是它比"一次性开源"项目生命力强的原因——需求不是猜出来的,是每天数十亿次调用压出来的。
要点速记
- Stubby 是 gRPC 的思想前身:在 Google 内部服役逾十年,验证了"契约机器可校验、通信细节对业务透明"这条路线的可行性。
- gRPC 是标准化重写而非直接开源:抛弃私有协议与内部耦合,把传输层放到 HTTP/2 标准之上,换取互联网基础设施生态的兼容。
- 时间点上,HTTP/2 标准化(RFC 7540)是重写的前提:Stubby 自制的多路复用、双向流等能力在 HTTP/2 里有了标准等价物。
- 生态扩张走的是"先基础设施、后业务"的路径:etcd、Kubernetes 生态、Envoy xDS 先采用,业务通信跟进成为默认选项。
- 多语言代码生成是异构团队的协作载体:一份 proto 契约,各语言各自生成实现,接口不漂移。
- 开源策略是"翻译"而非"搬运":把内部经验翻译成开放标准,用户带着既有知识即可上手,这是 gRPC 能从众多内部框架开源中胜出的关键。
- 历史沉淀的三个性格:契约至上、性能是入场券、务实兼容——它们解释了后续各章几乎每个设计决策。
下一节我们把镜头从历史拉近到设计本身:gRPC 的四大技术支柱(proto 契约、HTTP/2、代码生成、流式语义)如何环环相扣地撑起"像调用本地函数一样调用远程服务"这个承诺。