2.2 二进制编码原理与字段兼容规则
2.2 二进制编码原理与字段兼容规则
本节摘要:Protobuf 的 wire format 是一组"字段键值对"的字节序列:键由字段编号与线型压成 varint,值按线型决定编码方式。本节拆解 varint 变长整数、键的构造、长度前缀结构三种机制,解释负数膨胀、字符串与嵌套消息的边界,最终落回工程视角——一张兼容性变更对照表,让你在改 proto 前就知道哪些操作安全、哪些是定时炸弹。
核心问题
阅读完本节,你应当能够:
- 手工编码与解码一条简单的 Protobuf 消息(两三个字段);
- 解释 varint 的分组与最高位标记规则;
- 说明 int32 与 sint32 在负数编码上的差异及体积后果;
- 列出至少六种兼容与不兼容的 proto 变更场景;
- 在出现"字段神秘错值"故障时,从编码层面定位原因。
一、为什么值得钻进字节层
多数工程师对 Protobuf 的理解停在"黑盒序列化"。这个层次平时够用,但两类时刻会惩罚这种理解:一是性能优化时(为什么这条消息比预估大了三倍);二是诡异故障时(旧服务读出的字段值驴唇不对马嘴,日志却一切正常)。
真正的好消息是,wire format 的设计简单到可以在一节内讲透——它没有任何"聪明到需要文档解释三页"的机制,只有三条朴素的规则反复组合。我们从一个具体问题开始:数字 300 怎么变成字节?
二、varint:变长整数的编码术
固定宽度整数有个浪费:值 1 用 4 字节 int32 表示时,后面 3 个字节全是零。varint 的思路是按需分配——每 7 个比特一组,从低位到高位切分,每组前面加 1 个继续位:最高位是 1 表示"还有下一组",是 0 表示"到此为止"。
数字 300 的二进制是 100101100,9 个比特,切成两组:低 7 位 0101100,高 2 位 10。补齐继续位后:第一字节 10101100(最高位 1,还有下文),第二字节 00000010(最高位 0,结束)。于是 300 编成两个字节,而小数字 1 到 127 只需一个字节。
这个机制的收益分布不均:值越小越省,值越大越费——4 字节能装的数,varint 最多要 5 字节。但真实业务数据里小数字占绝对多数(数量、状态、枚举、页码),整体上是净赚。
负数是 varint 的暗坑。标准 int32/int64 里的负数按补码存储,最高位全 1,varint 编码后必然膨胀到 10 个字节(64 位形态)。如果你的字段会频繁出现负数(温差、坐标偏移、盈亏),应该用 sint32/sint64——它们先做 ZigZag 映射(0 映 0,-1 映 1,1 映 2,-2 映 3……)把负数搬到小值区间,再走 varint,负数也只需一两个字节。
| 类型组合 | 值 5 的编码 | 值 -5 的编码 | 说明 |
|---|---|---|---|
| int32 / int64 | 1 字节 | 10 字节 | 负数按 64 位补码膨胀 |
| sint32 / sint64 | 1 字节 | 1 字节 | ZigZag 后小负数同样紧凑 |
| uint32 / uint64 | 1 字节 | 不适用 | 无负数语义 |
三、键值对:编号与线型的合体
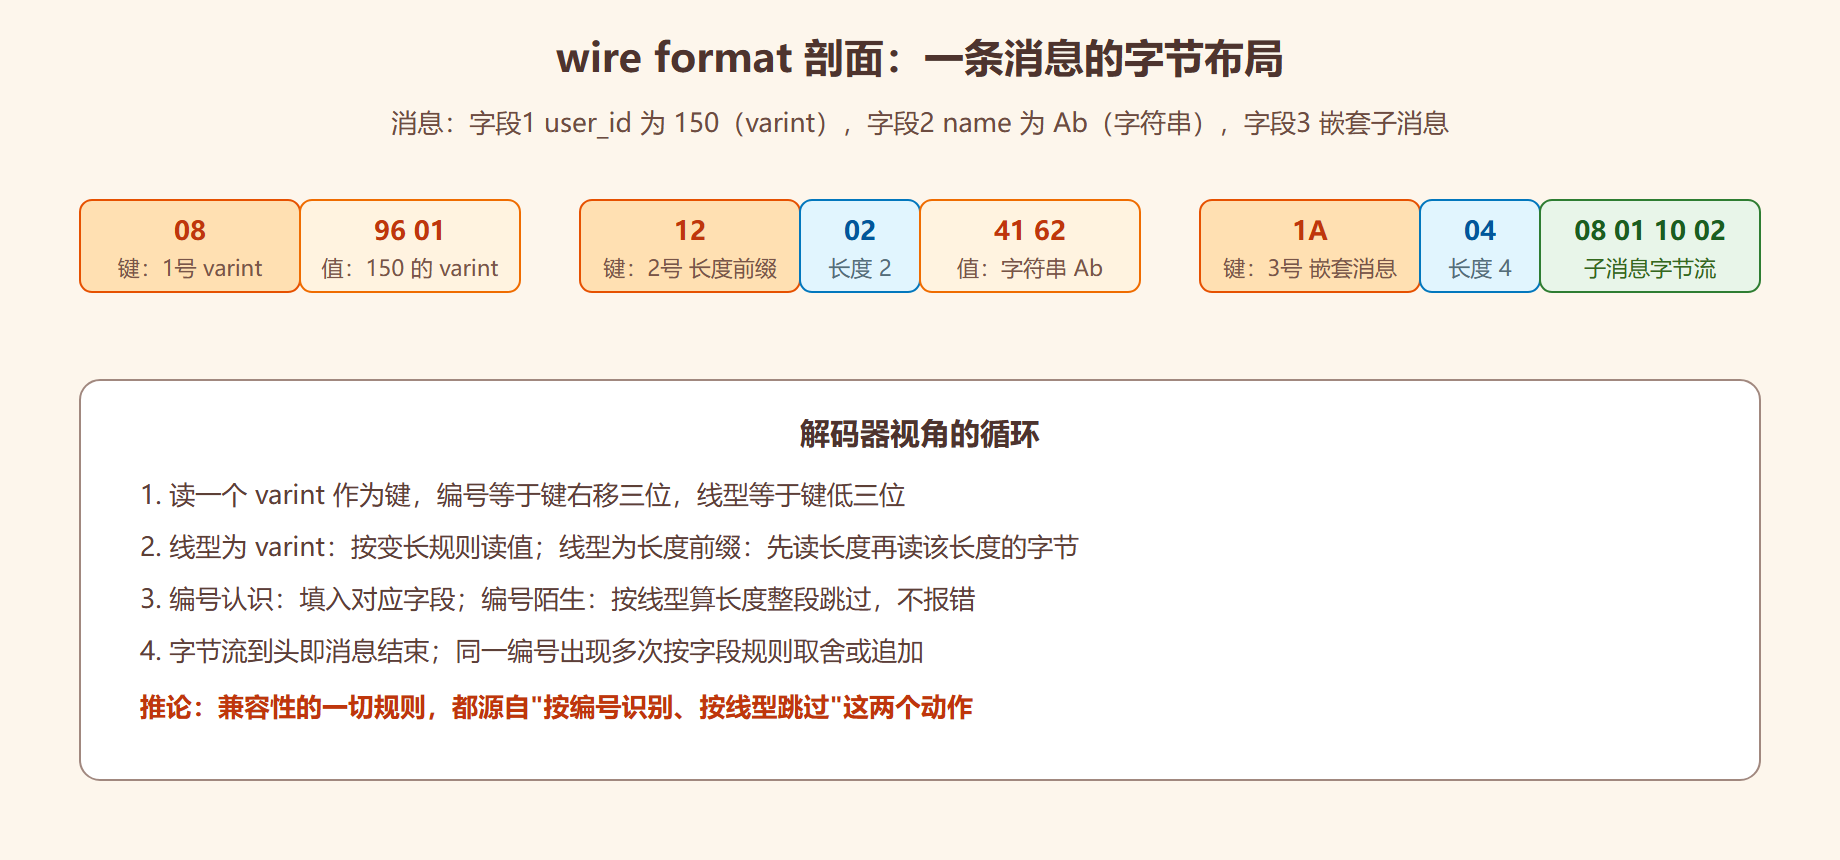
wire format 里每个字段序列化成"键 + 值"。键本身是个 varint,内容是"字段编号左移 3 位,或上线型"。线型只有几种:0 表示 varint(整数、布尔、枚举),2 表示长度前缀(字符串、字节、嵌套消息、repeated 紧凑形态),5 与 0 固定宽度的 32 位、64 位浮点等。
举例:字段编号 1、线型 0(varint)的键是 1 左移 3 位或 0,等于 8,即字节 0x08。所以"1 号字段值为 150"这条数据,完整编码就是两个字节:08 96 01(96 01 是 150 的 varint 两字节形态)。
解码方的逻辑也由此确定:读一个 varint 当键,拆出编号与线型;认识这个编号就按线型读值,不认识就按线型算出长度跳过。整个消息就是键值对的顺序排列,读到最后就是消息结尾——没有总长度字段,没有字段名,没有类型元数据。
四、长度前缀:字符串与嵌套消息的边界
线型 2 的值统一是"长度 + 字节流"。字符串按 UTF-8 编码后计量长度,字节类型直接放原始字节,嵌套消息则把子消息自身的完整编码当作字节流装进去——递归结构天然成立,深层嵌套就是多层长度前缀的嵌套。
这里藏着两个实践要点。其一,长度前缀给了"整体跳过"的能力:遇到不认识的嵌套消息字段,读一个长度就能越过去,子消息内部改得再翻天覆地也不影响外层兼容。其二,解析嵌套消息需要递归下降,恶意或意外的超深嵌套会造成栈压力,处理不可信来源的数据时要有深度限制意识。
repeated 字段的编码有两种形态:非紧凑形态(每个元素一个独立的键值对)与紧凑形态(一个键、一个总长度、元素连续排列)。标量类型默认非紧凑(可配置开启紧凑),字符串与消息类型默认紧凑。对性能敏感的大批量 repeated 数字,紧凑形态能省下可观的重复键开销。
五、兼容规则:把字节层的推论列成表
有了上面的机制,兼容性规则不再需要死记——每条都能从"按编号识别、按线型跳过"推出来。对照表如下:
| 变更操作 | 兼容性 | 字节层原因 |
|---|---|---|
| 新增字段 | 向后兼容 | 旧数据没有该编号,新读者按缺省处理;新数据多出的编号,旧读者跳过 |
| 删除字段 | 兼容(须 reserved) | 编号不再出现;不 reserved 则有复用风险 |
| 改字段名 | 兼容 | 传输格式里没有名字 |
| int32 改 int64(值域扩大) | 兼容 | varint 编码天然扩展位宽 |
| int32 与 uint32 互改 | 兼容(注意符号解释) | 位模式相同,语义由读取方解释 |
| string 与 bytes 互改 | 兼容 | 长度前缀结构一致,内容解释不同 |
| 改字段编号 | 不兼容 | 旧编号数据被解读到新字段,值错乱 |
| int32 改 string | 不兼容 | 线型冲突,解码直接失败 |
| 删字段后复用编号 | 不兼容(最隐蔽) | 旧数据静默注入新字段 |
| 改 repeated 为 singular | 不兼容 | 多次出现同编号的语义突变 |
⚠️ 常见坑:最危险的变更恰恰是编译器不报错的那种——"删掉 5 号字段,过俩月把 5 分给新字段"。新旧数据在网络与存储里共存的时间远比想象中长(消息队列的存量消息、缓存里的序列化值、离线数据集),错误注入可以潜伏数月。reserved 是唯一的防波堤。
六、工程视角的三个延伸
**体积估算能力。**有了编码知识, proto 消息的体积可以粗估:小整数字段约 2 字节(键加 1 字节值),字符串是其 UTF-8 长度加 2 字节左右,嵌套消息是子消息长度加 2 到 3 字节。做容量规划或排查"消息异常大"时,这个手算能力比盲猜靠谱。
**动态消息与反射的场景边界。**原教程把反射机制单独成节,工程视角下它的定位是"通用工具的底层能力":消息路由网关、通用代理、序列化格式转换器这类"编译期不知道具体消息类型"的程序,靠反射 API 按描述符动态读写字段;gRPC 服务端开启的反射服务,则让 grpcurl 这类工具能在线探测服务定义(第 6 章排障时用到)。常规业务代码不应该碰反射——有了编译期类型安全还去运行时动态拼字段,是自弃最大优势。
前向与向后兼容的方向感。"向后兼容"指新代码读旧数据(新增字段的场景),"前向兼容"指旧代码读新数据(跳过未知字段的场景)。wire format 的键值对设计让两者同时成立,但语义层面的兼容(新枚举值对旧业务逻辑的含义)编码层无能为力——这是 2.1 节 UNSPECIFIED 约定与第 7 章版本管理要接着解决的问题。
常见问题
问:怎么在线上快速验证一段 Protobuf 字节的字段内容?
用 grpcurl 配合服务端反射能看 RPC 层面的问题;消息层面,各语言都有"按描述符解码十六进制"的小工具( protoc 自带 decode 选项),把字节流与 proto 定义一起喂给它即可人读。这也是为什么生产环境建议保留描述符文件。
问:JSON 与 Protobuf 能同时作为序列化格式吗?
可以,Protobuf 官方定义了二进制与 JSON 两种映射。网关或调试场景用 JSON 形态,服务间通信用二进制形态,同一份契约两种表达。注意 JSON 映射会丢掉"字段未设置"的细粒度语义(除非用可选字段的 JSON 表示),别在两种形态间来回转着玩。
问:消息大到几 MB,有什么编码层的优化顺序?
先看结构:重复长字符串考虑抽出编号字典或改引用;负数密集字段换 sint 系列;大批量 repeated 标量开紧凑编码;仍然大就上消息级压缩(gRPC 的 gzip 或自定义压缩器,第 6 章性能调优展开)。结构优化的收益通常大于压缩,且没有 CPU 代价。
问:怎么快速验证一次 proto 改动是否兼容?
最直接的办法是双向用例:用旧版本代码序列化一批代表性消息存成二进制文件,新版本代码反序列化后核对字段;再反向做一遍(新序列化、旧反序列化)。把这两个方向的用例放进 CI,每次契约变更自动跑——兼容性从"评审时小心"升级为"流水线强制",这才是长期可靠的做法。
本章回顾
- wire format 是键值对序列:键是"编号移位加线型"的 varint,值按线型编码,没有字段名与总长度字段。
- varint 按需分配宽度:小值 1 字节、值 300 两个字节;负数在 int 系列里膨胀到 10 字节,频繁负数字段用 sint 系列(ZigZag)。
- 长度前缀是递归与跳过的基石:字符串、字节、嵌套消息统一"长度加字节流",未知嵌套可整体越过。
- 兼容规则全部可推导:新增兼容、改名兼容、扩宽兼容;改编号、线型冲突、复用已删编号是三大雷区。
- 最隐蔽的事故是编号复用:错误注入无声且可潜伏数月,reserved 锁坑是唯一防线。
- 反射是工具的底层能力而非业务手段:网关、代理、调试器用它,业务代码远离它。
- 兼容验证可以自动化:新旧版本双向序列化用例进 CI,把"评审时小心"升级为"流水线强制"。
契约与编码这两层"说什么"讲完了,下一章进入"怎么送到":HTTP/2 的多路复用、流与帧如何支撑 gRPC,四种通信模式在传输层又是怎么落地的。