3.3 四种通信模式与流式RPC实战
3.3 四种通信模式与流式 RPC 实战
本节摘要:gRPC 的四种通信模式——一元、服务端流、客户端流、双向流——在 proto 里只是一个 stream 关键字的差别,在传输层却对应不同的帧序与生命周期。本节给出四模式的选型判据与工程要点:背压感知、消息边界、取消传播、超时策略,最后划定"不该用流"的边界,避免把流式当炫技。
本节导航
阅读完本节,你应当能够:
- 为推送、上报、对话、查询四类交互选定通信模式并说明理由;
- 解释背压在流式调用中的传导路径与正确的消费姿势;
- 说出流式调用中取消与超时的传播行为;
- 识别三种"不该用流"的反模式;
- 在代码层面落实流式接口的错误处理与资源释放纪律。
一、先看选型:四种模式对号入座
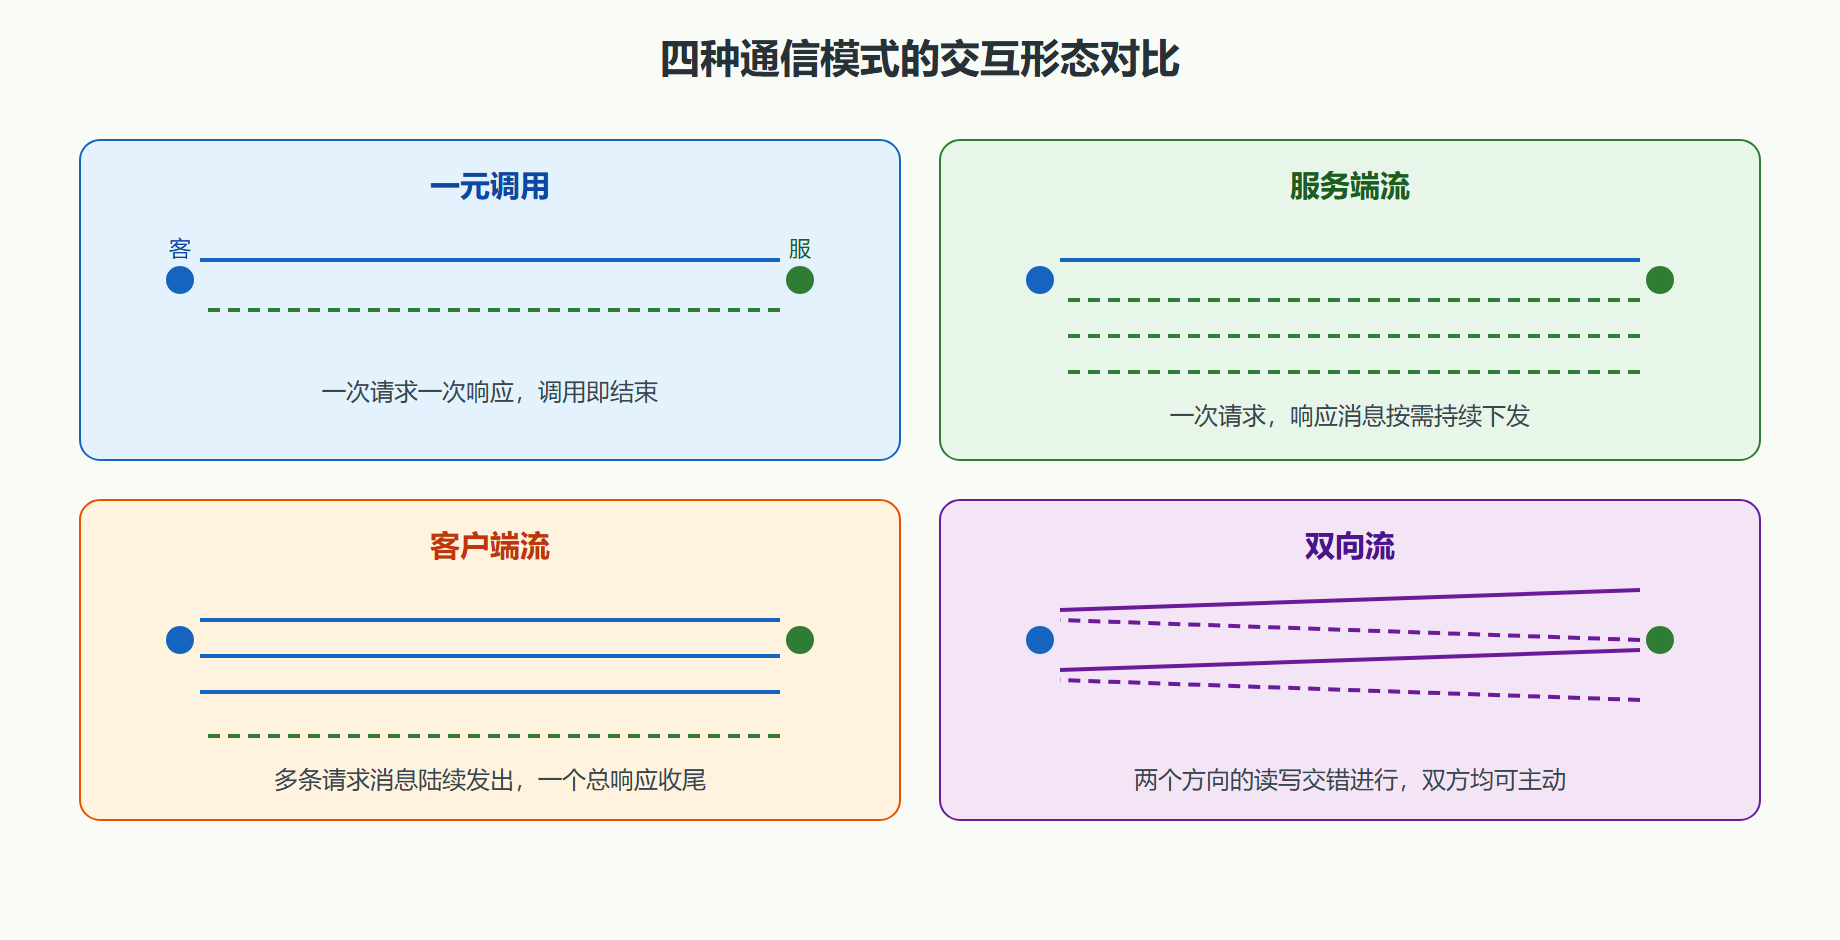
四种模式可以按"谁在持续说话"来记忆:
| 模式 | 交互形态 | 典型业务 | 别用它做的反例 |
|---|---|---|---|
| 一元 | 一问一答 | 查订单、扣库存、鉴权 | 没必要上流的绝大多数调用 |
| 服务端流 | 一问多答 | 行情推送、日志拉取、大结果分页 | 伪装成多次一元的轮询 |
| 客户端流 | 多问一答 | 批量上报、文件分块上传、聚合投票 | 逐条调用再自己聚合 |
| 双向流 | 双方随时说 | 实时对话、协同编辑、设备控制 | 低频双向却追求"高级感"的交互 |
选型的第一判据是交互的事实形态:业务上确实是一问一答,就用一元,别为了"未来可能要推送"提前上流——流式调用的测试、超时、重试成本都高于一元(后文展开),提前设计的灵活性大概率变成维护负担。
第二判据是消息的规模与节奏:结果集大到需要分页,服务端流比"翻页循环调用"少了每轮握手与鉴权;高频上报的场景,客户端流把 N 次调用合并成 1 次连接内传输。
二、服务端流:推送与大批量拉取
服务端流在 proto 里的声明是返回类型前加 stream(回顾 2.1 节的 WatchStatus)。客户端发一条请求,服务端按节奏回 N 条消息,最后 trailers 收尾。
传输层视角:请求占用流的前半段,响应消息共享同一条流依次下发。服务端"按节奏"三个字是关键——HTTP/2 流控(3.1 节)会感知客户端的消费速度:客户端读得快,窗口扩大,服务端可以放心发;客户端处理不过来,窗口收紧,服务端的发送自然被节流。这套背压传导对业务代码是透明的,前提是你正确地"按需消费"——收到一条处理一条,别开个大缓冲区先把消息全囤起来,那样等于亲手拆掉了背压保护。
两个业务侧要点。其一,消息边界:流里的每条消息是独立 Protobuf 消息,别指望"半条消息",框架保证边界完整;状态类事件建议每条消息带序号或时间戳,消费端能检测断流重连后的缺口。其二,结束语义:服务端主动结束(正常 trailers)与异常结束(错误状态)要分开处理,前者可能意味着"订阅到此为止",后者要决定重连策略。
典型实现骨架(服务端以 Go 风格示意,概念各语言通用):业务方法拿到流对象后循环发送消息,每个发送都可能阻塞(背压生效的表现),客户端断开时发送返回错误,方法返回结束流。
三、客户端流:批量上报与聚合
客户端流是参数前加 stream:客户端陆续发 N 条请求消息,发完声明结束,服务端返回一个总结果。
适用判断有一条清晰的线:"多条输入、一个结论"。传感器逐条上报、计算端最后回一个统计值;文件分块传输、接收端最后回校验结果;投票逐张提交、主持人最后唱票。反过来,如果每条输入都需要独立的即时反馈(每传一块要立刻知道成没成功),客户端流不合适——它只有一个总响应,中间过程没有应答。
工程上要处理**"结束声明"与"中途放弃":客户端发完后显式声明输入结束(对应流的半关闭),服务端才开始计算总响应;客户端中途出错要主动取消,让服务端及时停止接收与计算,别等超时自然腐烂。批量上报的另一个隐性收益是弱网下的成功率**:一条连接内发完所有分片,比 N 次独立调用少 N 次握手与 N 次鉴权,总成功率对连接抖动的敏感度下降。
四、双向流:最强大也最易滥用
双向流两边都加 stream,双方各有独立的发送与接收节奏,读写可以完全交错。它同时具备两条独立通道的表意能力和一条流的传输经济性。
真正的用武之地是"双方都是驱动者"的交互:即时通讯里任意一方随时说话;协同编辑里双方持续同步状态;设备网关里控制指令下行与遥测上行并行。这类场景用两条独立的一元或单向流组合也能实现,但要自己处理两条调用的关联、关闭顺序与资源双倍开销——双向流把这些收进一个调用生命周期。
滥用的形态也很典型:把双向流当"高级的一元"用,实际交互还是请求-响应的固定节拍;或者把本该由消息队列承载的多方广播塞进双向流(一条流只有两端,广播要服务端为每个订阅者各开一条流,复杂度爆炸)。判断标准回到第一节的判据——双方是否真的都需要随时主动,不是的话退回简单模式。
开发纪律上,双向流的读写常分别在两个并发单元里进行(一个专职收、一个专职发),要格外注意:任一方向出错都要触发整个调用的取消;退出时两个方向的句柄都要关闭;别在一端死循环里忘了检查上下文的取消信号。
五、流式调用的横切问题
取消传播。流式调用的取消会沿调用链传播:客户端取消(无论主动还是超时触发),服务端的流上下文立即收到信号,正在进行的发送与接收全部中断。这既是资源释放机制,也是控制通道——客户端可以通过取消表达"我不要了",服务端据此停止计算。实现纪律:服务端的循环体要周期性检查上下文取消状态,别在单次重计算里闷头跑到天荒地老。
超时预算。流式调用的 grpc-timeout 覆盖整个调用生命周期,包括所有消息的收发——这经常被误解为"每条消息的超时"。长时间运行的订阅类流式调用,要么设置足够大的预算,要么用应用层心跳维持(消息级别的活跃信号),让"超时"表达"整个交互的耐心上限"而非"单条消息的耐心"。第 5 章会把 deadline 体系与重试、熔断放在一起讲。
重试的边界。一元调用可以放心重试(幂等前提下);流式调用的重试要谨慎——重放一条已经发了一半的流,成本与语义都复杂。通用建议:流式调用的可靠性靠断线重连加断点续传语义(应用层序号)解决,而不是协议层自动重试。
⚠️ 常见坑:服务端流被客户端"暴力消费"——开一个巨大的缓冲通道,把服务端发来的消息全囤进去。背压失效后,慢消费演变成内存膨胀,最终在消费者侧 OOM。流的健康形态是"消费速度决定生产速度",任何打破这个回路的做法都要三思。
💡 关键直觉:一元模式是默认,流是特例。每上一个流式接口,问自己三个问题——交互形态确实如此吗?背压与取消处理好了吗?测试与排障的复杂度愿意承担吗?三个都过再写 stream 关键字。
常见问题
问:一条服务端流能持续多久?
协议上没有上限,工程上受连接寿命、代理空闲超时、发布重启节奏约束。长期订阅要有应用层心跳与自动重连,把"连接断了"当常态处理。
问:客户端流可以中途拿到部分反馈吗?
标准语义下不能,总响应只有一个。需要过程反馈就退回多条一元调用,或改双向流由服务端侧下发进度消息。
问:流式调用怎么测试?
重点测三态:正常收尾、中途错误、客户端取消。用错误注入让服务端在特定消息后失败,验证客户端的重连与缺口检测逻辑。这比只测 happy path 重要得多。
问:四种模式在监控指标上有什么形态差异?
一元调用的 QPS 与在途请求数比值接近平均耗时;服务端流看"每调用平均消息数"(突然变大可能是消费者变慢或服务端产出异常);客户端流看"每调用平均上传消息数";双向流的长寿特征是"在网流数"指标显著且稳定。给不同模式配不同的告警形态,比统一按 QPS 告警灵敏得多——这是第 6 章指标体系在流式场景的落地细节。
问:一个流里消息大小不均,会有问题吗?
会有一个隐性影响:单条超大消息会独占流的传输(消息不可分割地阻塞该流的后续消息),消息间的节奏被打破。设计上尽量让流内消息粒度均匀(大对象拆片),或把"控制消息"与"数据消息"分开传输,避免一条大消息卡住心跳类小消息。
一节小结
- 选型第一判据是交互的事实形态:一问一答用一元,一问多答用服务端流,多问一答用客户端流,双方随时说才用双向流。
- 服务端流的背压是免费的保护,前提是逐条消费,囤积消息等于亲手拆除保险丝。
- 客户端流的标志是"多条输入一个结论",需要逐条即时反馈的场景不适合。
- 双向流留给"双方都是驱动者"的交互,拿它当高级一元或广播总线都是滥用。
- 取消是控制通道:客户端取消立即中断服务端计算,服务端循环要周期检查取消信号。
- 超时预算覆盖整个流生命周期,长订阅靠应用层心跳与重连保障可靠性,而非协议重试。
- 每上一个流式接口前过三问:形态真实、背压取消就绪、复杂度可承担。
传输层的三节到此完成。下一章视角上移到 gRPC 自身的骨架:分层架构、客户端三件套与服务端并发模型——看看框架在你和协议之间还垫了哪些层。