6.2 可观测性三支柱落地
6.2 可观测性三支柱落地
本节摘要:可观测性由指标、日志、链路追踪三支柱构成,分别回答"系统的整体健康如何"、"单个事件发生了什么"、"一次请求经历了什么"。本节讲三支柱在 gRPC 上的标准接入方式(多数已内置或半内置)、五个核心指标与访问日志的黄金字段、链路追踪的传播机制,最后用一个从告警到根因的完整案例把三支柱串成排障工作流。
本节导航
阅读完本节,你应当能够:
- 说明三支柱各自的分工与不可替代性;
- 为 gRPC 服务接入标准指标与访问日志;
- 配置分布式追踪并解释上下文如何跨服务传播;
- 用三支柱工作流完成一次端到端排障;
- 建立告警指标体系并避免告警疲劳。
一、三支柱的分工:为什么是三个不是两个
先讲清三个支柱各自回答什么问题,混用是常见误区:
指标是聚合的时间序列——"过去一小时,订单服务的 P99 延迟与错误率如何"。它擅长发现异常(偏离基线)、看趋势(恶化还是好转)、做容量规划;不擅长回答"具体哪次调用出的问题"。
日志是离散的事件记录——"14 点 32 分 01 秒,这次调用被限流拒绝了,调用方是风控服务"。它擅长单个事实的细节与上下文;不擅长全局视角(百万条日志里找模式很费劲)。
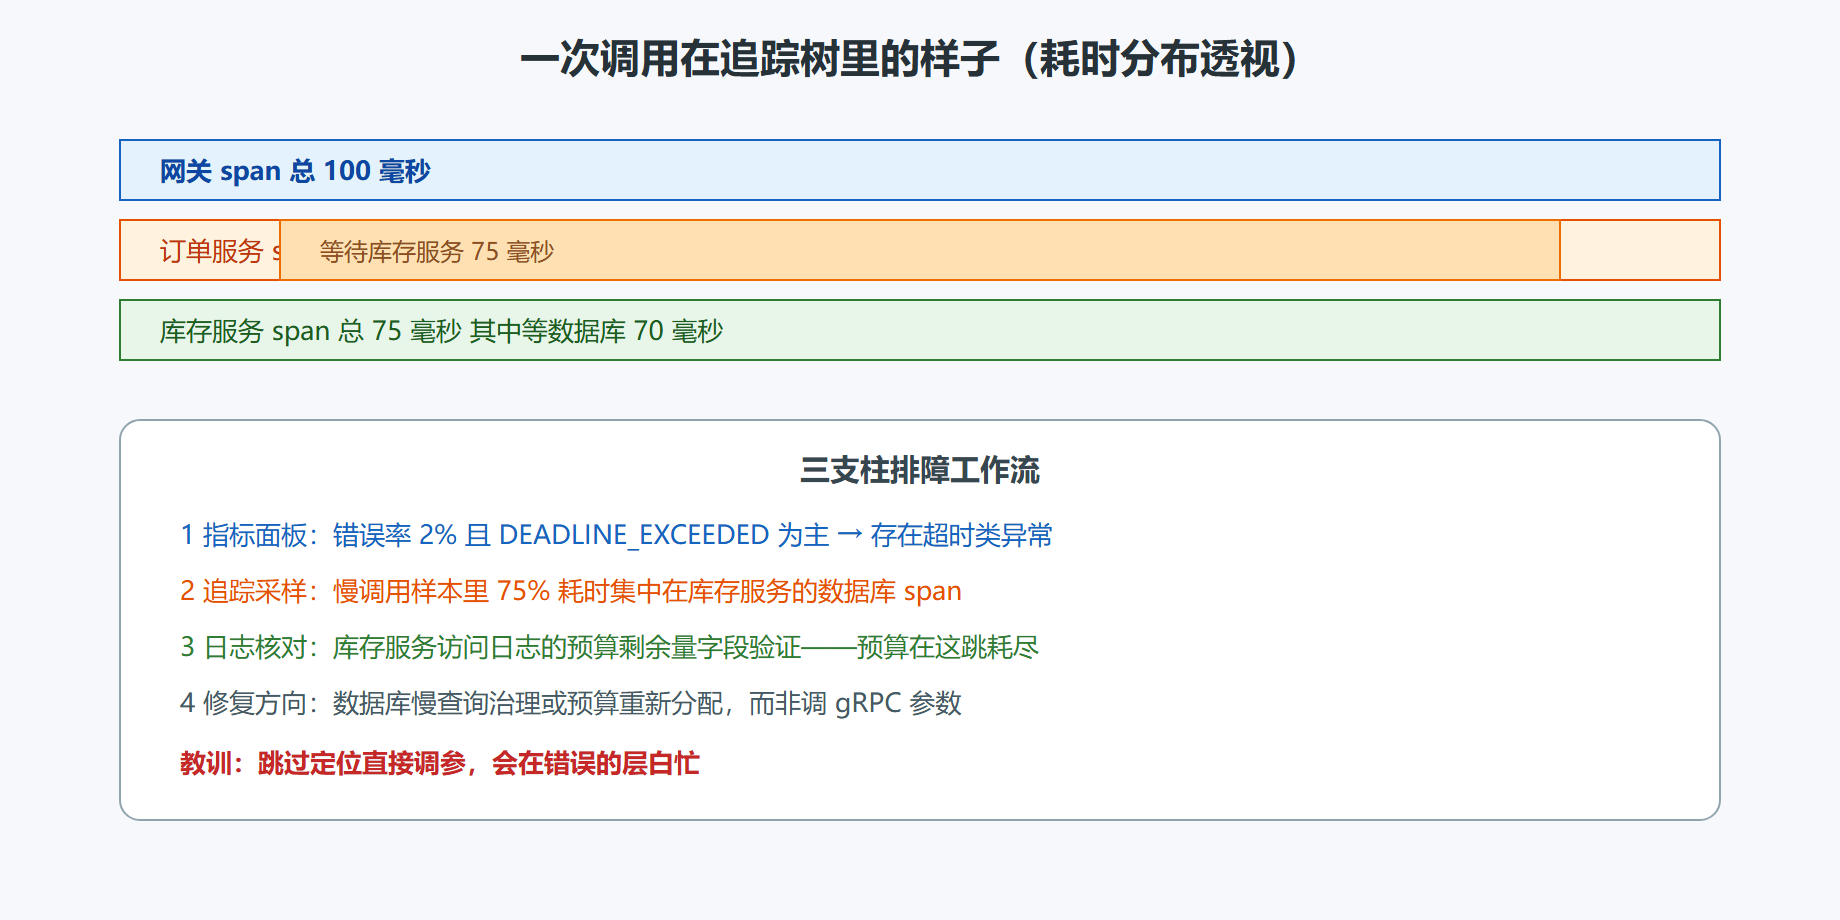
链路追踪是请求视角的树——"这次下单请求经过了网关、订单、库存三个服务,耗时分别 5、80、15 毫秒,库存服务的 80 毫秒里 75 毫秒在等数据库"。它擅长跨服务的因果与耗时分布;不擅长存储每个细节(采样是常态)。
三者关系:指标发现问题存在 → 追踪定位问题在哪段 → 日志还原那一瞬的细节。缺任何一环,排障链条就断。
gRPC 的好消息是三支柱都有官方或事实标准的接入面,不需要从零造轮子。
二、支柱一:指标
gRPC 各语言实现内置了标准指标体系,维度统一:服务名、方法名、状态码是标配的标签维度,部分实现还带调用方标识。核心指标五个,每个都有明确的告警语义:
| 指标 | 回答什么 | 告警锚点 |
|---|---|---|
| 请求速率 | 流量形态与突变 | 环比突降(可能上游故障) |
| 错误率 | 失败占比(按状态码分) | 非 OK 占比超阈值(如 1%) |
| 延迟分位数 | P50、P95、P99 耗时 | P99 超过 SLO |
| 在途请求数 | 当前并发存量 | 持续逼近容量上限 |
| 消息尺寸 | 载荷分布 | 异常大消息(配合 6.1 的尺寸判断) |
错误率要按状态码拆开看,笼统的错误率会掩盖结构性问题:UNAVAILABLE 占比升高是连接与实例问题(5.2 的领域)、DEADLINE_EXCEEDED 升高是下游慢或预算设置问题(5.3 的领域)、RESOURCE_EXHAUSTED 升高是限流在起作用(可能是过载保护的正常表现也可能是误配)。状态码是 gRPC 观测的一等公民,把它当标签用足。
告警纪律:每个告警对应一个"收到后会采取行动"的预案,否则删掉;用错误预算(SLO 允许的失败额度)驱动告警而非固定阈值,避免低流量时段的误报(一小时 10 个请求错 1 个就是 10%,但毫无统计意义)。
三、支柱二:日志
gRPC 的访问日志核心是 5.1 节日志拦截器的结构化输出,黄金字段清单(客户端与服务端各记一套):
- 身份组:调用方身份、服务名、方法名;
- 结果组:状态码、耗时、重试次数;
- 上下文组:追踪标识(关联三支柱的钥匙)、目标实例、请求标识;
- 可选组:消息尺寸(记录量级即可)、超时预算与剩余量。
预算剩余量值得单独点名:5.3 节留的悬念——"超时到底超在哪一跳"——在这里兑现。每次调用记录"收到时预算剩余量、处理完时预算剩余量",两个数字一减,这一跳消耗了多少时间预算一目了然,链路上哪一跳吃掉了耐心直接可算。
日志的纪律:访问日志(每次调用一条)与业务日志(业务事件)分开;日志里不打消息内容(体积与敏感信息风险),要细节时靠追踪与请求标识回查;错误路径必须记全(5.1 节的纪律重申)。
四、支柱三:链路追踪
追踪的单位是 trace(一次端到端请求的全程)与 span(一个服务段的处理记录,含起止时间与标签)。gRPC 场景下 span 天然与服务调用对齐:每次 RPC 一个 span,嵌套调用形成树。
接入的两个半组件:
传播。5.1 节的追踪拦截器成对埋点:客户端把当前 trace 标识写进元数据(标准化的传播头部),服务端读取并延续——一次调用的身份跨服务不断线。标准化传播格式(如 W3C 的 traceparent)保证异构语言的服务链能接上同一棵树。
上报。span 数据异步批量发给后端(Jaeger、Zipkin、云厂商的追踪服务或 OpenTelemetry 收集器)。采样是常态——全量追踪的存储成本不可承受,按比例采样(如 1%)加错误与慢调用全采(尾部采样策略)是主流配置:正常请求看比例,异常请求必留全尸。
半个组件:与指标联动。追踪不是孤岛,span 聚合统计出的延迟分布与服务端指标应该对得上——对不上本身就是信号(比如指标统计了拦截器外的时间,追踪只算了方法内时间,口径差异要搞清)。
OpenTelemetry 值得点名:它统一了指标、日志、追踪三支柱的埋点与传输标准(合称 OTel 体系),gRPC 各语言接入都有现成库。新项目直接从 OTel 起步,避免三支柱三套 SDK 的历史包袱。
OTel 体系下数据从产生到可视化的路径是标准化的三段:应用内的 SDK 埋点(gRPC 拦截器是天然挂载点)把数据发给本机或近端的收集器(collector),收集器做批处理、脱敏、路由,再转发给存储与展示后端。中间加收集器这一段的价值常被低估:应用只管低开销地吐数据,重活(重试、缓冲、格式转换、多后端分发)由可独立扩缩的收集器承担——发布新后端或调整采样策略时,应用一行代码不动。
五、案例复盘:一次完整的排障
把三支柱串成一个真实形态的排障流程(数据为示意):
第 0 步,告警触发。指标体系报:订单服务调用库存服务的错误率从 0.05% 升到 3%,主因 DEADLINE_EXCEEDED,P99 延迟从 40 毫秒涨到 2 秒。指标告诉我们:问题存在,类别是超时,位置在订单到库存这条依赖上。
第 1 步,追踪看分布。打开慢调用样本的追踪树:库存服务 span 内部,等数据库的 span 占了 1.8 秒;而库存服务自身的 CPU、GC 都正常。追踪告诉我们:慢在库存服务调数据库这一段,不在 gRPC 通信层。
第 2 步,日志还原细节。库存服务的访问日志按请求标识过滤:从某时刻起,数据库查询耗时整体抬升,且集中在某几张表的查询;再对照发布记录,那个时刻有一次索引变更上线。日志告诉我们:具体哪些查询慢了,时间点与变更对上。
第 3 步,处置与复盘。回滚索引变更,指标回落。复盘产出两条:变更流程补上"数据库变更要评估对线上查询的影响";访问日志里加上查询模式标识字段,下次定位更快。
这个案例的要点:三步走完没有一步在调 gRPC 参数——这不是否定第 6.1 节的价值,而是说明观测先行的顺序性。gRPC 层的参数问题(连接、窗口、压缩)在第一步的指标形态里就有特征,本案的指标形态(下游数据库段慢)直接把排查引离了 gRPC 层。
⚠️ 常见坑:追踪采样配成"头部按比例采样"后,错误请求也被采样掉了——排障时抓不到异常样本。错误与慢调用的尾部保留策略要在采样配置里显式声明。
💡 关键直觉:三支柱的成本与价值排序——指标最便宜必上全量,日志按调用记访问日志,追踪采样但要保异常全量。预算有限时的建设顺序也是这个序。
常见问题
问:三支柱的数据会不会本身拖慢服务?
接入成本存在但可控:指标聚合是内存操作、日志异步批量写、追踪采样后上报量小。要警惕的是过度埋点(业务方法里高频打点)与同步阻塞式日志——异步化与批量是标准解法。
问:跨消息队列的调用链能连上吗?
标准传播头能通过消息属性传递(生产端写、消费端读),OTel 生态有现成方案。链路会跨异步边界延续,但时间轴上不连续(排队时间体现为 span 间隙),解读时要意识到这一点。
问:客户端和服务端的 span 都要开吗?
都要。只有服务端 span 看不到网络与排队耗时;只有客户端 span 看不到服务端内部分布。两边都开,树才完整——客户端 span 与服务端 span 通过 trace 标识自然聚合。
重点提炼
- 三支柱各答一题:指标答整体健康、日志答单事件细节、追踪答单请求路径,串联成"发现→定位→还原"的排障链。
- 五个核心指标:速率、错误率、延迟分位数、在途数、消息尺寸;错误率必须按状态码拆解。
- 访问日志黄金字段:身份、结果、上下文三组,预算剩余量字段兑现"超时超在哪跳"的定位能力。
- 追踪靠标准传播头跨服务接线:比例采样加异常全采是主流,OTel 是三支柱的统一接入面。
- 排障工作流:指标发现问题类别 → 追踪定位问题段落 → 日志还原事件细节,顺序不可跳。
- OTel 是三支柱统一接入面:应用埋点、收集器中转、后端存储三段式,重活留给可独立扩缩的收集器。
- 告警纪律:每个告警配行动预案,用错误预算驱动阈值,防告警疲劳。
至此性能与观测齐备。最后一章走向生态与长期主义:gRPC-Web 与协议转码打通浏览器与开放 API,服务网格把治理下沉到基础设施,版本管理让契约优雅地活过一次次演进。