3.3 强一致性:读己之写如何成立
3.3 强一致性:读己之写如何成立
本节摘要:MinIO 对所有读写操作提供强一致性——写入一旦返回成功,任何客户端立即读到的都是新版本,没有"最终一致"的窗口期。本节讲清这条承诺靠什么兑现(写仲裁与元数据共识),它能简化哪些应用设计,以及它的边界在哪里。
一个让无数系统翻车的老问题
分布式存储的经典陷阱:客户端 A 写入成功,客户端 B 紧接着去读,拿到的却是旧数据——过一会儿再读,又变新了。这就是"最终一致性"的窗口期,对象存储的老前辈们大多带着这个脾气。窗口期逼着应用层加各种补丁:写完强制 sleep、用外部队列串行化、读两次做比对。MinIO 把这条承诺直接写进了架构:read-after-write,写成的瞬间全集群可见。本节要做的两件事是:拆开承诺看机械结构,画清楚承诺的适用边界。
承诺靠什么兑现:两道仲裁
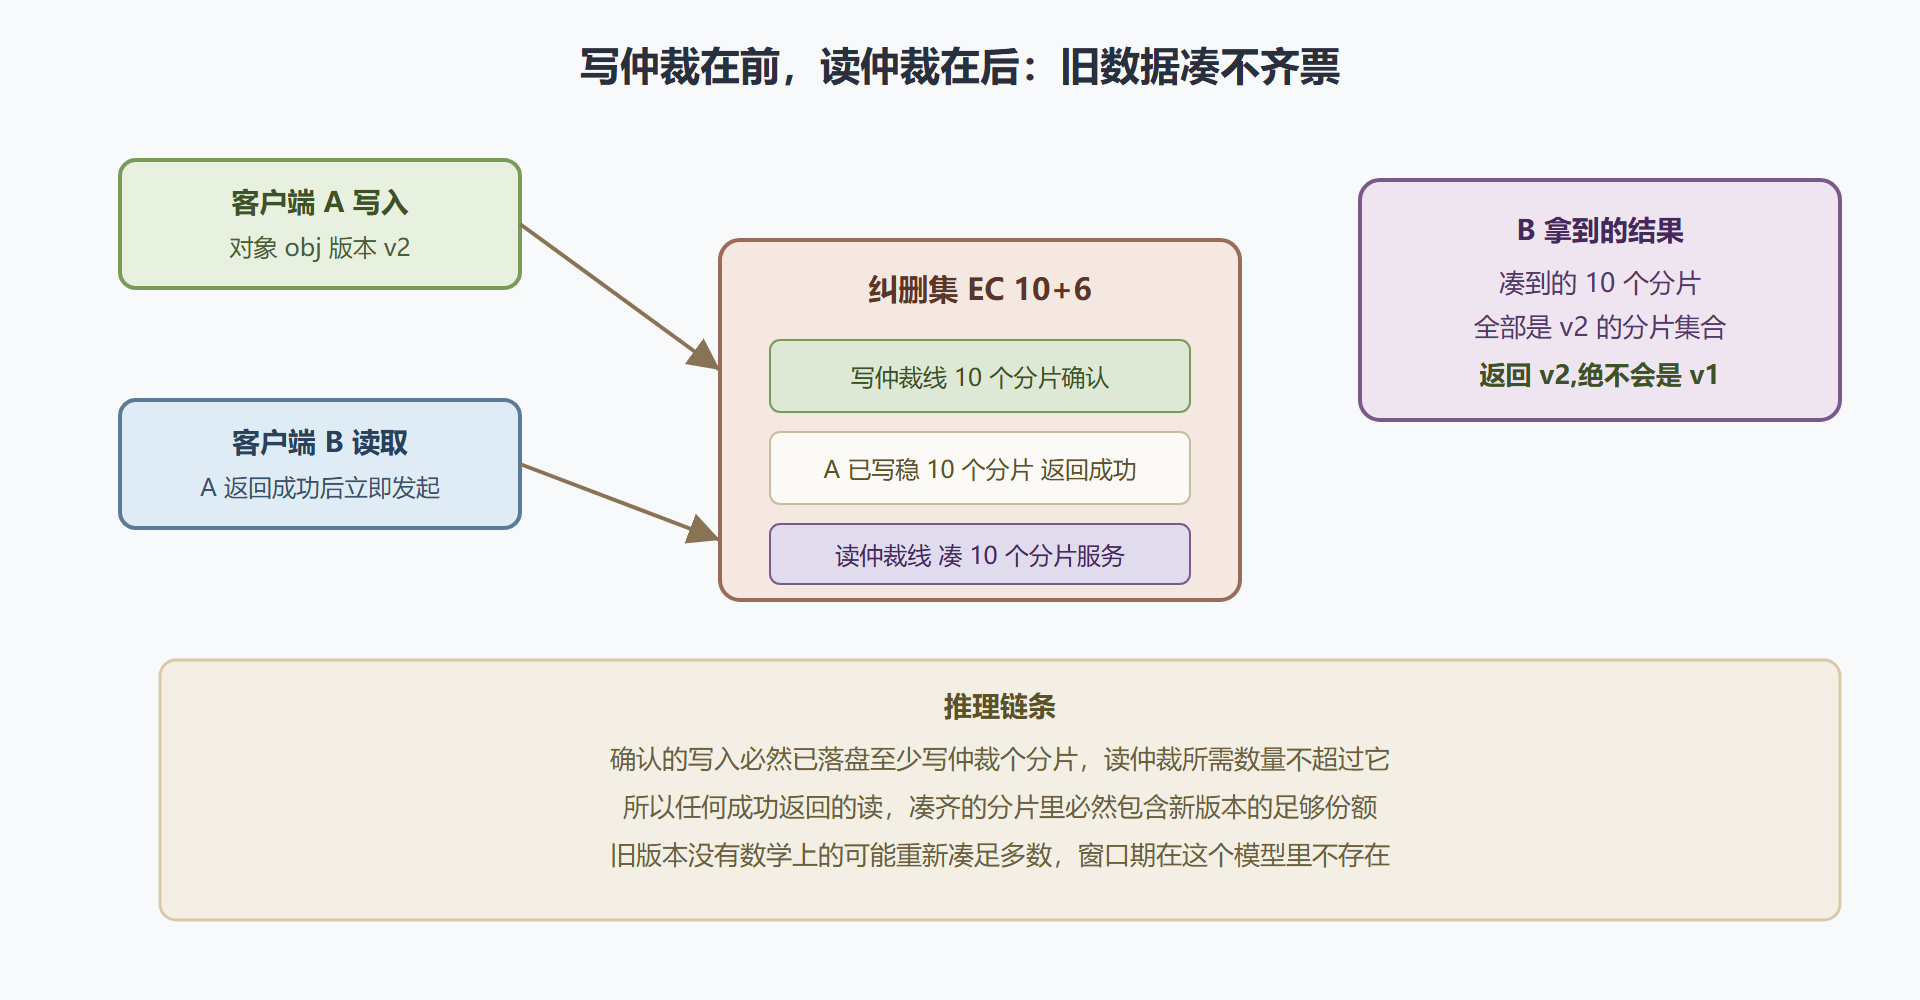
回忆 1.2 的落位模型:每个对象属于一个纠删集,分片散在集内各盘。写入路径上的第一道仲裁是写仲裁:一次写操作要等到"数据分片数 k 与校验分片数中较大的那个值"数量的盘确认落盘,才向客户端返回成功。以 EC 10+6 为例,写仲裁数是 10——16 个分片里至少 10 个写稳,写入才算数。第二道仲裁是读仲裁:读操作只需要凑齐 k 个分片即可服务,凑不齐(坏得太多)就报错而不是返回旧数据。
这两道仲裁合起来产生一个关键性质:任何一次被确认的写入,其分片必然超过读仲裁所需的数量。所以读操作总能凑到含新版本的 k 个分片——旧版本根本凑不齐足以冒充新数据的票数。这不是巧合,是配比设计的一致性下限:校验分片越多的配置,一致性冗余越厚。
元数据层面的共识由纠删集内部分片的元数据信息(xl.meta)承担:每次写入更新的是分片自带的元数据,不存在一个独立的"元数据主节点"需要同步。查询对象是否存在、版本几何,请求落到纠删集后由集内多数派回答,多数派决议天然排除了脑裂状态下读到"幽灵对象"的可能。
图 3-2 一次并发读写如何被仲裁分开
这条承诺帮你省掉了什么
强一致不是玄学荣誉,是实打实的工程减负。三处最受益的地方:
任务队列与状态机。很多系统用对象存储存任务状态文件("任务开始""任务完成"),弱一致下消费者可能读到过期的"未开始"重复执行。MinIO 上这类模式可以直接写,不用外挂协调。
配置分发。服务配置以对象形式存放,写完即全网可见,灰度发布不用设计"配置生效延迟"的补偿逻辑。
测试的可重复性。集成测试断言"写入后立即可读",在最终一致系统里要写重试轮询,在 MinIO 上是普通断言——单测跑得又快又稳。
第 8 章的事件通知会把这条承诺用到极致:对象写入事件触发下游函数,下游立即拉取该对象必然拿到完整内容,生产者与消费者之间不需要握手协议。
边界:强一致不保证的三件事
承诺有边界,画清楚比宣传更重要。
边界一:覆盖写的语义。 未开版本控制的桶里,并发写同一个键是"后写者胜",但两个写操作本身的先后由到达顺序决定,MinIO 不做跨客户端的写写串行化裁决——需要"比较并交换"语义的场景,用版本控制加条件写(第 5 章)或者上层加锁。
边界二:列出操作的一致性口径。 写入后立即 List,新对象一定出现;但正在上传中的分段对象(multipart)在完成(Complete)之前不会出现在列表里。用分段上传做"先传后立"的应用要记得:对象可见的时点是 Complete 调用返回,不是第一块分片上传成功。
边界三:跨集群的复制延迟。 强一致只在单集群内成立。5.4 的站点复制是异步的,主站写入成功不等于备站已同步——跨站读写的应用必须自己面对复制延迟,这是 5.4 的核心议题。
💡 关键直觉:强一致省掉的是"读改写竞态"里的防御代码,不是"并发写同一键"的裁决逻辑。前者交给存储,后者仍然属于你的应用设计。
案例:一次秒杀库存的迁移复盘
背景:某电商把秒杀活动的库存标记文件从自研的缓存加定时落盘方案迁到 MinIO。旧方案的痛点是缓存与落盘层的最终一致窗口,活动高峰出现超卖。
操作:迁移后库存标记只存 MinIO 对象:活动开始前写入初始库存对象,扣减走"条件写"——读取当前版本号、计算新值、带版本号提交,版本不符则重试。配合每秒数百次的小对象更新,集群稳定承载。
结果:活动全程零超卖、零少卖,应用代码比旧方案少了两个补偿模块。
解读:这里强一致解决的是"读到的一定是最新"(省掉补偿模块),而真正的并发裁决靠的是版本号条件写(第 5 章的版本控制)——存储的承诺与应用的设计各管一半,缺一不可。
变式:若更新频率涨到每秒万次,单对象的版本竞争会成为热点,正确的设计不是继续拧单键,而是把库存拆成多个子键分片扣减——热点问题在任何存储上都是分片问题。
本节要点回顾
- 承诺是 read-after-write:写入成功即全集群可见,没有最终一致的窗口期。
- 机制是双仲裁:写仲裁保证新版本落盘份额,读仲裁保证旧版本凑不齐冒充的票数。
- 受益的是读改写链路:任务状态、配置分发、测试断言都能删掉防御性重试。
- 三条边界要背下来:并发写同键无裁决、分段上传 Complete 才可见、跨集群复制是异步的。
底座的三根支柱——编码、自愈、一致——到此立稳。第 4 章处理长大成仓的问题:架构怎么演化,扩容怎么做才不翻车。
应用侧的三个配套模式
一致性承诺要配合正确的使用姿势才能兑现价值。三个模式来自真实项目的代码评审,逐一说明。
模式一:条件写替代检查后写。 "先 GET 判断再 PUT"是两个操作,中间存在竞态窗口;带版本号的条件写把判断与写入合成一个原子动作。3.3 开头那个读改写老问题,正解从来不是加 sleep,而是换成条件写。
模式二:键命名带归属前缀。 并发写同一个键的裁决是不可依赖的,那就让并发写不落在同一个键上:任务输出按任务号落键、分片数据按分片号落键。键设计的一次用心,省掉下游所有的竞态防御。
模式三:写入后校验用 ETag。 强一致保证"读到的是刚写的",客户端传输层仍可能出现位错误。对完整性敏感的写入,把返回的 ETag 与本地校验值比对一次,把传输层与存储层的校验链条接起来——3.2 的指纹管存储内部,ETag 管你到存储之间。
三个模式合起来的心法是:存储给出的每一层保证,都对应应用侧可以删掉的一段防御代码;存储不给的保证,应用侧一行都不能省。边界的清醒,比承诺的强度更重要。