5.4 站点复制与异地同步
5.4 站点复制与异地同步
本节摘要:站点复制(Site Replication)把多个 MinIO 集群绑成一个逻辑整体:对象、桶配置、IAM 策略在站点间双向同步,任一站点可独立承载读写。本节讲清它的同步范围、异步延迟与冲突行为,以及一套双机房方案从评估到验收的完整路径。
从"桶复制"到"站点复制"
MinIO 早期的复制能力是桶级的:配置一条规则,把 A 集群的某个桶单向同步到 B 集群。桶复制至今仍有用武之地(比如只挑特定桶做跨云归档),但作为容灾方案它有三个先天缺口:IAM 与策略不同步(备站开不了门)、桶配置各自漂移(两边的生命周期规则各改各的)、单向语义(备站写入不回流)。站点复制把这些缺口一次补齐:加入复制组的所有站点互为对等方,对象与配置双向流动,任何一个站点都能独立承接全部业务。
同步范围值得完整列一遍,它决定了"备站到底备了多少":对象数据与元数据、桶(含建桶与删除)、桶的生命周期与锁定配置、IAM 用户与策略、匿名访问设置、加密配置。一句话,你在一个站点做的一切,会在其余站点重演——这正是"逻辑整体"的含义。
# 在三个站点上分别添加对等方(以两个站点为例) mc admin replicate add fleet-a fleet-b # 查看复制组状态 mc admin replicate info fleet-a # 对象级的同步健康:检查某个桶的复制积压 mc replicate status fleet-a/backup-bucket
异步是物理事实:延迟与带宽的现实
站点复制是异步的。主站写入返回成功时,数据开始排队流向对等站,跨机房链路的带宽决定积压消化速度。这带来两个必须写进设计的推论:
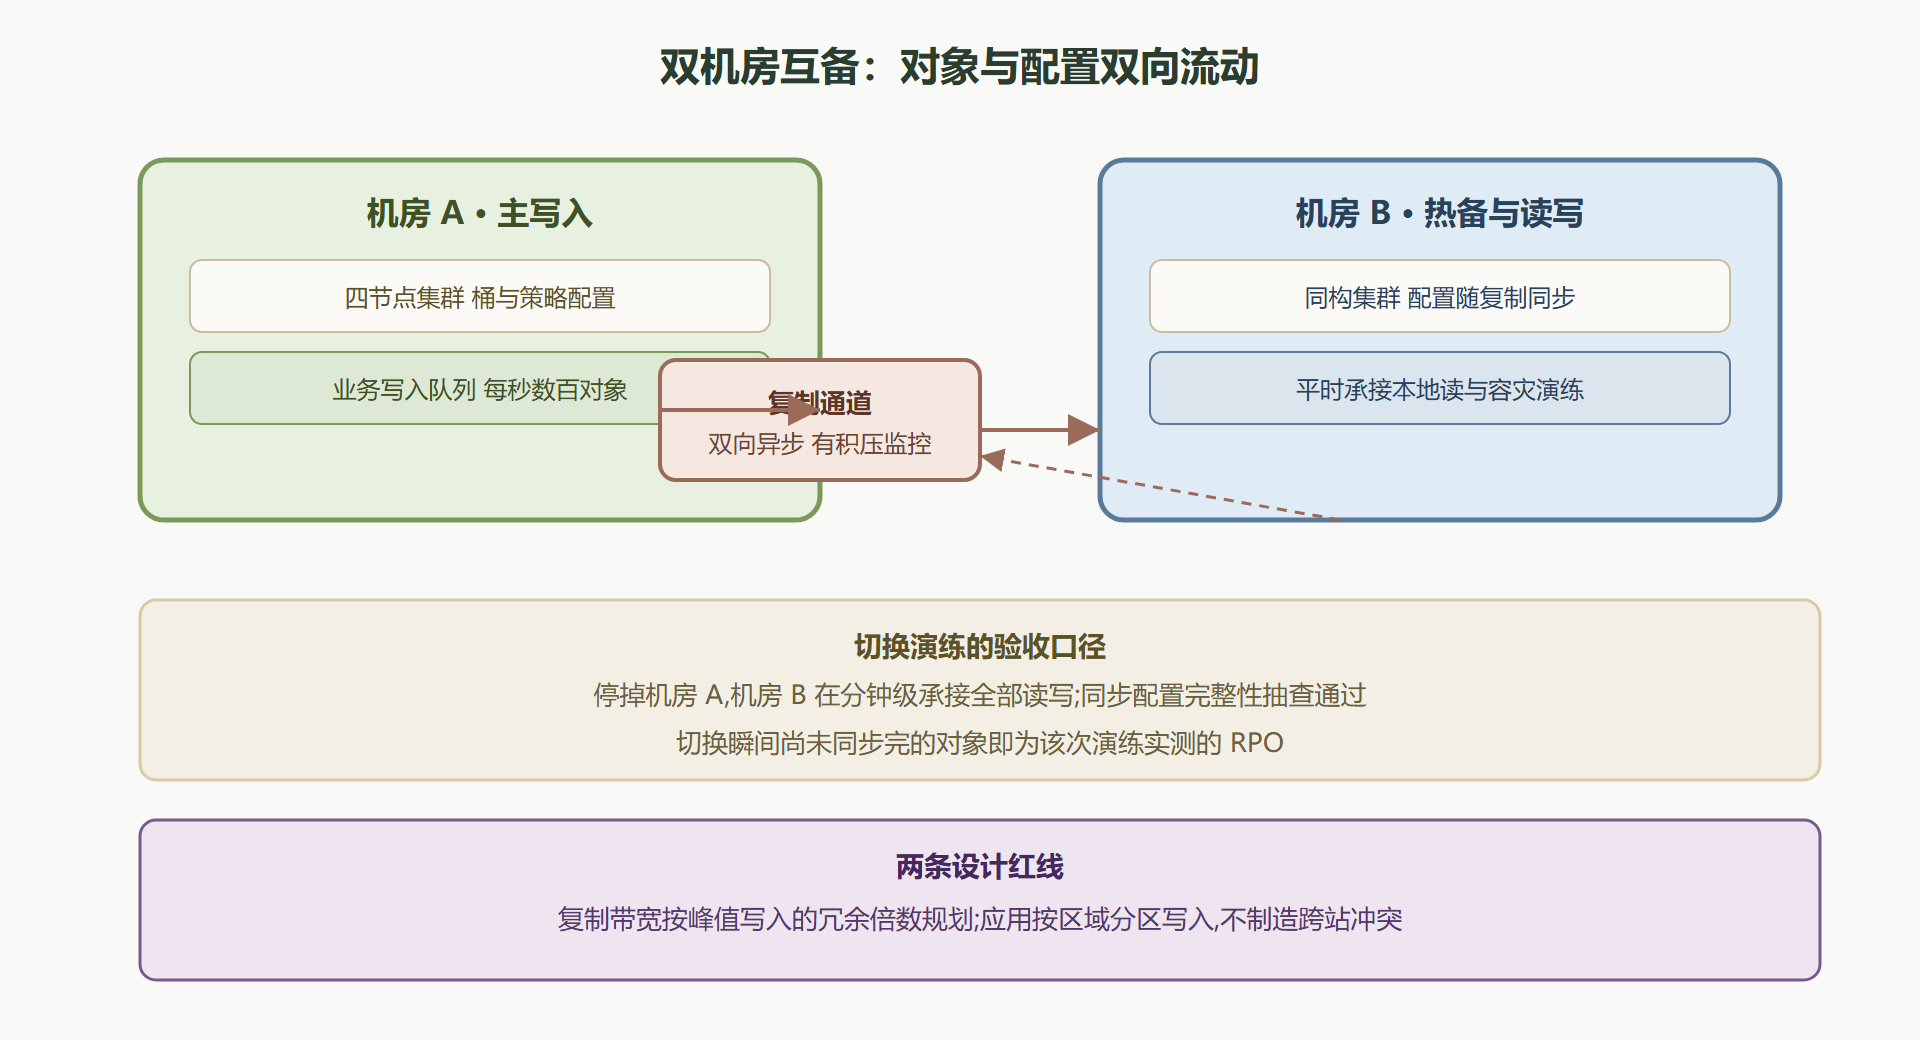
推论一:RPO 由积压决定。 容灾术语里 RPO(可容忍的数据丢失窗口)在这里等于"故障瞬间尚未同步完的量"。评估方案时要用真实写入速率算带宽账:峰值每秒写入 500 MB,复制带宽只给 200 MB,积压只会越滚越大——复制带宽要按峰值写入速率的冗余倍数规划,而不是按平均值。
推论二:冲突由规则裁决,不由人工裁决。 两个站点几乎同时写同一个键时,复制机制按确定性规则(保留时间上更近的写入)收敛,不提供人工合并。应用若依赖"跨站点同时改同一对象",设计上就已经错了;正确姿势是按业务维度分区(区域 A 的写走站点 A),让冲突根本不发生。
图 5-4 双机房站点复制的同步与积压
案例一次同城双机房的搭建与演练
背景:支付公司的审计归档桶(5.3 的锁定桶)要求异地容灾。选定同城两个机房,专线带宽 10 Gb。
操作:两套同规格四节点集群分别部署,按第 2 章验收后执行站点复制绑定;复制生效后先做基线全量校验(对象数与抽样指纹比对),再纳入季度演练:随机选一个月的日志对象,在 B 站点做"读取、校验、模拟 A 站宕机下的写入"三项测试。
结果:绑定后积压稳定在秒级;季度演练里 A 站整机断电,B 站在两分钟内承接全部读写,实测 RPO 为 11 秒的写入量,全部在恢复后自动补同步。
解读:这套方案里"演练"不是仪式——实测 RPO 这个数字只有断真电才能量出来。纸面推演给出的"同步是异步的"没有温度,11 秒这个数字才让合规部门签字。
变式:三站点互备适合"两地一云"的进阶形态:两个自建机房加一个公有云上的 MinIO 集群,云站点同时充当第三方见证与归档层。但注意复制流量按三倍计,带宽规划要重算。
本节要点回顾
- 站点复制是逻辑整体:对象、桶配置、IAM 双向同步,任一站点可独立承接全部业务。
- 异步是物理事实:RPO 等于积压,带宽按峰值写入的冗余倍数规划。
- 冲突靠分区避免:按业务维度分区写入,不给裁决规则出难题。
- 演练量出真数字:RPO 要实测,断电演练是容灾方案唯一的验收方式。
岁月与远方都安顿了。第 6 章回到最日常也最凶险的战场:身份、权限与事故排错。
带宽与积压的粗算示范
5.4 的两条红线,用一笔示范账算出体感。设主站峰值写入速率为每秒 300 MB:复制通道按峰值的两倍冗余规划,即每秒 600 MB 的同步能力,折算跨机房专线约 5 Gbps(再给协议开销留一成)。日常平均写入若为每秒 80 MB,通道大部分时间空闲,积压近乎为零;业务高峰时同步吃满通道,稳态积压 = 峰值持续时长乘以峰值与同步能力之差。若峰值可持续两小时且通道只有每秒 400 MB,积压将逼近 1.4 TB——按每秒 600 MB 的追赶速率,高峰结束后还要再追近四十分钟。这笔账解释了为什么通道要按峰值冗余规划:积压不是线性可逆的,追平时间比积压本身更伤承诺。
站点复制的两个边界疑问
加入复制组后,存量数据会互相同步吗?
会。复制组建立后,各站点的存量对象与配置按对等语义互相补齐,不需要先做一次全量镜像再开启复制。但补齐期间的带宽消耗要纳入变更窗口规划——TB 级存量的首轮同步就是一次变相的迁移,按 4.3 的口径选窗口、盯进度。
站点复制与桶级复制能同时用吗?
同一批桶上不能,语义会打架。桶级复制适合"只挑个别桶做单向归档"的窄场景;一旦决定全站互备,就把桶级规则清干净,避免两套复制语义在同一份数据上互相覆盖。原则与 4 章一致:一个数据集合,一条同步路径,避免叠加出没人能推理的行为。
复制健康的三个观察点
把站点复制纳入日常监控(8.2 的清单)后,有三个观察点值得固化为面板指标。其一,复制队列深度:待同步的事件条数,常态应接近零,持续增长即积压预警。其二,最近同步延迟:最新对象从主站写入到备站可见的时间差,它就是 RPO 的实时读数,比任何承诺都诚实。其三,同步错误计数:网络抖动、目标端瞬断都会产生重试,偶发无害,连续增长则说明通道或对端出了问题。三点合一,站点的同步状态就从"配置上已开启"变成"运行中可观测"。
多站点的拓扑疑问:两站还是三站?
两站点互备覆盖了绝大多数企业的需求。三站点的价值在于第三站充当"见证与隔离层"——它的存在让"两站同时出问题"和"复制组仲裁"的场景有了着落,代价是同步流量翻倍、运维复杂度上台阶。判断标准还是约束清单:合规是否要求第三方异地副本?预算是否覆盖三倍带宽?团队是否维护过三节点复制组?三问有两问为否,就从两站开始,把三站留给未来。