7.1 硬件选型:CPU、盘与网络的配比
7.1 硬件选型:CPU、盘与网络的配比
本节摘要:对象存储的性能上限在硬件采购那一刻就大致锁定了。本节按"业务画像决定配比"的思路,给出 CPU、内存、盘、网络四个部件的选型要点与配比经验,并解释每条建议背后的瓶颈换算。
标书评审会上的两个配置
场景代入:两份服务器配置摆在评审会上。配置甲:双路 32 核、1T 内存、十二块 16T HDD,阵列卡默认 RAID 5。配置乙:双路 24 核、256G 内存、八块 4T NVMe,HBA 直通。两份配置价格相近,哪份是对的?答案是"看业务画像"——归档桶选甲的思路(去掉 RAID 5),机器学习数据集选乙。硬件选型的第一步从来不是看参数,是回答"这个集群为什么而存在"。
CPU:核数与指令集两条线
MinIO 是 Go 编写的无阻塞并发模型,核数直接决定并发处理能力,经验配比是每块活跃盘配两个物理核起跳。十二盘节点至少 24 核,32 核以上才从容。
指令集是另一条容易被忽视的线:纠删码编解码重度依赖 SIMD 向量指令,AVX2 是底线,AVX-512 在重校验配比(如 8+8)下有可测的编解码增益。选型时确认 CPU 支持并开启这些指令集(BIOS 里被关闭的案例真实存在),比多买两个核更划算。此外,TLS 握手、哈希校验(HighwayHash)同样吃向量指令的红利——3.2 的校验开销之所以小,前提就是指令集在位。
内存:按盘位与并发预算
内存的三个去向:Go 运行时的对象管理、网络缓冲、以及操作系统为盘做的页缓存。经验配比每 TB 管理容量配 1 到 2 GB 内存是常见起点(管理容量指纠删码后的可用容量),小对象高并发场景要上调。页缓存对读性能贡献显著——但这恰恰是 7.3 要警惕的压测伪影来源之一。
盘:介质、接口与那条直通铁律
盘是性能画像的分水岭,三类典型选择:
| 介质 | 适合画像 | 单盘带宽量级 | 单盘 IOPS 量级 |
|---|---|---|---|
| 大容量 HDD(16T 级) | 归档、备份、视频库 | 约 200 MB 级 | 百级 |
| SATA/NVMe 混布 | 通用业务桶 | 数百 MB 级 | 万级 |
| NVMe SSD | AI 数据集、高频热点 | GB 级 | 十万级以上 |
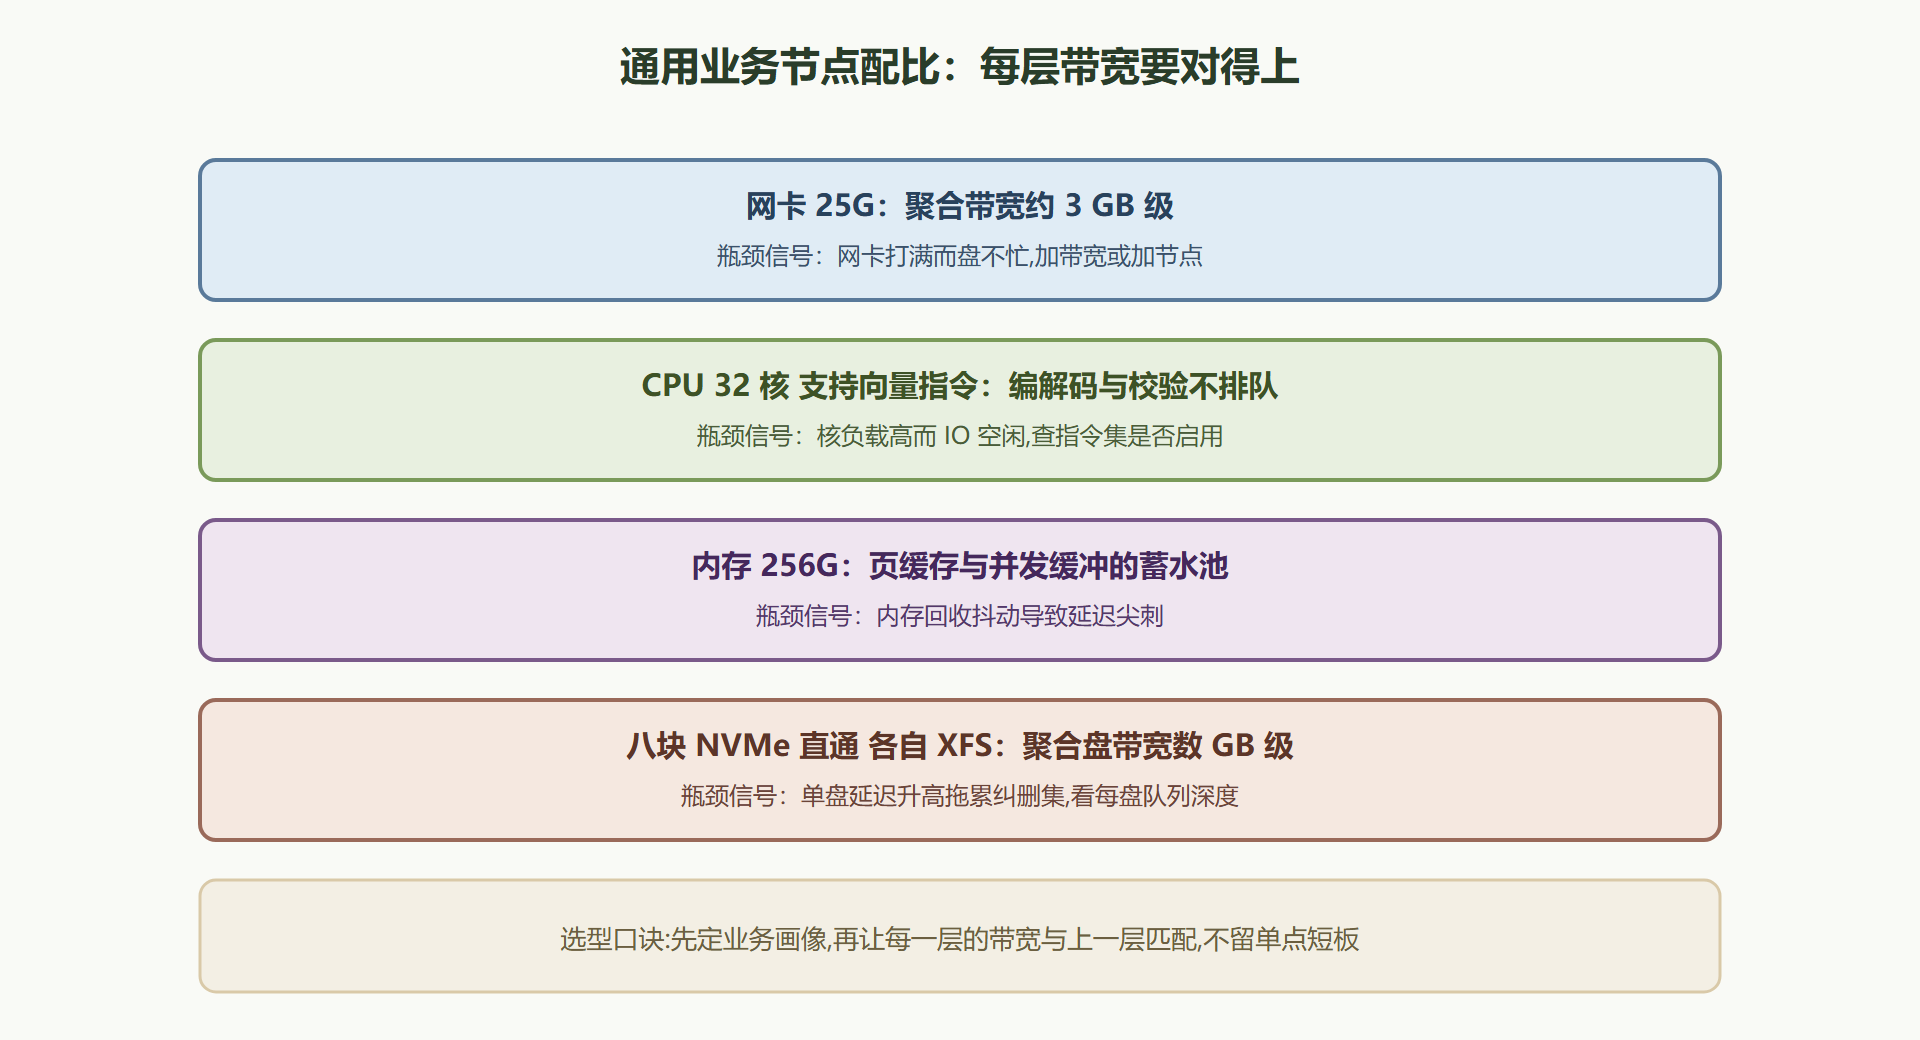
配比口径是网络带宽要与盘位带宽匹配:一个节点八块 NVMe 的聚合带宽是几个 GB 级,配一张 25G 网卡(约 3 GB 级)才不浪费;反过来,十六块 HDD 的聚合带宽两三个 GB,万兆网卡(约 1.2 GB 级)已够。
直通铁律在 4.2 讲过原理,这里补上性能视角的账:RAID 层的写惩罚(尤其校验型阵列)与缓存策略会和 MinIO 的纠删码写路径互相干扰,阵列重建窗口的性能塌方没有对象级 heal 的对应物。采购时把"HBA 模式"写进标书的硬性条款——7.3 主线案例里那两台接错 RAID 模式的机器,就是标书没写条款的代价。
图 7-1 一个通用业务节点的配比与瓶颈位
配置甲的改法与配置乙的归宿
回到开头那两份配置。甲的正确改法:阵列卡切 HBA 直通,十二块 HDD 各自成盘,按归档画像选高冗余配比(如 8+8),网络万兆足矣——它成了一台合格的归档节点。乙则是标准的性能节点:NVMe 加 25G,适合作为机器学习数据集与热点业务的池。评审会的结论是把两份配置都要了,按画像分别建池——同一个集群里,Server Pools 模型(4.1)恰好支持这种异构共存,只是各池内部规格保持一致。
本节要点回顾
- 画像先行:归档、通用、性能三种画像对应三套配比,参数表是画像的翻译而非起点。
- CPU 两条线:每盘两核的并发底盘,加 SIMD 指令集的编解码红利。
- 带宽要逐层匹配:网卡、盘位聚合带宽互相看得齐,单层短板就是全链路短板。
- 直通写进标书:RAID 模式的机器上不了 MinIO 的考场,条款比经验可靠。
硬件到位只是第一关,操作系统的出厂默认值还压着性能。下一节把该动的参数逐个动起来。
两套参考配置单
把画像论落成可以发给采购的两张配置单。数字是经验起点,不是圣旨,按预算与画像微调:
| 部件 | 归档节点 | 性能节点 |
|---|---|---|
| CPU | 24 至 32 核,确认向量指令 | 32 至 48 核,高主频 |
| 内存 | 128 GB | 256 GB 起 |
| 盘 | 12 块 16T 至 20T HDD,直通 | 8 块 4T NVMe,直通 |
| 网卡 | 万兆双口 bonded | 25G 或 100G |
| 纠删配比 | 8+8 高冗余 | 10+6 或 12+4 |
| 预期画像 | 吞吐 GB 级、容量优先 | 吞吐数 GB 级、延迟敏感 |
配置单之外,给一笔换算示范帮读者建立"带宽账"的手感:十二块 HDD 的聚合顺序带宽约 2.4 GB 级,万兆网卡只能供给 1.2 GB 级——网卡是瓶颈,加盘无用,要么上 25G 要么接受归档定位;八块 NVMe 聚合可达 20 GB 级,单张 25G(约 3 GB 级)反而成为瓶颈,性能节点的盘位要与网卡档次成套规划。瓶颈永远存在,选型的本质是决定让瓶颈落在哪一层,以及那一层是不是你最愿意花钱的地方。
采购环节的两个防坑提醒
防坑一:把"HBA 直通模式"与"禁用阵列卡写缓存"写进标书验收条款,到货即验——7 章主线案例里 RAID 模式接错的机器,就是没有条款的代价。防坑二:盘的批次要分散下单、分散入列,同批次盘同进同退,老化周期也会同频共振——把"批次分散"写进供货要求,比事后运维补救便宜得多。
画像到参数的翻译练习
为了把"画像先行"变成肌肉记忆,做一次完整的翻译示范。假设业务方这样描述需求:"我们是一个短视频分发平台,每天上新几千条视频,用户高峰集中在晚间,加载必须快。"翻译成硬件语言分四步。第一步拆负载:上传集中在白天(上传窗口分散),读取集中在晚间(读取并发高),典型对象大小 100 MB 到 500 MB。第二步算容量:日增量按平均 200 MB 乘上新视频数再乘冗余系数,得出年增量,叠加三年的外推与 EC 配比折损,得到裸容量需求。第三步定介质:大文件、顺序读为主,HDD 即可胜任读取带宽,但晚间高峰的并发拉流需要聚合带宽——按"并发用户数乘以码率"算出峰值读带宽,倒推节点数与网卡档次。第四步定冗余:内容可由源站重建,配比可以激进到 10+4,把容量预算让给带宽。
四步走完,采购单自己浮出水面:若干个"大 HDD 加万兆"的读优化池,外加一个小 NVMe 池承接上传落盘与热点缓存。这个练习的价值在于展示方法而非结论——换一个业务,四步重走一遍,答案完全不同,但推理路径完全相同。硬件选型的功力,就是把模糊的业务描述磨成清晰参数表的能力。