2.1 顶点处理:从模型空间到裁剪空间
2.1 顶点处理:从模型空间到裁剪空间
本节摘要:顶点处理是管线的第一站,也是第一个可编程阶段。顶点着色器对每个顶点并行执行,核心职责是把模型空间坐标经过模型、观察、投影三次矩阵变换送入裁剪空间,并顺路传递和衍生各种顶点属性。本节完整解剖这条变换链,手算一个真实顶点的旅程,解释透视除法为什么放在着色器之后,并给出「非均匀缩放导致光照错乱」这一经典病变的病理。这是第 4 章变换数学的前哨站。
把一个顶点放上解剖盘
先明确这一站的输入输出。输入:一串顶点流,每个顶点带着若干属性——位置、法线、纹理坐标,以及你自己定义的任意数据。输出:裁剪空间坐标(4 分量,含 w)加一组插值用的输出属性。中间干活的,是你写的顶点着色器——注意它「对每个顶点各自独立执行」,成千上万个顶点的变换同时在 GPU 的并行单元里发生,着色器代码里看不到循环,循环在外面。
这里有个初学者最常见的误解要立刻纠正:顶点着色器看不到三角形。它眼里的世界只有一个个孤立的顶点,知道「这个顶点在哪、带什么属性」,不知道「这个顶点和哪两个顶点连成三角形」。三角形的概念要到下一站图元装配才诞生。这个认知很重要——凡是「需要知道邻居」的算法(比如按面法线平滑顶点法线),都不能在顶点着色器里做。
变换链:顶点的五段旅程
顶点位置要穿过一连串坐标系,每一段都对应一次矩阵乘法。先看全景图,再手算一遍。
图 2-1 顶点坐标的变换链:五段旅程与三个换乘车
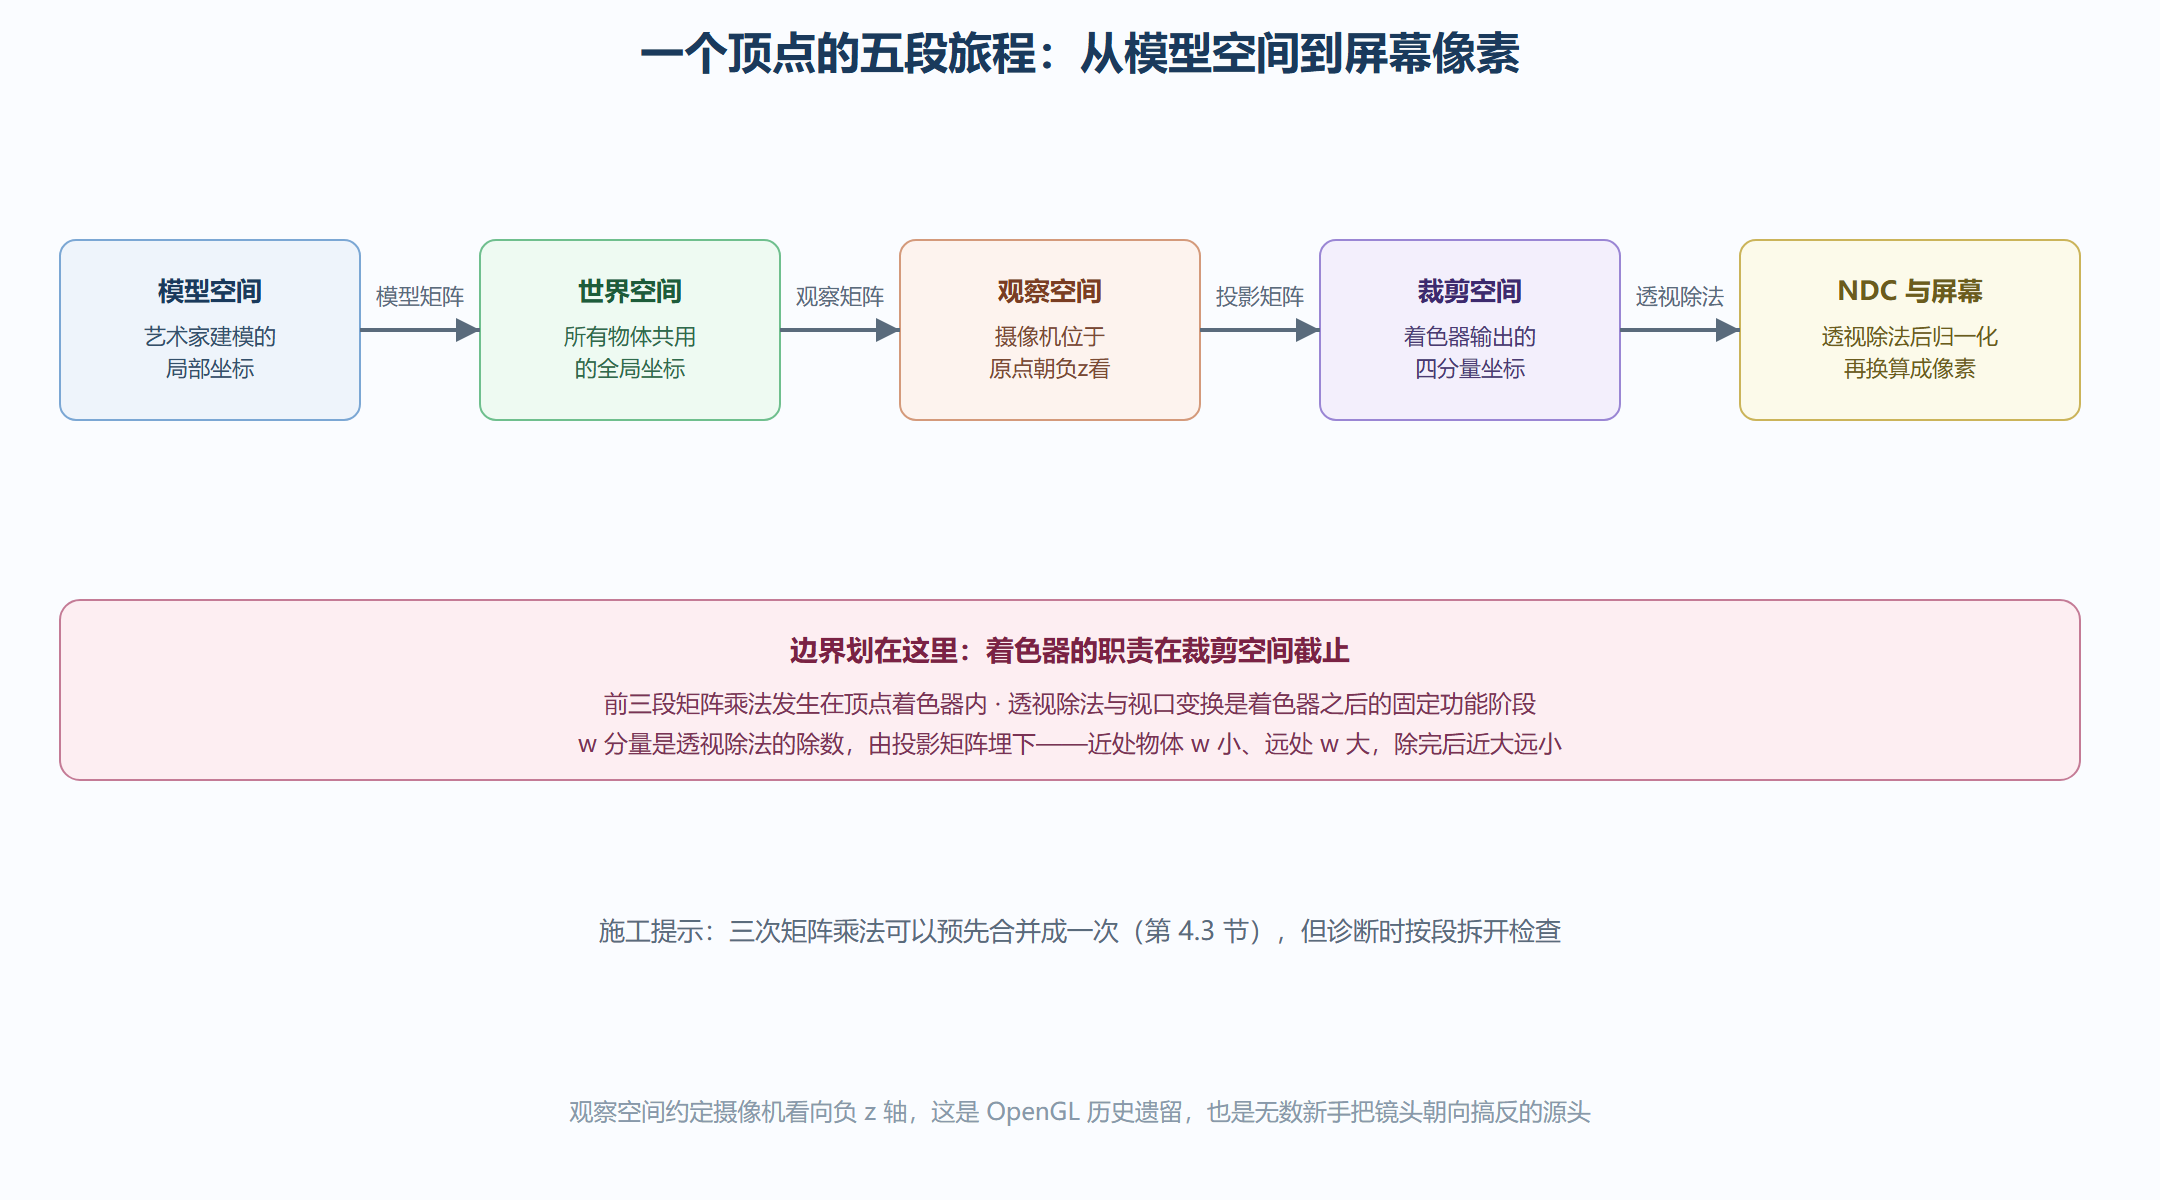
每段旅程的要点:模型矩阵把「物体自己的坐标」翻译到「世界坐标」(物体的摆放位置与姿态);观察矩阵把世界翻译成「以摄像机为原点」的视角(摄像机后退等效于物体前移);投影矩阵把观察空间的可视区域——一个视锥体——压成裁剪空间的标准范围。这三步在顶点着色器里完成,通常合并写成一个矩阵与位置的乘法。
手算一遍:透视除法在除什么
抽象链条不如亲手算一次。取一个顶点,模型空间坐标 (0, 0, -5)(在摄像机前方 5 个单位,模型恰好放在世界原点,于是模型矩阵是单位矩阵可以忽略)。假设观察矩阵也不动它,投影矩阵按视场角 45 度、屏幕宽高比 1、近平面 0.1、远平面 100 构造。手算结果是裁剪空间坐标约为 (0, 0, -5.05, 5.0)——注意第四个分量 w 变成了 5.0。
透视除法随即把 x、y、z 都除以 w:得到 (0, 0, -1.01, 1)。这就是 NDC(标准化设备坐标)。再经过视口变换,x、y 映射到屏幕像素坐标,z 映射到深度缓冲的取值范围,一个顶点就落到了屏幕上。
这个手算揭示了两件事。其一,w 不是摆设:透视投影矩阵特意构造出「w 等于观察空间深度的负值」的效果,除以 w 之后,同样大小的物体离得越远、除数越大、投影后越小——「近大远小」的全部魔法就藏在这一次除法里。其二,透视除法不能在顶点着色器里做:因为裁剪需要发生在除法之前。裁剪空间的价值在于「x、y、z 都落在一个以 w 为尺度的范围内」这个判断很容易执行(负 w 到正 w 之间),除完之后再裁剪反而要处理除以零等麻烦。这就是为什么着色器只输出到裁剪空间为止。
属性传递与一次经典病变
顶点着色器不只算位置。法线、纹理坐标、颜色都要从它手里过,而其中法线有个著名的陷阱。法线用于光照计算,需要从模型空间变换到世界空间——直觉上用模型矩阵即可。但只要模型带非均匀缩放(比如把正方体压扁成砖块),模型矩阵会破坏法线与表面的垂直关系,直接用它变换法线,光照立刻错乱:明明朝上的面看起来一半亮一半暗。
病理:非均匀缩放矩阵作用于「垂直于表面的向量」时不再保持垂直。药方:用模型矩阵的逆转置矩阵变换法线。GLM 里就是 glm::transpose(glm::inverse(model)),一次预计算,随 uniform 上传。这个坑发病率极高,因为症状(光照不均匀)很难第一时间联想到变换环节——记住这条病理报告:光照错乱先查法线矩阵。
// 顶点着色器骨架:位置走完整变换链,法线走逆转置链 #version 330 core layout (location = 0) in vec3 aPos; // 位置属性 layout (location = 1) in vec3 aNormal; // 法线属性 uniform mat4 model; uniform mat4 view; uniform mat4 projection; uniform mat3 normalMatrix; // 模型矩阵的逆转置,CPU 端预计算好 out vec3 FragPos; // 传给片元着色器插值 out vec3 Normal; void main() { FragPos = vec3(model * vec4(aPos, 1.0)); // 世界空间位置,供光照用 Normal = normalMatrix * aNormal; // 法线走逆转置,绕开缩放陷阱 gl_Position = projection * view * vec4(FragPos, 1.0); // 输出裁剪空间 }
代码里三个值得驻足的点:normalMatrix 用 mat3 是因为法线是方向不需要平移分量;FragPos 和 Normal 声明为 out,在下一站会被插值后交给片元着色器(插值机制在 2.3 节解剖);gl_Position 是顶点着色器的法定输出,就是裁剪空间坐标本身。
顶点着色器的其余器官
变换之外,这一站还常承担三类工作。其一,动画:骨骼蒙皮的顶点混合——传入骨骼矩阵数组,按权重把顶点挂到多根骨骼上,每帧在着色器里算变形,避免 CPU 逐顶点重算再上传。其二,程序化位移:波浪水面、摆动草丛,用时间 uniform 加噪声函数直接扰动顶点位置,几何细节零存储成本。其三,细分与几何着色器——可选的后续阶段,把面片细分成更密三角形或按图元重构几何。这三类扩展能力第 4、6 章会各取所需展开,此处先立个路标。
性能上这一站很少成为瓶颈:现代 GPU 的顶点吞吐以每秒十亿计。真正的风险是喂得不对——顶点属性格式选错(比如用全精度浮点存可以半精度存的数据)会拖累带宽,海量重复顶点不做索引复用会浪费计算。这些属于第 3 章缓冲对象和第 6 章带宽优化的管辖范围。
本节要点回顾
- 顶点着色器是逐顶点并行的:看不到三角形,凡需要邻居信息的算法进不来
- 五段旅程三个换乘:模型/观察/投影三矩阵在着色器内,透视除法与视口变换在着色器外
- w 分量承载透视:近大远小来自除以 w;裁剪必须在除法之前,所以着色器止步裁剪空间
- 法线走逆转置:非均匀缩放会让法线病变,光照错乱先查 normalMatrix
- 顶点站还能做动画与位移:蒙皮、程序化形变是它的常见副业
下一站,孤立的顶点将被组装成三角形,再被切成片元网格——图元装配与光栅化,管线里最像「流水线」的一段。