3.1 缓冲对象:VBO、VAO与EBO
3.1 缓冲对象:VBO、VAO与EBO
本节摘要:缓冲对象是 GPU 侧的字节数组,是几何数据进入管线的唯一现代通道。本节解剖 VBO(顶点属性数据)、EBO(索引复用)、VAO(顶点布局的打包记录)三者的分工与关系,给出交错布局的完整配置代码,算清索引复用的经济账,并延伸到 UBO 与 SSBO 这两个着色器侧的进阶容器。绑定三段式是本节的手术刀。
先把三个缩写摆上解剖盘
初学者最容易被这三个「O」打晕,因为旧教程经常把它们混着讲。分工其实一句话能说清:VBO 存数据,EBO 存索引,VAO 存「怎么取数据」的说明书。
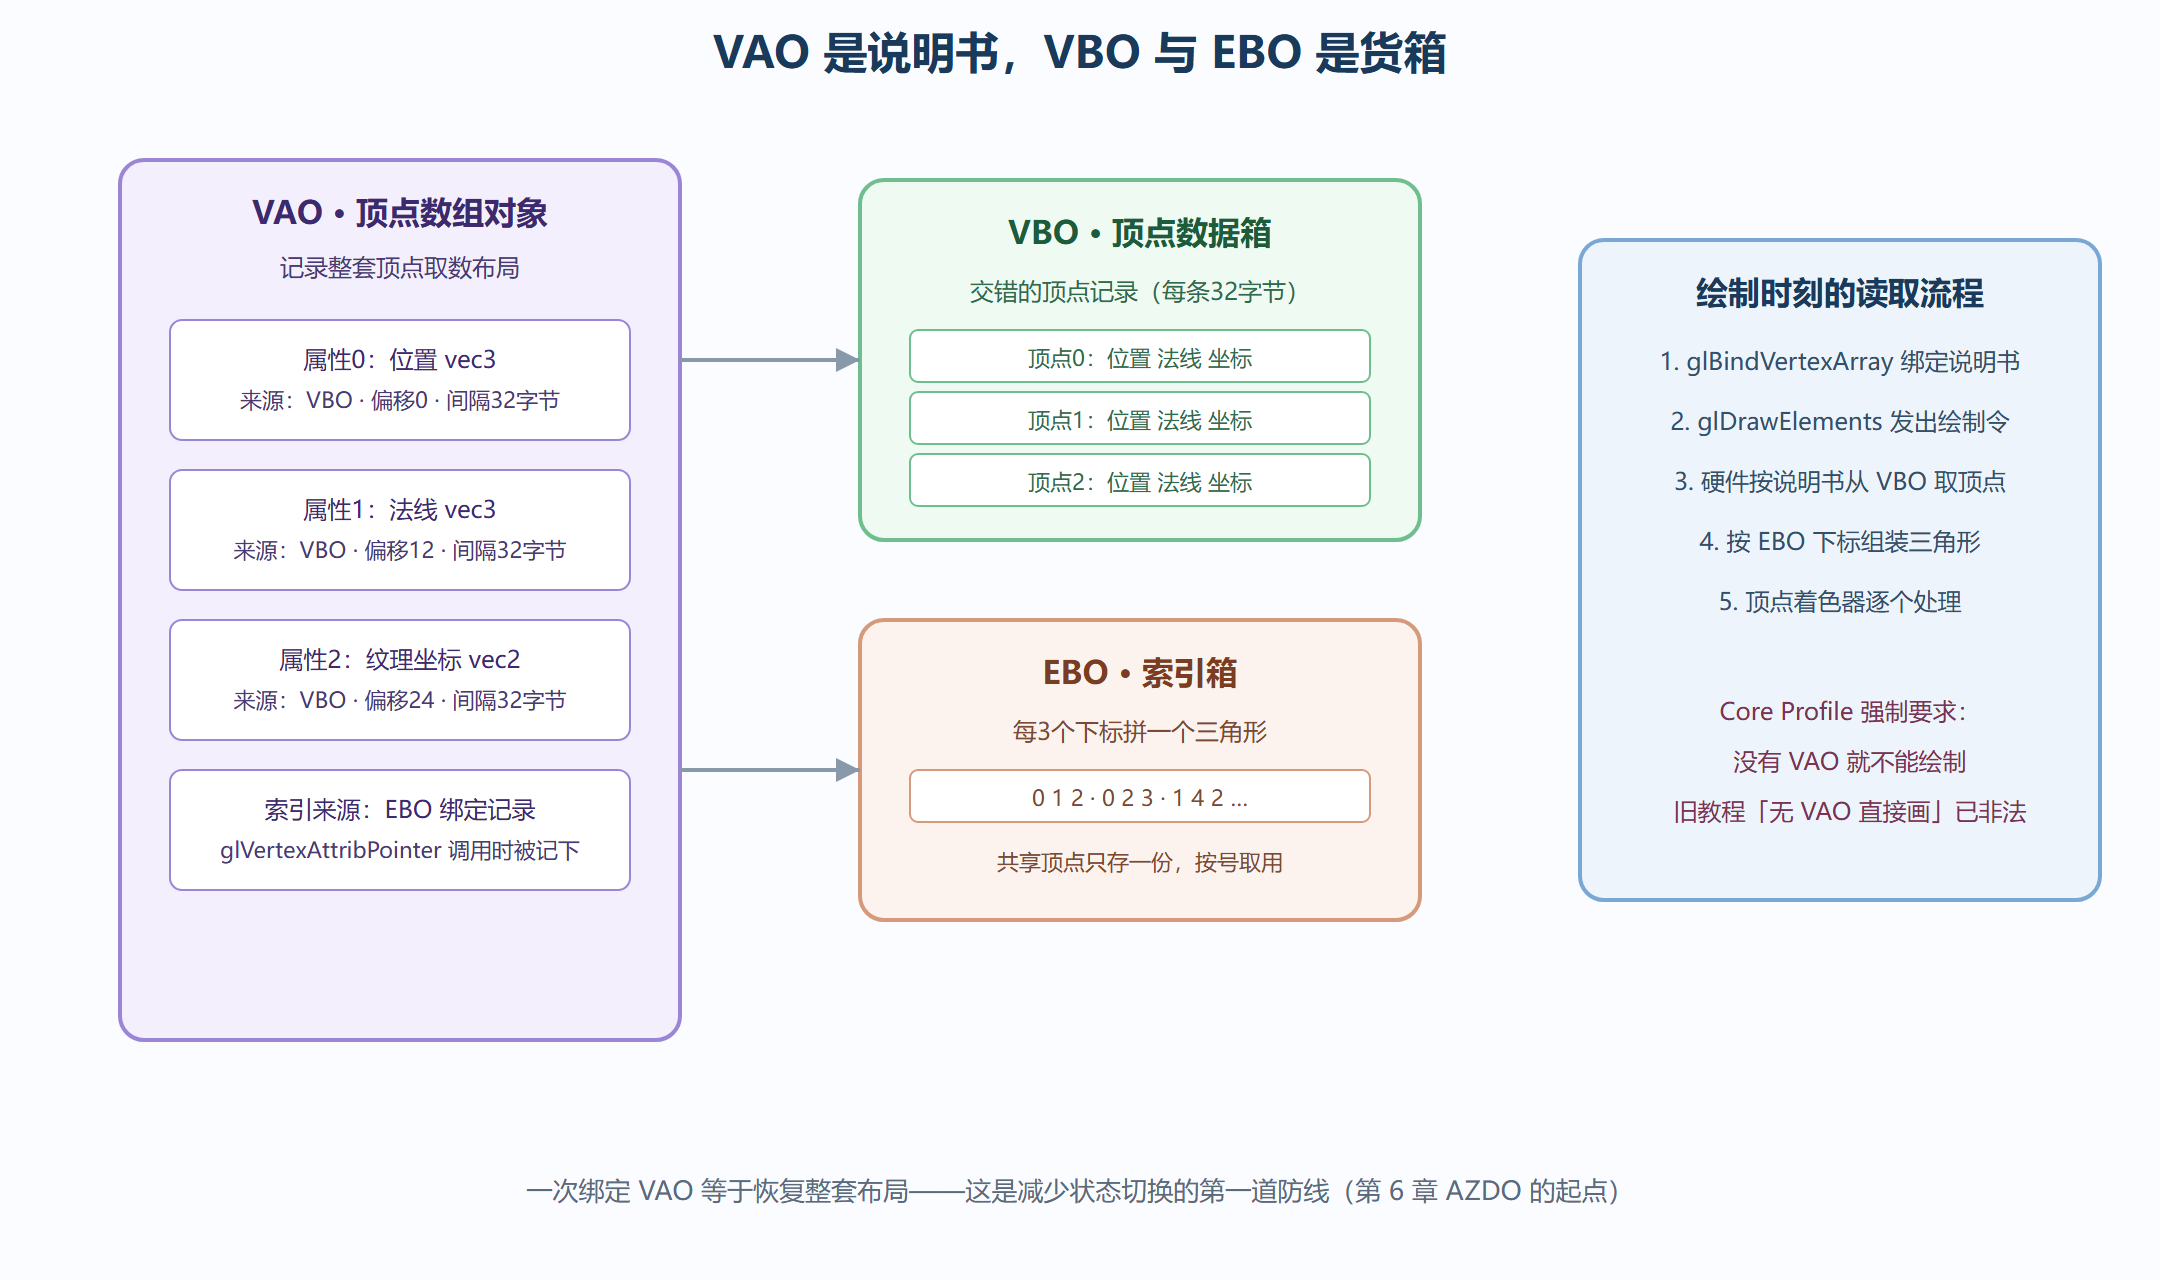
VBO(顶点缓冲对象)就是一块显存里的字节数组,内容是你上传的顶点数据。它自己不知道这些字节是位置还是颜色——字节就是字节。EBO(索引缓冲对象,也叫 IBO)也是字节数组,内容是一串下标,告诉管线「第几个三角形用第 8、3、11 号顶点」——让共享顶点只存一份。VAO(顶点数组对象)不存几何数据,它存的是配置:哪个属性从哪个 VBO 的哪个偏移读、间隔多少、什么格式——把一整套顶点布局记录打包成一个对象,之后每次绘制只要绑定这一个 VAO,布局全部自动就位。
图 3-1 VAO、VBO、EBO 的解剖关系:说明书与货箱
交错布局:完整配置过程
假设每个顶点存位置(3 浮点)、法线(3 浮点)、纹理坐标(2 浮点),共 8 个浮点 32 字节交错排列。完整配置代码:
float vertices[] = { /* 位置xyz 法线xyz 坐标uv 交错,每顶点32字节 */ }; unsigned int indices[] = { 0,1,2, 0,2,3 /* 两个三角形拼一个四边形 */ }; GLuint vao, vbo, ebo; glGenVertexArrays(1, &vao); glGenBuffers(1, &vbo); glGenBuffers(1, &ebo); glBindVertexArray(vao); // 解剖开始:以下配置全部记入此 VAO glBindBuffer(GL_ARRAY_BUFFER, vbo); glBufferData(GL_ARRAY_BUFFER, sizeof(vertices), vertices, GL_STATIC_DRAW); glBindBuffer(GL_ELEMENT_ARRAY_BUFFER, ebo); // 注意:EBO 绑定也被记进 VAO glBufferData(GL_ELEMENT_ARRAY_BUFFER, sizeof(indices), indices, GL_STATIC_DRAW); // 属性0:位置。间隔32,偏移0 glVertexAttribPointer(0, 3, GL_FLOAT, GL_FALSE, 32, (void*)0); glEnableVertexAttribArray(0); // 属性1:法线。间隔32,偏移12 glVertexAttribPointer(1, 3, GL_FLOAT, GL_FALSE, 32, (void*)12); glEnableVertexAttribArray(1); // 属性2:纹理坐标。间隔32,偏移24 glVertexAttribPointer(2, 2, GL_FLOAT, GL_FALSE, 32, (void*)24); glEnableVertexAttribArray(2); glBindVertexArray(0); // 解剖结束,封存说明书
三个细节决定这段代码的理解深度。第一,glVertexAttribPointer 的「间隔」参数是到下一个顶点同属性的字节数,「偏移」是本属性在顶点记录内的起点——交错布局因此得名:一个顶点的所有属性挤在一起,对 GPU 缓存友好(取一个顶点顺带全拿到)。第二,EBO 的绑定被记录进 VAO 是个著名的历史陷阱:解绑 VAO 之前先解绑了 EBO,等于把 VAO 里的索引记录抹掉,下次绑定 VAO 绘制直接报错——解绑顺序:先 VAO 后 EBO。第三,usage 参数(STATIC/DYNAMIC/STREAM)是你对驱动的「使用模式承诺」,静态几何一次上传终身使用,逐帧重写的动态数据另有去处(第 6 章的缓冲流式更新与持久映射)。
绘制时的另一头,顶点着色器里 layout(location = 0) 的编号必须与这里的属性编号对应——数据端的「货位号」和着色器端的「门牌号」由你保证一致,对不上就是属性错乱式黑屏(位置拿成颜色之类的诡异画面)。
索引复用的经济账
索引绘制为什么值得多一个对象?算立方体的账:6 个面 × 每面 2 三角形 × 每三角形 3 顶点 = 36 个顶点记录;但立方体只有 8 个角点。不用索引,28 条记录是纯冗余——顶点着色器为同一个角点白算 4 遍,显存白存 3 份。用 EBO,存 8 个顶点加 36 个下标(下标比顶点便宜得多,可用 16 位整数),顶点着色器算 8 次。角色网格上这个比例更夸张:共享顶点普遍占九成以上,索引复用是「零画质损失的减法优化」。
配套的还有图元重启(索引里插一个特殊重启值,一条索引流画多段不相连的条带)和多实例绘制(一次绘制令画 N 份带逐实例属性偏移的拷贝,第 6 章主角)。它们共同的方向:让一次绘制调用覆盖更多几何,把调用次数压下来。
进阶容器:UBO 与 SSBO
两个后辈容器值得立此存照。UBO(统一缓冲对象)把一组 uniform 打包成显存块,多个着色器程序可以共享同一块——摄像机矩阵这类全场景 uniform 从「每个程序传一遍」变成「写一次全局共享」,换来的是驱动校验和上传的大幅缩减。SSBO(着色器存储缓冲)则是可读写的通用大容器,容量上限远高于 uniform 块,让计算着色器和片元着色器能像访问数组一样存取大块数据——GPU 粒子系统、剔除算法(第 6 章)都建在它上面。两者的 YAML 式总结:UBO 是「共享只读小仓库」,SSBO 是「可读写大仓库」,按数据的方向与体量选型。
💡 关键直觉:缓冲对象家族的演化方向始终如一——减少 CPU 与 GPU 的握手次数。VBO 消灭逐顶点上传,EBO 消灭重复顶点,VAO 消灭逐属性配置,UBO 消灭重复 uniform,第 6 章的间接绘制将消灭逐次绘制调用。握一次手的钱够传一大块数据。
本节要点回顾
- VBO 存数据、EBO 存索引、VAO 存取数说明书:三者分工一句话,缺 VAO 不能画
- 交错布局缓存友好:间隔与偏移的语义要能默写,着色器 location 与属性编号对齐
- 解绑顺序:先 VAO 后 EBO:EBO 绑定记在 VAO 里,顺序反了索引记录被抹
- 索引复用是免费优化:立方体 36 变 8 只是最小案例,角色网格省九成
- UBO 共享只读、SSBO 可读写大块:按方向与体量选型,都是为减少握手
几何数据的通道打通了。下一节解剖管线的另一路补给——纹理:像素数据的多维容器,以及「取一个像素」背后远比想象复杂的采样规则。