6.3 计算着色器:图形之外的GPU
6.3 计算着色器:图形之外的GPU
本节摘要:计算着色器(OpenGL 4.3+)脱离图形管线的阶段结构,以工作组为调度单位直接指挥 GPU 的通用并行。本节解剖工作组/局部工作组/全局调度三层模型与共享内存加栅栏的协作机制,走完一个图像处理案例(亮度直方图),再讲粒子模拟与 GPU 剔除两个图形邻域应用,说清它与普通着色器的三大差异与读取结果的正确姿势。它把 GPU 从「画图芯片」升级成「可编程的并行机房」。
图形管线的「不自由」
图形管线的每个阶段为「画三角形」特化:输入是顶点流、输出是片元、执行顺序被光栅化决定。想用 GPU 做点别的——比如对一张图像统计直方图、模拟一百万粒子的运动、按包围盒剔除物体——硬塞进图形管线得靠「把数据画成点、用片元着色器算、渲到纹理存结果」这类扭曲路径(GPGPU 的史前时代确实这么干)。计算着色器的诞生就是把这层伪装拆掉:没有顶点没有片元没有光栅化,你声明「一共开多少个线程」,GPU 直接跑你的代码,读写权限对 SSBO 与图像纹理全面开放。
工作组:并行的组织架构
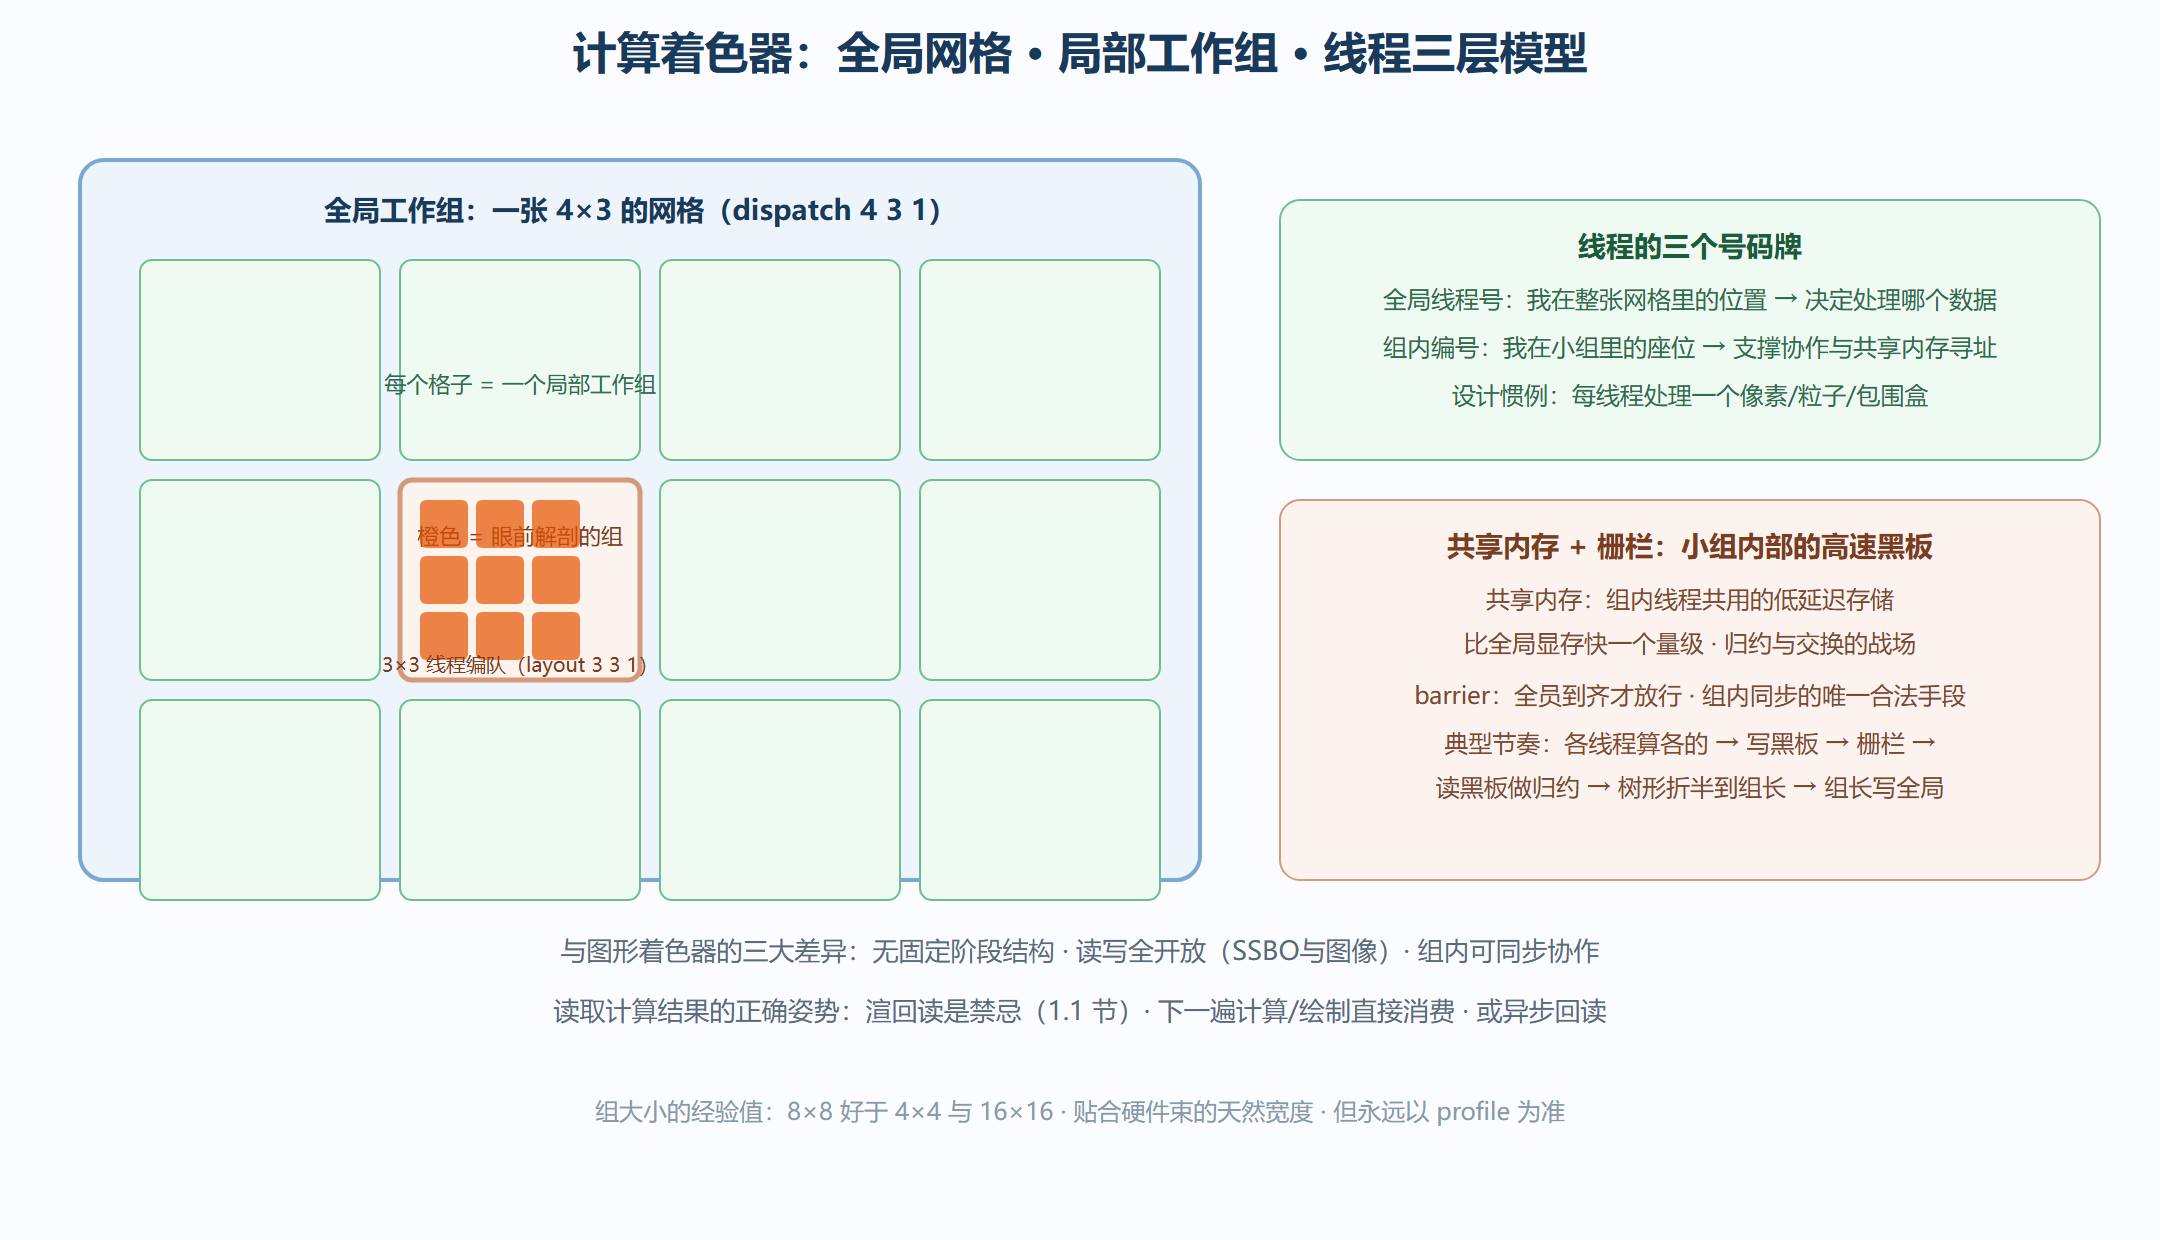
计算着色器的调度模型是三层嵌套。最外层是全局工作组——你启动的一个三维网格(dispatch 调用带三个维度参数);每个格子里是一个局部工作组——通常 8×8×1 或 16×16×1 的线程编队(着色器里 layout 声明),大小由你设计;最里层是单个线程——一次着色器调用。三层各有编号:全局线程号决定「我处理哪个数据」,局部组号与组内号配合支撑组内协作。
图 6-3 计算着色器的三层调度与协作
案例:直方图的完整解剖
统计一张图亮度分布(后处理自动曝光的必需品),图形管线做这件事极其别扭(片元着色器不能原子累加到全局计数)。计算着色器的解法分两步归约:先组内归约再全局累加。
#version 430 core layout (local_size_x = 16, local_size_y = 16) in; // 256 线程的小组 layout (binding = 0, rgba8) uniform readonly image2D src; // 输入图像 layout (binding = 1, std430) buffer Histogram { uint counts[256]; }; // 输出直方图 shared uint localCounts[256]; // 组内黑板 void main() { uint idx = gl_LocalInvocationIndex; // 组内座位号 if (idx < 256) localCounts[idx] = 0; // 组长之外的线程先擦黑板 barrier(); // 全员到齐 · 擦干净了 ivec2 pixel = ivec2(gl_GlobalInvocationID.xy); // 全局号 → 我负责的像素 if (pixel.x < imageSize(src).x && pixel.y < imageSize(src).y) { vec3 c = imageLoad(src, pixel).rgb; uint bucket = uint(dot(c, vec3(0.299, 0.587, 0.114)) * 255.0); atomicAdd(localCounts[bucket], 1u); // 组内原子累加(黑板级) } barrier(); // 全员写完 if (idx < 256) // 每桶派一个代表 atomicAdd(counts[idx], localCounts[idx]); // 组结果并入全局(一次/组/桶) }
三处设计值得咀嚼。两级归约:直接全局原子累加会有百万次原子竞争(256 个桶被百万像素抢),先黑板归约再全局合并,全局原子数骤降两个数量级——共享内存存在的意义就是这个。两个 barrier 的位置:擦黑板后一个(防止有人没擦完别人就开写)、写完后一个(防止有人没写完代表就汇总)——栅栏纪律是「写后必栅、读前确认」。边界判断:全局线程数按 16 的倍数铺开,图像尺寸不整除时越界线程必须判死——越界 imageLoad 是未定义行为的门票。这个案例的模式(分桶、组内归约、代表汇总)可以直接移植到粒子邻居查找、深度金字塔、遮挡剔除计数等一大族任务。
工作组大小的选择依据
组大小不是拍脑袋。约束来自硬件的「束」宽度(几十个线程锁步执行,2.3 节提过的并行单位):局部工作组最好是束宽的整数倍,8×8 = 64 恰好落在多数桌面 GPU 的 32 或 64 束宽的公倍数上,是通用安全值;太大(如 32×32)会让单组占满一个计算单元、组间并行度下降;太小(如 4×4)共享内存的摊薄优势发挥不出来。维度形状也有讲究:图像类任务用二维组匹配像素网格(缓存局部性好),归约类任务用一维组配合树形折半。经验起点是 8×8 或 16×16,最终以第 7 章的 profile 数据为准——不同 GPU 代际的最优值会漂移,写死一个「魔法值」不如留一个可调常量。
图形邻域的两个应用
粒子模拟:一百万粒子的位置速度存 SSBO,每帧一个计算 pass 做「读邻居力场 → 积分 → 写回位置」,渲染 pass 直接把同一 SSBO 当顶点数据间接绘制(6.1 节的闭环另一形态)——CPU 全程不碰粒子数据,模拟帧率与粒子数解耦。GPU 剔除:每个线程测一个物体的包围盒(4.3 节的视锥数学在计算着色器里复用),幸存者的间接绘制参数直接写进命令缓冲(6.1 节黄金级闭环)。两个应用共同宣告:数据一旦进了显存,让它在 GPU 侧自循环,CPU 只当发令员。
⚠️ 常见坑:计算结果回读。直方图算完想打印看看、剔除完想知道剩几个——glReadPixels 式回读(1.1 节)会把整条流水线泡在等待里。正确姿势:让下一个 pass 直接消费(直方图进曝光计算、剔除结果进间接绘制);确需 CPU 知情时用带围栏的异步回读,或把「知道」变成一个 1×1 的迷你缓冲隔帧查询。
本节要点回顾
- 三层调度:全局网格 → 局部工作组 → 线程,全局号定数据、座位号支撑协作
- 共享内存加栅栏是协作核心:两级归约把原子竞争降两个数量级,「写后必栅、读前确认」
- 边界判断不能省:越界访问是未定义行为,非整除尺寸必判死
- 数据留在 GPU 自循环:粒子模拟与 GPU 剔除是「CPU 只发令」的样板工程
- 回读是禁忌姿势:下一 pass 消费或异步回读,直读必泡流水线
解剖台五完工,性能的三张病理切片(调用、搬运、计算形态)都已看遍。最后一章进终检台:怎么用工具看清每站的真实耗时、跨平台的坑怎么防、工程架构怎么组织——从「写得出」到「交付得了」的最后一公里。