7.1 调试与性能瓶颈定位
7.1 调试与性能瓶颈定位
本节摘要:把「猜」换成「测」需要三件工具的正确组合——调试输出回调接住驱动报错(第一道防线)、帧捕获器冻结一帧离线解剖(画面问题的显微镜)、计时器与剖析器量化提交与管线各站耗时(性能问题的听诊器)。本节给出工具分工表、完整的调试输出接入代码、瓶颈定位决策图与一段真实诊断复盘。6.1 节的定性试验在本节升级为定量流程。
三件工具的分工
| 工具 | 什么时候用 | 看什么 | 成本 |
|---|---|---|---|
| 调试输出回调(KHR_debug) | 开发全程常开 | 驱动的错误与性能警告,带来源与严重级别 | 近零 |
| 帧捕获器(RenderDoc 等) | 画面不对、顺序诡异 | 一帧内每条命令的状态、输入输出、逐 pass 像素历史 | 捕获瞬间卡一下 |
| GPU 计时器与剖析器(Nsight 等) | 帧率不达标 | 提交耗时、管线各站耗时、带宽计数器 | 有开销,测量期专用 |
分工的逻辑是由廉价到昂贵、由定性到定量:回调是免费的哨兵,永远开着;捕获器只在「画面错」时上场;剖析器动到的运行时开销大,只在「帧率低」的定位期使用,测量完关闭。顺序倒过来(一掉帧就上重量级剖析器)会让你陷进海量数据找不到方向——先用 6.1 节的「藏一半」试验定分岔,再选工具。
第一道防线:调试输出回调
OpenGL 4.3 的 KHR_debug 机制让驱动把警告与错误推给你注册的回调,附带来源(API 调用、着色器编译、性能提示)与严重级别。接入代码:
glEnable(GL_DEBUG_OUTPUT); glEnable(GL_DEBUG_OUTPUT_SYNCHRONOUS); // 同步回调:回调栈里能直接断点定位调用处 glDebugMessageCallback([](GLenum source, GLenum type, GLuint id, GLenum severity, GLsizei len, const GLchar* msg, const void*) { if (severity == GL_DEBUG_SEVERITY_HIGH) // 错误级:必须修 printf("[GL错误] %s\n", msg); else if (severity == GL_DEBUG_SEVERITY_MEDIUM) // 警告级:应当修 printf("[GL警告] %s\n", msg); // 低级别是性能提示与冗余信息,日志里留档即可 }, nullptr);
同步位的价值经常被忽视:开启后回调在问题调用发生的现场触发,调试器断点进回调时,调用栈直接指向肇事的那行代码——关掉同步位回调延迟到安全时机,现场就丢了。典型报告举例:「uniform 位置负一静默失败」(4.2 节)、「纹理格式与内部格式不匹配」、「启用了未完成的 FBO」——一大类「能跑但不对」的问题在这道防线上现形。工程纪律:开发构建常开、发布构建关闭(回调本身有成本),严重级别过滤分级处理。
⚠️ 常见坑:把性能提示级消息当错误修。驱动会报告大量「此操作可能降低性能」的低级提示(比如着色器里用了低效指令),全部处理会把精力淹没。按级别分流:错误必修、警告该修、提示留档定期复盘。
第二道:帧捕获器的解剖流程
RenderDoc 一类的工具把一帧的所有命令、状态快照、资源内容冻结下来,离线逐条回放。定位画面问题的标准流程四步:捕获(在问题可见的帧上抓一份);浏览命令流(绘制调用列表按提交顺序排列,每个调用展开看绑定状态与着色器);查看输出(选中一个可疑 pass,看它的渲染目标输出——颜色对不对、深度是否全空);回溯输入(输出错了就查它的输入:纹理内容对吗、uniform 数值对吗、顶点数据对吗)。第 5 章阴影案例的「满屏阴影」如果用捕获器走一遍,两分钟就能看到第二遍采样的深度纹理内容异常——比肉眼猜快一个数量级。它的像素历史功能还能选一个像素,列出「它被哪些绘制影响过、每次测试的成败」——2.4 节的关卡序列在工具里的可视化。
第三道:瓶颈定位的定量流程
图 7-1 瓶颈定位决策图:从症状到武器
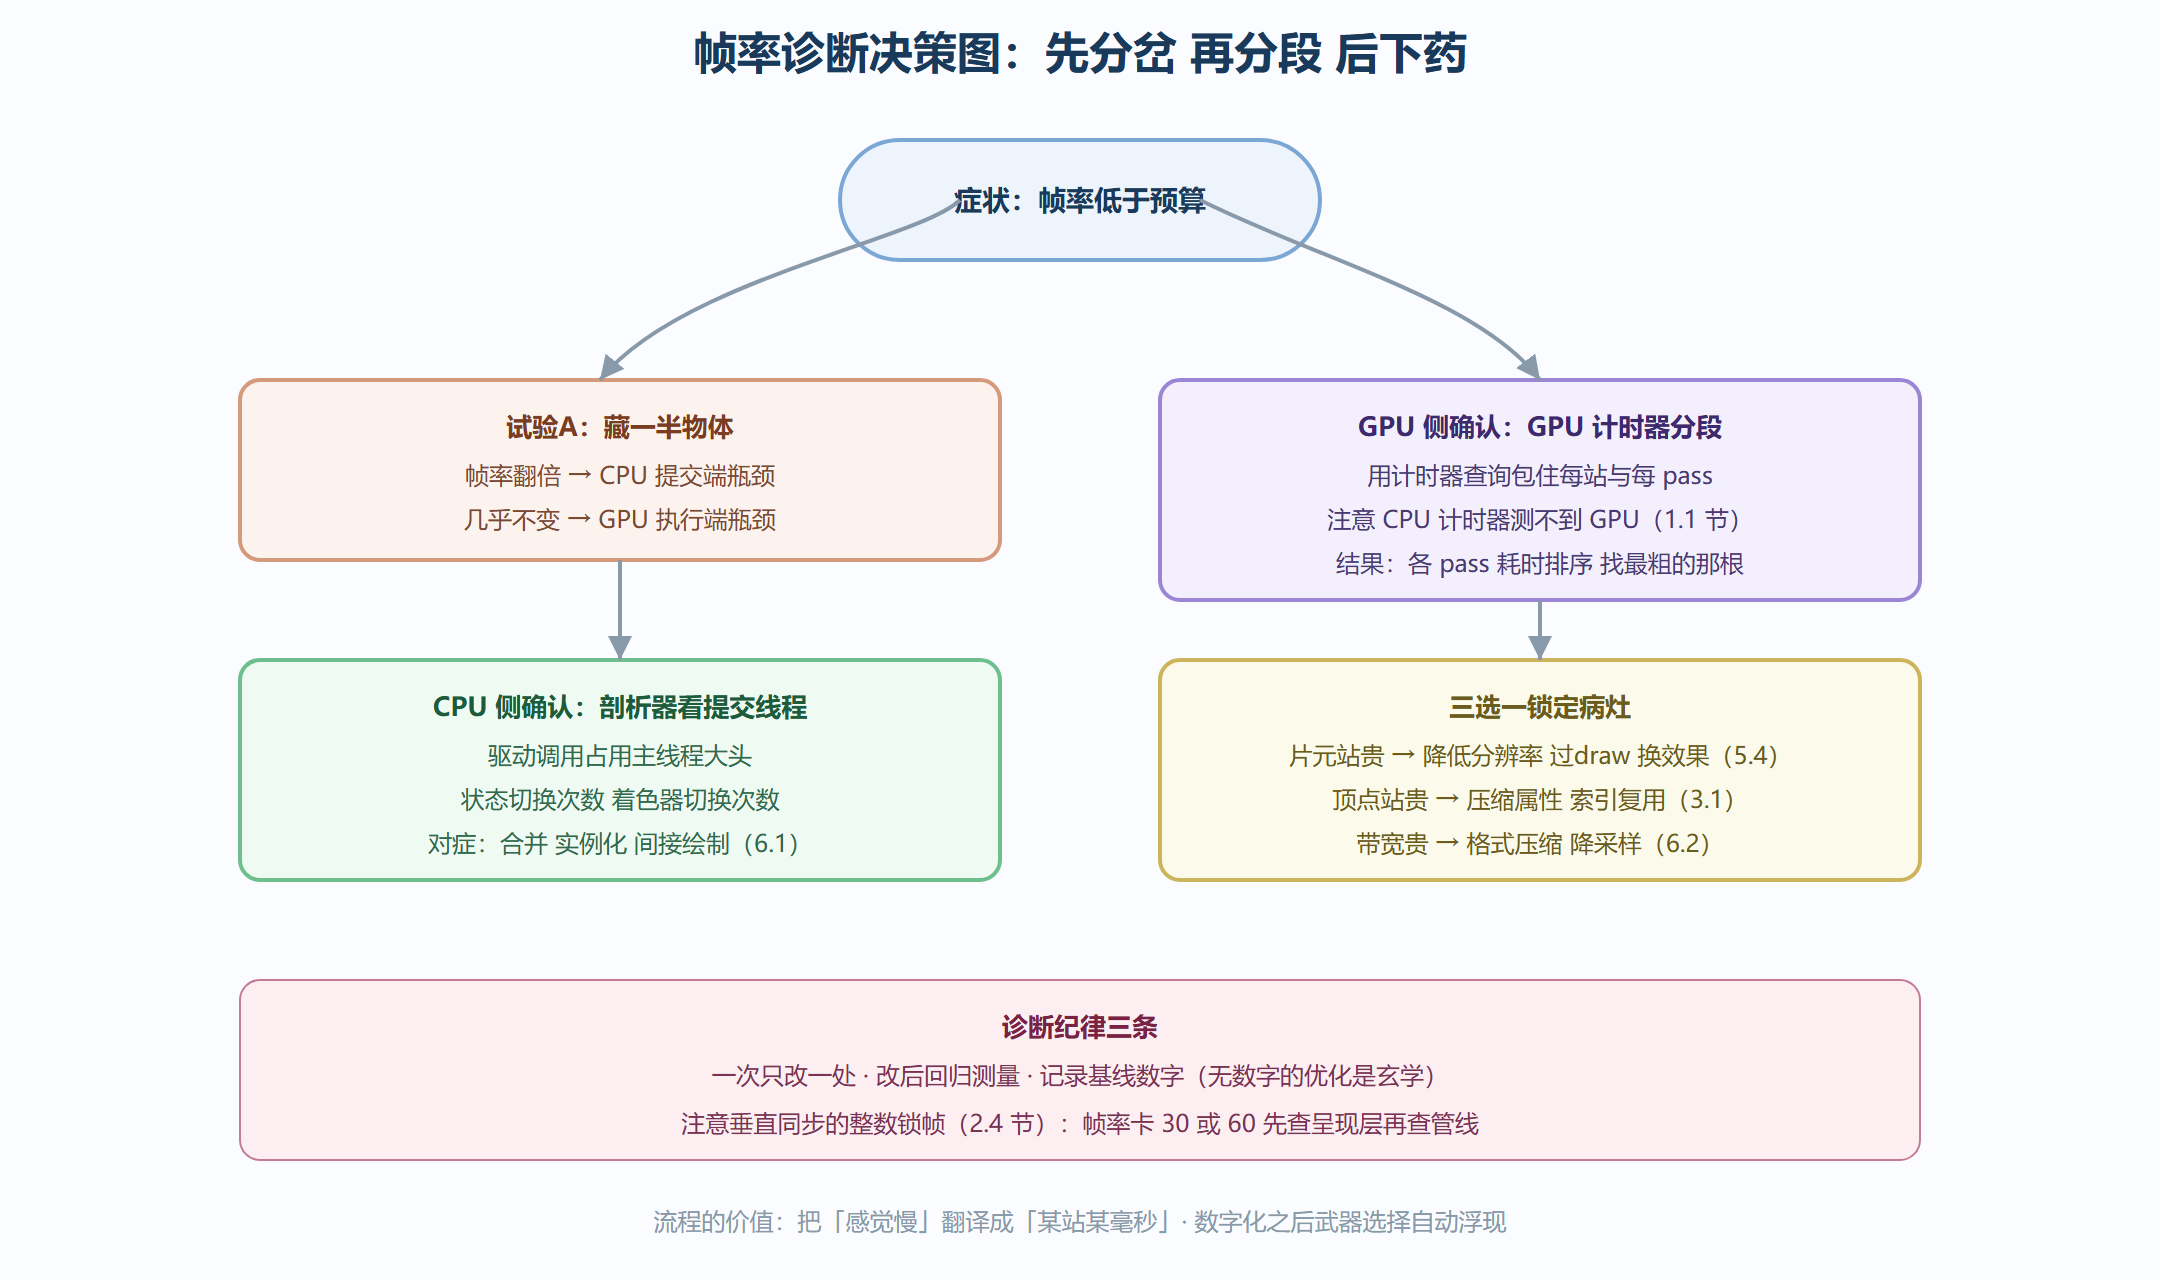
GPU 计时器查询的用法提纲: glBeginQuery 与 glEndQuery 包住要测量的命令序列,之后隔几帧取回(异步模型,立等会阻塞)结果纳秒数。把它包在「阴影 pass」「主渲染 pass」「后处理链」外围,各 pass 的耗时排行一出来,最粗的那根就是解剖对象——再把计时器往细包(着色器内部分段),病灶的分辨率逐级提高。
使用 GPU 计时器有两个容易踩的坑。坑一,取回时机:查询结果要「过几帧再取」,立即取回等于让 CPU 原地等 GPU(1.1 节的同步陷阱在测量环节重演)——标准做法是维护一个查询的环形池,本帧发起、三帧后收割。坑二,测量开销本身:成百上千个查询会占用驱动的查询资源、轻微扭曲被测对象(测不准原理的工程版),粗粒度先测 pass 级,确认可疑的 pass 再往细加密度,别一上来就全管线铺满探针。
💡 关键直觉:诊断工具链的最后一层是人肉纪律——建立「性能日志」:每轮优化前记录基线(各 pass 耗时、帧率、分辨率、GPU 型号),改一处,测一轮,记一行。三个月后回看,这张表会告诉你哪些优化在你的项目里真的有效——比任何网上转载的「优化技巧清单」都可靠,因为它是你自己的数据。
一段真实复盘:偶发掉帧
背景:一个场景平时 120 帧,每隔几秒掉到 40,无规律。操作:藏一半试验显示帧率掉落幅度不变——不是提交量的问题;剖析器看提交线程平稳——排除 CPU;GPU 计时器分段发现掉帧时段「后处理链」耗时从 1.2 毫秒跳到 9 毫秒。检查该时段的资源状态,发现纹理上传与后处理竞争同一条内存总线:后台线程每两秒流式上传一批贴图(用了普通上传而非 6.2 节的持久映射通道),总线被占满,全屏 pass 的采样集体变慢。把上传搬进持久映射缓冲并挪到帧首低峰期,掉帧消失。解读:「偶发」「无规律」的英文拼写通常是「并发资源竞争」——计时器分段的价值就是让这种不在任何单站账上的开销现形。变式:同类症状还包括窗口系统事件(文件拖拽触发重绘)、驱动后台编译新着色器变体——都靠「分段计时锁定时段 + 检查该时段的非渲染活动」这个组合拳。
本节要点回顾
- 三件工具由廉到贵:回调常开当哨兵、捕获器治画面病、剖析器治帧率病
- 同步回调保住现场:断点直指肇事调用,发布构建关闭
- 捕获器四步:捕获 → 浏览命令 → 查输出 → 回溯输入,像素历史可查关卡序列
- 先分岔再分段:藏一半定 CPU/GPU,计时器分段找最粗的 pass
- 无数字不优化:基线、单变量修改、回归测量,三条纪律守住诊断的科学性
瓶颈的诊断框架就位。下一节看移植关:OpenGL 在桌面、移动、浏览器上的三个变体,差异清单与降级策略的写法。