7.3 场景管理与渲染架构
7.3 场景管理与渲染架构
本节摘要:百万物体级别的场景靠三层剔除(视锥、空间剖分、遮挡)+ 材质排序 + 批处理组织渲染,代码层面靠「资源、场景、渲染器、平台」四层分层隔离复杂度。本节解剖剔除的收益账、四叉树与八叉树的选位、渲染器前段的完整流程,顺带覆盖字体与 UI 的合批渲染要点(距离场文字与图集批处理)。这是把前六章机制组装成工程的总装节。
先算剔除的账
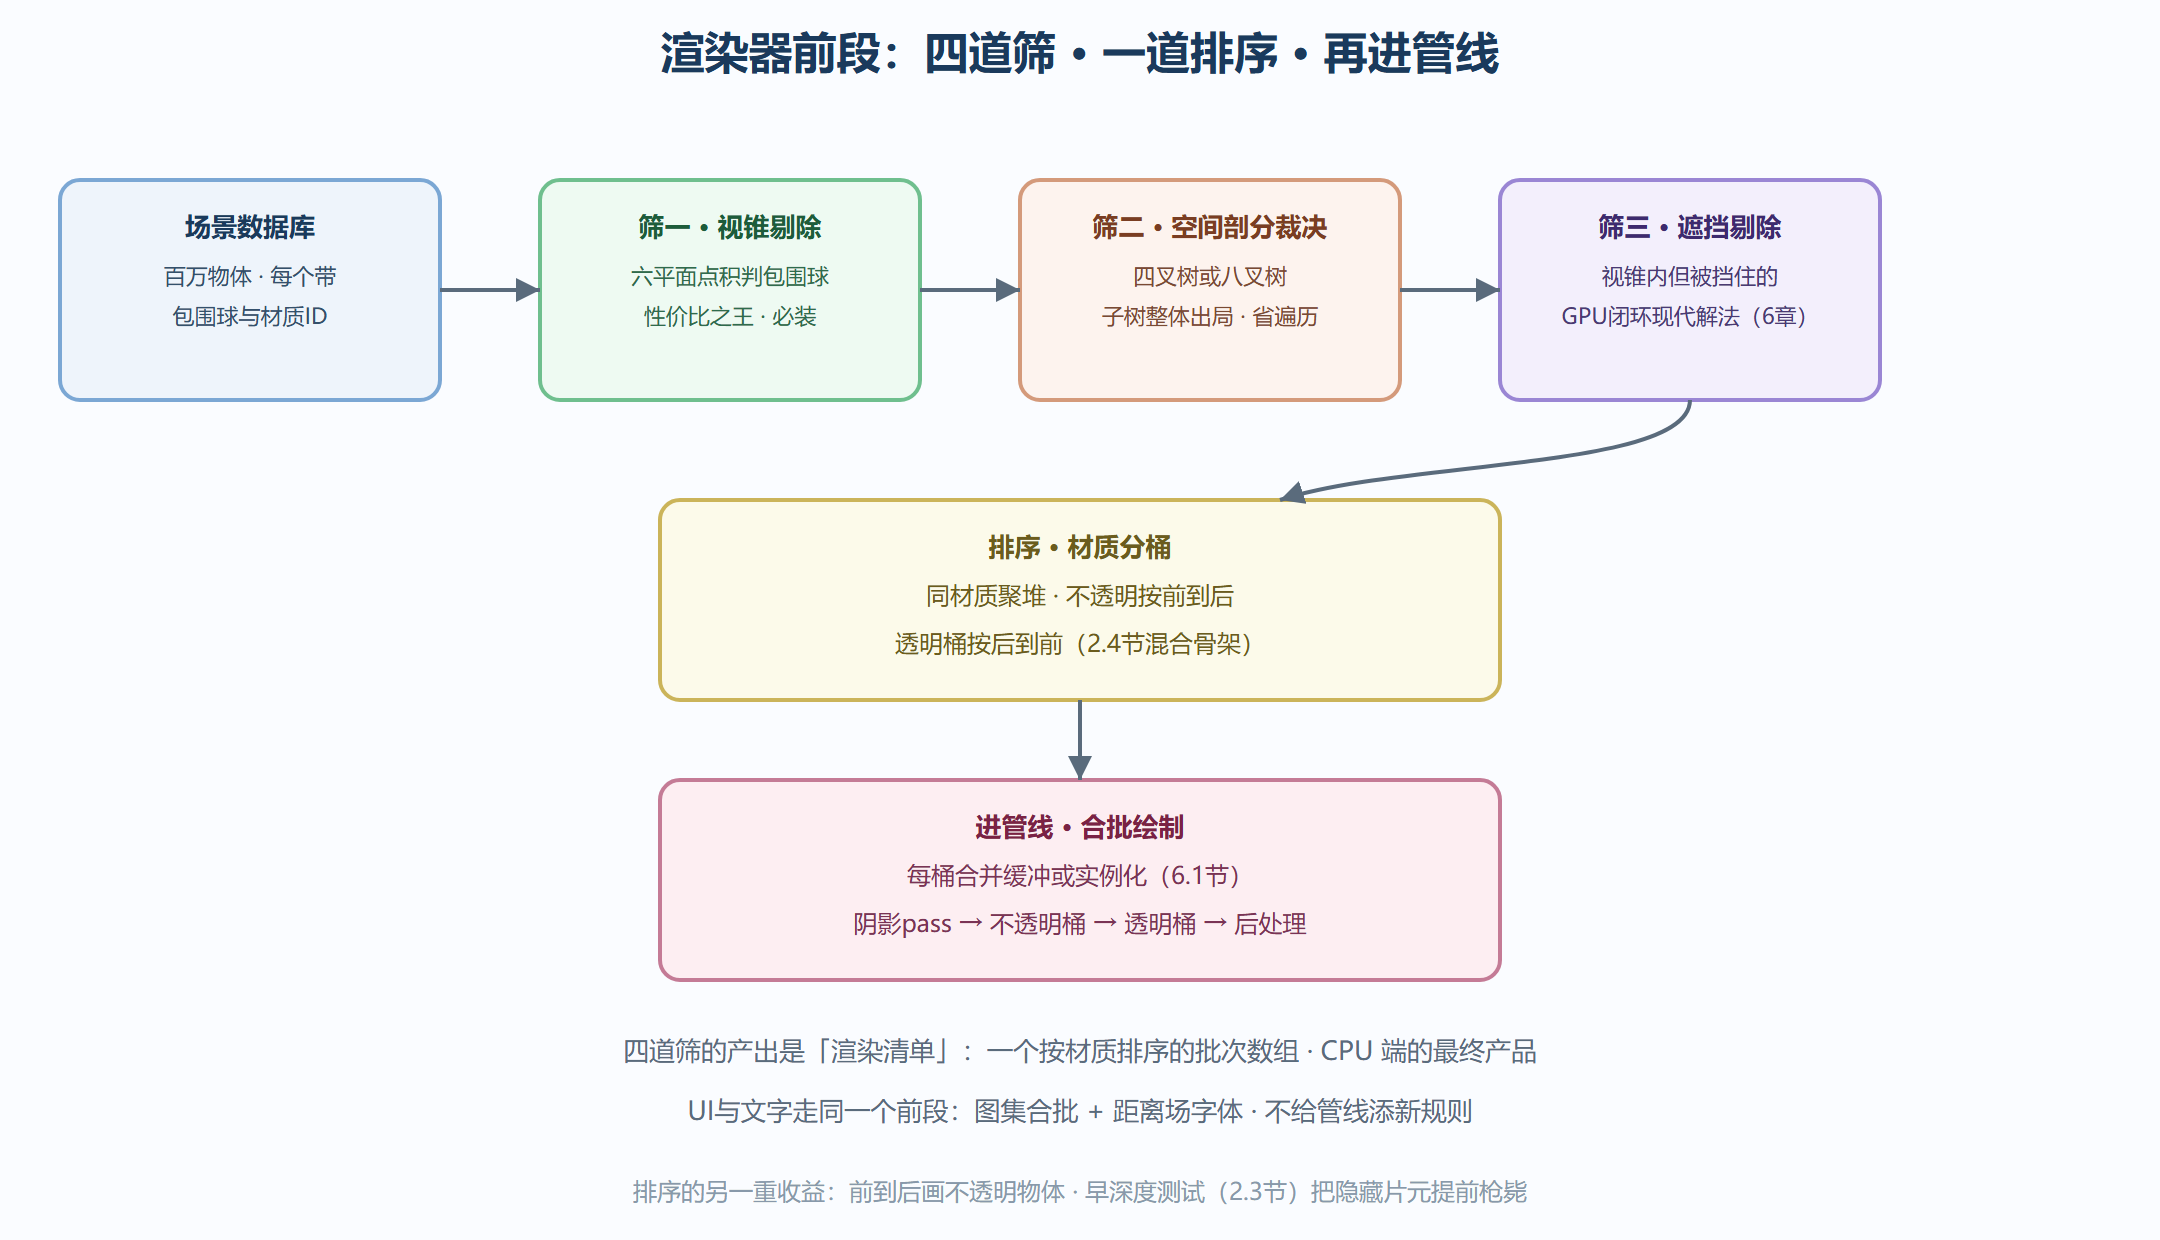
视锥剔除是性价比之王:一个物体是否在视锥内,用 4.3 节的六个平面方程点积判断——每个物体几十次浮点运算;被剔掉的物体,省下的是「顶点处理 + 光栅化 + 片元着色」的完整管线成本,千倍万倍的杠杆。第二层空间剖分把「每物体对每平面」的暴力检查(N 物体 × 6 平面)优化成「子树整体裁决」:八叉树的一个节点不在视锥内,整棵子树一次出局。第三层遮挡剔除处理「在视锥内但被挡住」的物体(墙后的一万件家具),收益同样巨大但成本与实现复杂度陡增——第 6 章的 GPU 闭环是它的现代解法。
图 7-3 渲染器前段:场景进入管线前的四道筛与排序
空间剖分的选位
四叉树(平面切四份)与八叉树(立体切八份)的选型看数据分布:地形、城市场景多为平面铺开用四叉树;体数据、三维分布的物体集用八叉树。剖分的工程要点三条。包围体的懒更新:动态物体移出所在节点要重新挂树,逐帧重挂是性能灾难——「物体带速度的允许暂存旧节点、误差超阈值再迁」是常见折中。深度即粒度:树太深查询开销涨、太浅剔除精度降,物体密度定深度,别拍脑袋。松散节点:把节点的包围范围略放大让边界物体不必跨节点反复迁移——一个参数换一片安稳。这三个要点都在回答同一个矛盾:空间的静态结构与物体的动态位置永远在打架。
包围体本身的选择同样是一笔账:包围球查询最便宜(一个距离判断)但贴合松(细长物体浪费严重),轴对齐包围盒贴合更好但判断贵一倍,有向包围盒最贴合又最贵。工业实践的主流是两级组合:树节点用包围球(粗糙快速的整树裁决),叶子上的精细剔除用轴对齐包围盒。选错级别的症状是「剔除明明在跑,帧率却不见好」——松的包围体把大量看不见的物体放进了渲染清单,7.1 节的剖析器里表现为「绘制调用数与视野内物体数不匹配」。
渲染器的代码分层
四层各管各的,依赖单向向下:平台层(窗口、上下文、加载器——1.3 节三件套的封装,隔离操作系统差异);资源层(缓冲、纹理、程序对象的生命周期与缓存——第 3、4 章内容的对象化,着色器变体缓存也住这层);场景层(纯数据的场景图与空间索引,不碰任何 GL 调用——可以被物理、AI 等其他系统共享);渲染器层(每帧消费场景数据产出渲染清单与绘制序列——前述四道筛加后处理链的编排)。分层的验收标准:「换一个窗口库只动平台层」「加一种新材质只动资源层配置加一个着色器变体」「换渲染策略(前向换延迟)只动渲染器层」。
场景层与渲染器层的分离特别值得强调,因为它决定了多人协作的边界:场景层是纯数据(物体、变换、材质引用),美术工具链、物理系统、脚本逻辑都在往里写;渲染器层是纯消费(每帧从场景层拉取可见子集)。两者之间唯一的接口就是每帧的剔除查询——只要这个接口稳定,渲染器内部随便怎么改(前向换延迟、加 GPU 剔除、换排序策略),场景层与其他系统无感。反例是「渲染器直接改场景数据」(比如渲染时顺手更新物体状态):依赖关系瞬间从单向变成网状,任何渲染优化都可能踩坏游戏逻辑——这是图形代码腐化的头号起点。
// 渲染器主循环的骨架:分层后的每帧只剩编排 void Renderer::renderFrame(const Scene& scene, const Camera& cam) { visibleList.clear(); frustumCull(scene.octree, cam, visibleList); // 筛一二:空间裁决 sortBuckets(visibleList, cam); // 排序:材质分桶+深度次序 shadowPass(visibleList, sun); // 阴影pass(5.2节) opaquePass(visibleList, cam); // 不透明桶:前到后 transparentPass(visibleList, cam); // 透明桶:后到前 关深度写 postChain->execute(hdrTarget); // 后处理链(5.4节) present(); // 交换缓冲(2.4节) }
骨架的每行都对应前六章的一个机制——工程架构的本质就是把散落的机制按帧的时序编排成流水线,让每个环节可替换、可测量(7.1 节的计时器天然按 pass 插桩)。
UI 与字体的合批要点
界面元素是「矩形 + 贴图」的同构批处理问题。两个要点。图集合批:把所有 UI 碎图打进一张大纹理(图集),所有矩形共享一个着色器一次绘制——不同小图各绑一次纹理是 UI 帧率杀手,2.4 节的状态机账在 UI 上最密集。距离场文字:把字形存成「到笔画的距离」而非像素颜色,渲染时按距离阈值实时光栅化——同一份字形数据任意缩放不失真、描边阴影用距离运算免费获得;小字号锯齿与放大模糊这两大传统毛病一次根治,代价是离线生成距离场的一步资产管线。UI 渲染与 3D 场景共用同一个前段(同一个合批与排序逻辑),只是数据源换成图集矩形——不为 2D 另立一套管线规则,是架构克制的体现。
⚠️ 常见坑:UI 逐元素提交绘制调用。一个中等复杂度的界面轻松三百个元素,逐个 draw 就是三百次管理费(6.1 节的账)。合批成三五个调用是底线——图集加顶点缓冲拼矩形流,UI 库内部都在做这件事,自研 UI 前先想清楚。
本节要点回顾
- 剔除是千倍杠杆:视锥必装、剖分省遍历、遮挡上 GPU 闭环,按复杂度递增逐层加装
- 排序双收益:材质分桶省切换,前到后省片元(喂饱早深度测试)
- 前段产出渲染清单:四道筛加一道排序,CPU 端每帧的最终产品
- 四层架构单向依赖:平台、资源、场景、渲染器各管各的,换件不动全身
- UI 走同一前段:图集合批加距离场文字,不为 2D 立新规
最后一节把视角拉到行业:CAD、医学可视化、仿真这些「不追帧率追准确」的领域,对 OpenGL 的要求与游戏差在哪——终检台的收官切片。