3.3 嵌套消息、字符串与repeated的字节形态
3.3 嵌套消息、字符串与 repeated 的字节形态
本节摘要:wire type 2 的"长度前缀 + 字节串"承载了字符串、bytes、嵌套 message、repeated 元素与 map 键值对五种结构,它们在字节层完全同构——嵌套 message 的载荷本身就是一段合法的 wire format 字节流,解析是递归的。本节拆解长度前缀机制、repeated 的两种编码(packed 与非 packed)、同编号字段出现多次时的合并规则,并用一个多层嵌套的完整 dump 收官。
本章收官:3.1 的 tag 骨架、3.2 的 varint 载荷,加上本节的长度前缀递归,三把尺子凑齐——此后任何 Protobuf 字节流在你面前都没有黑箱。
长度前缀:给自己标尺的字节串
wire type 2 的载荷统一格式是"一个 varint 长度 + 这么多个原始字节":
tag(编号,LEN) + len(varint) + 内容字节 × len
字符串 "hello" 的字段 2 编码是 12 05 68 65 6C 6C 6F:tag 12、长度 05、五个 ASCII 字节。bytes 同理。嵌套 message 的特殊之处在于:内容字节本身就是一段完整的子消息字节流——把 12 0B ... 里的 11 个字节单独拎出来,它自己也是按 tag+载荷规则排布的。解析器读到 wire type 2 且契约说这是嵌套 message 时,就在载荷长度范围内递归调用自己。这个设计让 Protobuf 的结构表达获得了无穷的嵌套深度,同时长度前缀保证了解析器永远知道边界在哪——子消息内部的任何错乱都被封闭在自己的长度区间内。
repeated:同一 tag 反复出现
repeated 字段的默认形态朴素得惊人:同一编号的 tag+载荷 重复 N 次。
message Findings { repeated int32 codes = 1; }
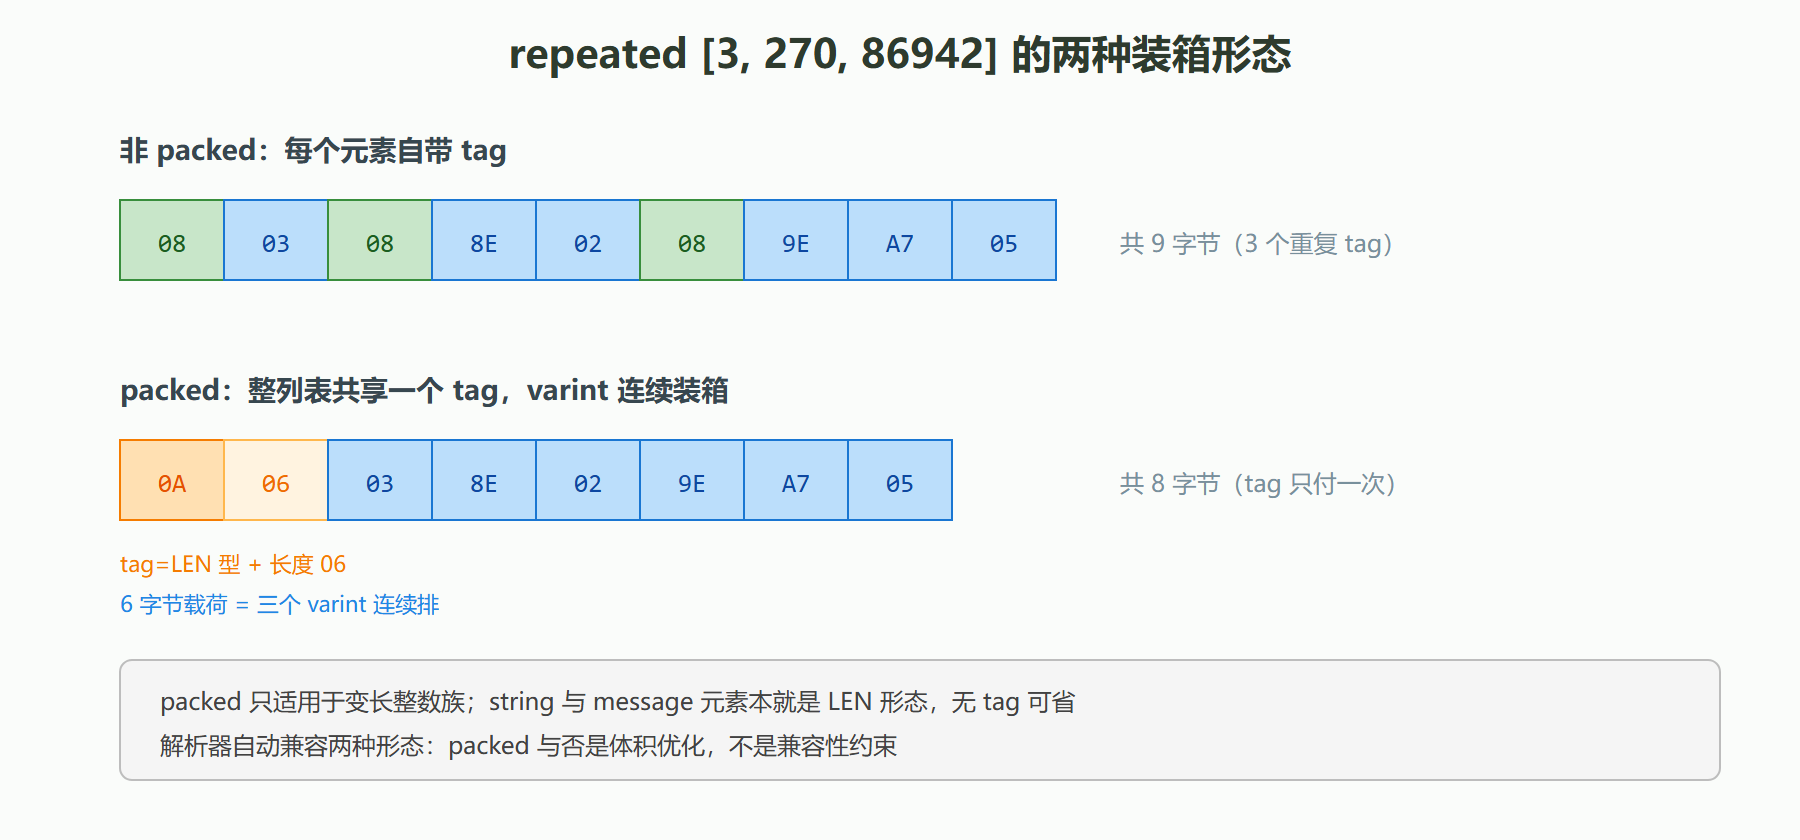
codes 为 [3, 270, 86942] 时(非 packed 情形):
08 03 ← 字段1 varint 3 08 8E 02 ← 字段1 varint 270 08 9E A7 05 ← 字段1 varint 86942
三个元素各带各的 tag。这解释了 2.1 节"repeated 字段用热区编号"的乘数效应:编号 1 的 tag 是 08(1 字节),若用编号 16 则每元素多付 1 字节,百万元素就是百万元级字节。
packed:变长整数的批量装箱
对数值型 repeated 元素,proto3 默认启用 packed 编码——整个列表共享一个 tag,所有元素的 varint 连续装箱:
0A 06 03 8E 02 9E A7 05
tag 换成 LEN 型(字段 1、wire type 2),长度 6,随后三个 varint 紧密排列。对比非 packed 的 9 字节,packed 只要 8 字节——重复 tag 的开销被压成了一次。元素越多、值越小,packed 优势越大。两条工程须知:其一,packed 只适用于变长整数族(varint、fixed 等),string 与 message 元素本来就是 LEN 形态、无 tag 可省,不参与 packed;其二,解析器必须同时接受 packed 与非 packed 两种形态(wire type 自动判别),所以新旧契约混用时不会出错——packed 与否不是兼容性约束,纯粹是体积优化。
图 3-3 repeated 的两种装箱形态对比
map 的真身现场
第 2 章说 map 的真身是"重复的键值对 message",现在可以在字节层验尸。定义:
message Index { map<string, int32> counts = 1; }
counts 为 {"a": 1, "b": 2} 时,实际字节流是:
0A 05 0A 01 61 10 01 ← 第一个键值对 0A 05 0A 01 62 10 02 ← 第二个键值对
拆第一个键值对:外层 tag 0A(字段 1、LEN)、长度 05、然后是一段子消息——子消息里 0A 01 61 是键 "a"(隐藏消息的字段 1、string)、10 01 是值 1(字段 2、varint)。整个 map 在字节层就是 repeated 的隐藏 Entry message,与手写一个 repeated CountsEntry 的编码一字不差。这也解释了键序不保证的根源:repeated 是有序的,但各语言运行时把 repeated Entry 收进哈希表再吐出来,顺序自然丢失。
同编号字段出现两次:合并规则
字节流里同一编号的字段出现多次(合法来源:repeated;畸形来源:手写编码器 bug 或 merge 操作),解析行为按类型分三种:
| 字段类型 | 多次出现的行为 |
|---|---|
| 变长/定长标量 | 后值覆盖前值——"最后一个赢" |
| string/bytes/message(singular) | 各语言普遍按拼接处理:C++ 等实现拼接 string,message 则递归 merge |
| repeated | 全部追加为元素 |
这个"最后一个赢"规则正是 oneof 互斥语义的字节层靠山(第 2.3 节"畸形消息里只有最后一个存活")。merge 语义也被 protobuf 的 API 显式利用——运行时库普遍提供 merge 接口,把消息 A 与消息 B 合并时,实际就是把两段序列化字节按上述规则叠加。
实战案例:解剖一段三层嵌套的完整 dump
背景:考古队的出土记录消息,三层结构:
message Coordinate { int32 x = 1; int32 y = 2; } message Artifact { string catalog_no = 1; Coordinate found_at = 2; } message Trench { string id = 1; repeated Artifact artifacts = 2; }
Trench 数据:id 为 "T7",一个器物(编号 "A100",坐标 x=3 y=4)。dump:
0A 02 54 37 12 0C 0A 04 41 31 30 30 12 04 08 03 10 04
操作:用三把尺子逐层解剖。第一层(Trench):tag 0A 是字段 1(id)、LEN 型,长度 02,内容 54 37 即 "T7"。tag 12 是字段 2(artifacts)、LEN 型,长度 0C 即 12 字节,载荷为一段 Artifact 子消息。第二层(Artifact 子消息):tag 0A 字段 1(catalog_no)LEN 长度 04,内容 41 31 30 30 即 "A100"。tag 12 字段 2(found_at)LEN 长度 04,载荷为 Coordinate 子消息。第三层(Coordinate):tag 08 字段 1 varint 值 3;tag 10 字段 2 varint 值 4。结果:完整还原三层结构,每个字节各归其位,总长 17 字节。解读:注意长度前缀的嵌套关系——外层 artifacts 的 12 字节恰好覆盖其全部子内容,Coordinate 的 4 字节也精确闭合。长度前缀的每一层都是"给解析器的边界承诺",多层嵌套下没有任何歧义字节。变式:若这个 repeated 字段有第二个 Artifact,dump 会出现第二个 12 xx——同 tag 再来一段。解码循环的处理逻辑就是"读到字段 2 就 push 一个新 Artifact",这正是 repeated 语义的实现现场。
⚠️ 排障技巧沉淀:拿到任何 dump,先按 tag 找出顶层字段边界,再对每个 LEN 载荷判断"契约里是 string 还是 message"——如果是 message 就递归下去。decode_raw 干的就是这件事的自动化版本,而你现在已经拥有了它的人工版本。
本节要点回顾
- LEN 同构五连:string、bytes、嵌套 message、repeated 元素、map 键值对在字节层同一形态,map 就是 repeated 隐藏 Entry;
- 递归是本质:嵌套 message 的载荷本身就是合法子字节流,长度前缀层层封闭边界;
- packed 省重复 tag:数值型 repeated 默认装箱,元素多值小时收益大,新旧形态解析器通吃;
- 同编号多次出现:标量最后一个赢、message 递归 merge、repeated 追加——oneof 互斥的字节层靠山;
- 三把尺子毕业:tag 位运算、varint 手算、长度前缀递归——此后没有黑箱。
契约与字节两层都通了你,接下来看它们之间那台翻译机器:protoc 编译器如何把 proto 文件变成各语言的桩代码。