5.1 兼容性三铁律:从编码机理到演进纪律
5.1 兼容性三铁律:从编码机理到演进纪律
本节摘要:Protobuf 的兼容性可以压缩成三条铁律:字段编号只增不改、wire type 变更视同换字段、新增字段走全新编号。每条铁律都是第 3 章编码机理的直接推论——本节把推论过程完整走一遍,并给出违反每条后的字节层灾难现场。读完你应当能把这三条讲给任何团队成员听,且不需要背文档就能自己推导出第四条、第五条细则。
本章的立法环节。第 3 章你已经知道 tag 怎么编码、载荷怎么跳过——本节的任务是把"解码器的工作方式"翻译成"schema 作者的行为纪律"。
铁律一:编号只增不改
内容:已发布字段的编号永不改变,永不重用;删除字段必走 reserved 注销。
机理:字节流里字段的唯一身份是编号(3.1 节)。改名无害,因为名字不进字节流;改编号等于让旧字节流里的旧身份被新契约解读成另一个字段。
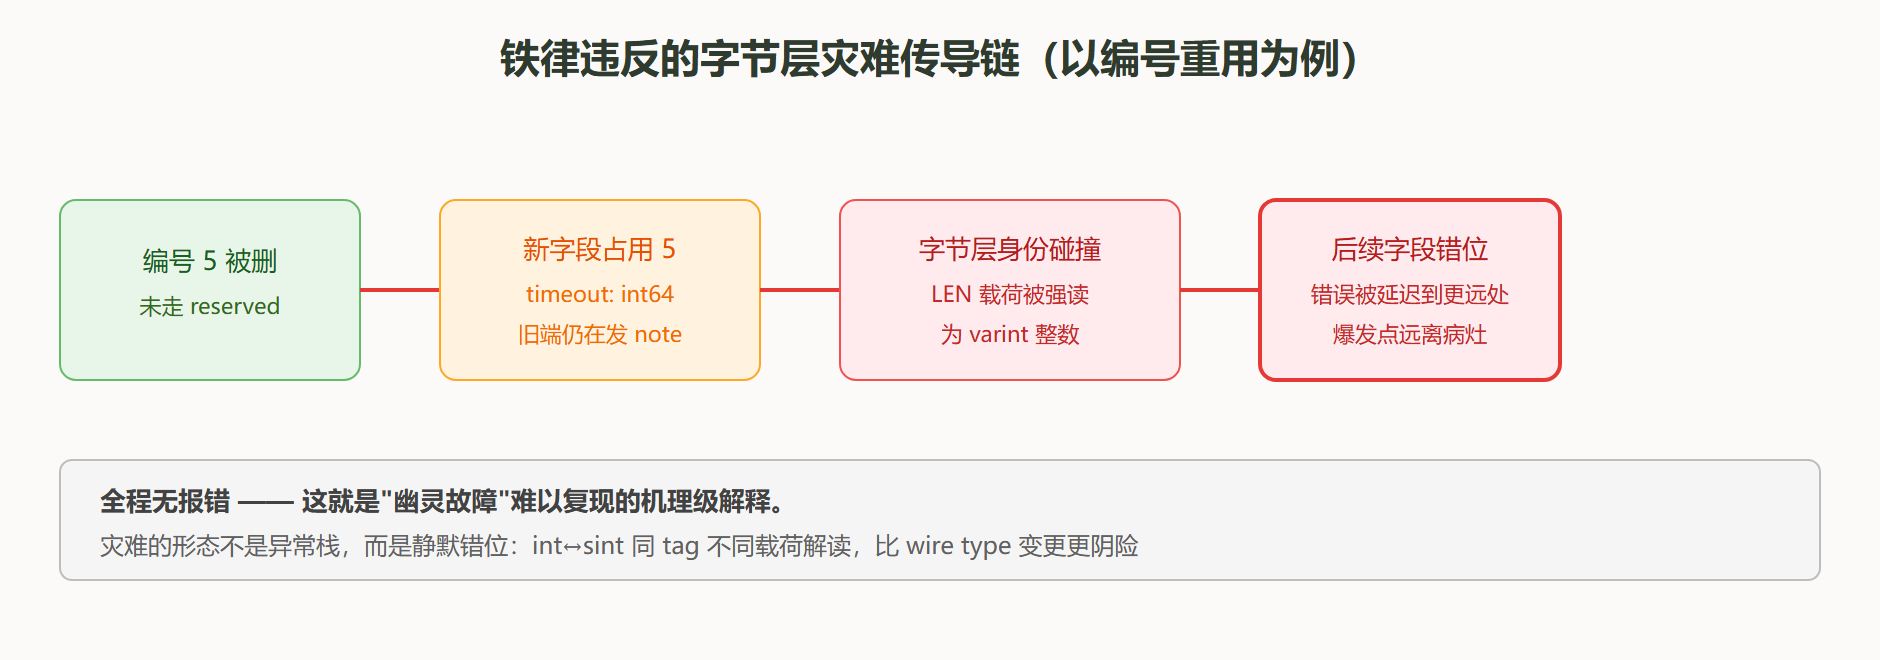
灾难现场:字段 5 原本是 string note = 5,被删除且未 reserved。半年后新字段 int64 timeout = 5 上线。某个仍在运行的老服务还按旧契约发着 note 数据——它发出的 2A 09 ...(字段 5、LEN、9 字节字符串)被新端按 int64 解读:LEN 载荷被强读为 varint,字符串首字节的二进制被拼成一个巨大而荒谬的整数,全程无报错,下游拿到的 timeout 是一个天文数字。更糟的顺序错位:字段 5 后面的所有字段都要从错位点重新对齐,如果 LEN 载荷长度恰好让后续字节"碰巧"对上某个合法结构,错误会被延迟到更远的地方爆发——这就是"幽灵故障"难以复现的机理级解释。
铁律二:wire type 变更视同换字段
内容:改变字段的 wire type 等价于改编号——旧端无法正确解读新载荷。要换类型,走"新编号新字段、旧字段废弃"的路线。
机理:解码器靠 wire type 决定怎么读载荷(3.1 节六形态表)。int32 与 int64 同为 varint 可以平滑扩位;但 int32 改 string(varint 改 LEN)、int32 改 sint32(同为 varint 但载荷解读规则不同)、int32 改 fixed32(varint 改定长)都改变了载荷的读法。
灾难现场:int32 改成 sint32。旧端发出的值 -3 编码为 10 字节全 1 尾缀的 varint;新端按 ZigZag 解读,读出一个荒谬的正数。反向同样错。最阴险的是 int32 与 sint32 的 tag 完全相同(wire type 同为 0)——没有任何解析层错误信号,数值静默错位。对比 int32 改 string:wire type 从 0 变 2,旧端至少会在读载荷时发生长度错位,故障虽难查但有错可报。所以 wire type 内的语义变更(int↔sint)比 wire type 间的形态变更更危险。
铁律三:新增走全新编号,语义永不变质
内容:新字段必须使用从未用过的编号(reserved 的也算用过);已发布字段的语义不许改变——类型兼容的"偷换概念"同样禁止。
机理:前半条是铁律一的镜像——新编号才不会与任何在途字节流冲突。后半条的机理更微妙:string city = 8 从"用户注册城市"改成"用户当前所在城市",类型没变、编号没变、wire type 没变,字节层完全兼容——但语义契约已经对旧数据撒谎。三个月前落库的 city 字节流,含义在新契约下被重新解释,统计口径无声漂移。序列化层的兼容机制管不到语义层,这条铁律必须靠 code review 守住。
推论练习:自己推出第四条
三条铁律的价值在于可推导。练习:repeated 字段与 singular 字段互转安全吗? 用 3.3 节的机制推理:singular 的多次出现按"最后一个赢/merge"处理,repeated 语义是"追加"——把 singular 改成 repeated,旧端发的单次字段会被新端正确读成单元素列表,安全;反向,repeated 改 singular,新端读旧端的多次出现数据会触发 merge/覆盖语义,元素顺序信息丢失、语义取决于具体实现——判"可协商但不建议"。你能完成这个推理,说明铁律的机理已经内化,后续遇到任何变更提案都能现场推导,不必查表。
图 5-2 铁律违反的字节层灾难传导链
实战案例:一次未遂的"顺手重构"
背景:评审会上,同事提案把 string device_id = 4 改名为 string client_device_id = 4,同时"顺手"把旁边的 sint32 tz_offset = 6 改成 int32 tz_offset = 6——理由是"团队里没人用负数时区差,int 更常见"。操作:改名直接放行(名字不进字节流,生成代码重新编译即可);tz_offset 的类型变更当场拦下,按铁律二要求走双字段路线:新增 int32 tz_offset_v2 = 11,旧字段 6 标 deprecated 进观察期,两个季度后走 reserved。结果:观察期里日志平台(消费历史数据)继续按旧字段解析全部存量;新写入双写两字段,迁移完成后旧字段退役。解读:"没人用负数时区差"是典型的语义层侥幸——时区差为负的半球用户(西经地区)在下一轮融资后的国际化里就会出现;更关键的是 int↔sint 的静默错位性让这类变更不能靠灰度验证发现(灰度流量可能恰好没有负值样本)。变式:如果这个字段确实从未有过负值且有数据佐证,还有一条更彻底的路——直接视为字段重定义:废弃 6 号、新开 11 号,让新旧语义在编号层面物理隔离,代价是迁移期双写成本。
本节要点回顾
- 铁律一(编号):编号是字节流的唯一身份,改编号/重用编号等于制造静默错位,删除必走 reserved;
- 铁律二(wire type):载荷读法变更视同换字段,int↔sint 因 tag 相同而最阴险;
- 铁律三(语义):类型兼容的偷换概念字节层查不出,语义稳定靠 review 守护;
- 可推导性:repeated↔singular 的安全性可以自己从"多次出现的合并规则"推出来——机制内化比背表可靠;
- 灾难的形态:不是报错,是错位、静默、延迟爆发——幽灵故障的编码层根源。
三条铁律是原则,下一节把它们细化成一张可执行的变更操作分级表——每个高频争议项(int 扩位、enum 加值、string 换 bytes)都给出裁决与迁移路径。