9.4 日志管道与大数据的schema治理
9.4 日志管道与大数据的 schema 治理
本节摘要:大数据现场的特征是数据生命周期以年计、消费方以团队计、schema 演进以月计——三者叠加让"契约治理"成为比编码性能更重要的主轴。本节拆解 protobuf 进 Kafka 的两种姿势、与 Avro 的管道场景对比(第 1.3 节选型结论的深化)、以及数仓侧列式落地的完整链路。读完你应当能为数据管道设计出支撑五年回溯的 schema 管理方案。
最后一个现场,时间尺度最长。前面所有现场的数据都以"次"为单位消费,这里的数据要被未来五年里任何时刻启动的批处理作业反复回放——第 5 章演进规则在这里面对的是"时间上的全版本共存"。
protobuf 进管道的两种姿势
姿势一:JSON 信封嵌 protobuf。 消息体是 JSON,其中某个字段装 base64 编码后的 protobuf 字节。这是渐进采用的常见形态:管道已有 JSON 生态(ELK 检索、告警规则),只有大体量字段(明细列表、坐标轨迹)用 protobuf 压缩。代价:base64 膨胀 33%(第 2.2 节教训的管道版)、管道中游无法直接读 protobuf 内部(必须解码)。定位:过渡形态或"百分之九十小字段 JSON、百分之十大字段 protobuf"的稳定混合态。
姿势二:裸 protobuf 加外部注册表。 消息体就是 protobuf 字节流,schema 信息与数据分离——每一批数据必须能找到"写它时"的 schema。这是管道场景与 RPC 场景的根本差异:RPC 里两端实时协商版本,管道里写入方与五年后的读取方永不见面,schema 的可寻址性成为架构的第一问题。治理形态:数据带头部携带 schema 标识(topic 级或消息头的 schema 版本号或指纹),版本化的 desc.pb(第 4.1 节产物)归档进 schema 仓库,版本与标识的映射永久可查。Kafka 生态里 Confluent Schema Registry 是这个模式的现成基建(原生为 Avro 设计,protobuf 亦受支持)。
与 Avro 的管道对决
第 1.3 节选型表给过结论的管道版深化。Avro 的管道优势有三:按名解析天然适配"写读双版本"(读方拿自己的 schema 对照写方 schema 解析,无需版本协商——这就是 Schema Registry 生态的根基);列存亲和(Avro 的无字段标识编码与 Parquet/ORC 的列式模型血缘相近,转换路径短);Registry 生态成熟(序列化器内嵌注册协商,增删字段全自动对齐)。protobuf 的管道优势同样三条:与在线服务同源契约(微服务用 protobuf 的团队,管道契约可以直接复用在线 proto,一份契约两处消费——第 9.1 节集中仓的自然延伸);自描述性更强(decode_raw 无 schema 也能勘察,第 1 章的勘察铲在管道排障里依旧锋利);多语言生产端覆盖(埋点 SDK 的语言矩阵)。
裁决判据收束成一条:契约的主战场在哪,管道就跟到哪。在线微服务群是 protobuf 的团队,管道用 protobuf 加注册表治理,契约同源的收益大于 Avro 的管道原生性;纯数据团队(无在线契约遗产、Hadoop 系栈为主)选 Avro 顺流而下。混合态也健康:埋点与业务事件走 protobuf(复用在线契约),日志类半结构化数据走 Avro 或 JSON——按数据源分治而不是统一论。
数仓落地:列式转换的链路
protobuf 字节流进数仓前的最后一跳:流式或批式地解码 protobuf、转 Parquet 列式。这条链路的工程要点:
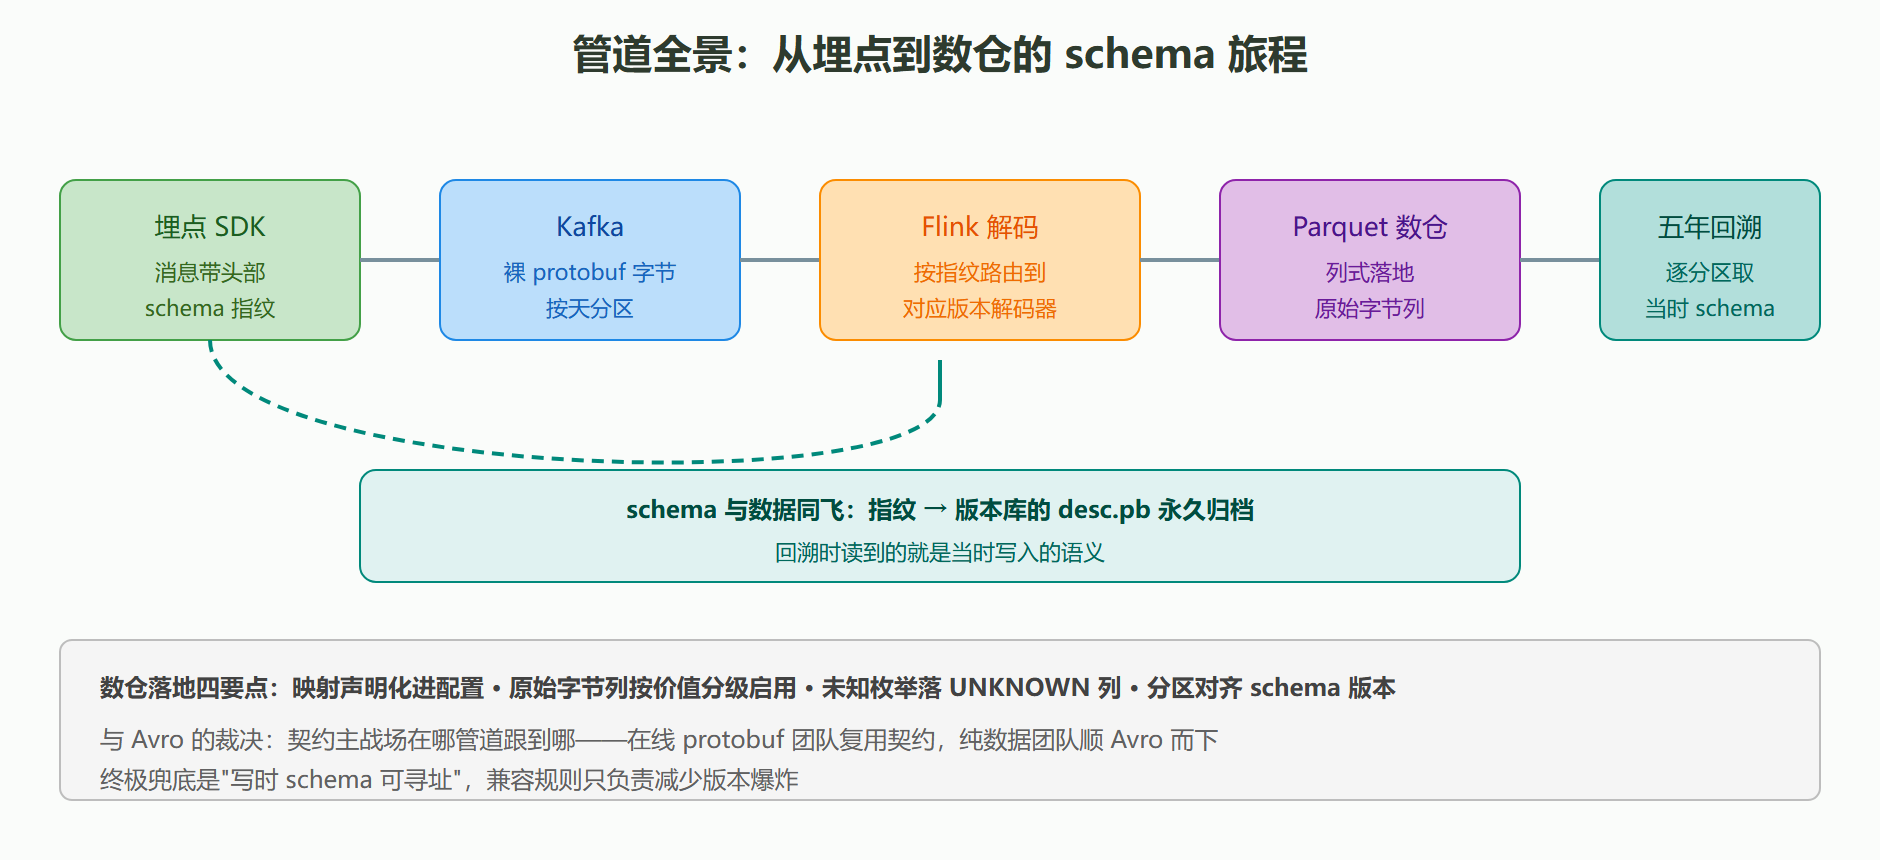
- schema 映射的声明化:proto 字段到列的映射(含 repeated 展开为嵌套列、map 展开为键值列)写进配置而非代码——proto 演进时映射配置走 review,5.2 节清单的数据版;
- 未知字段的落库策略:转列式时未知字段无处安放——通用做法是额外的"原始字节列"(整条 protobuf 原文落一列,供未来重放),存储成本换回溯能力,按数据价值分级决定哪些表启用;
- 枚举的列式形态:落库名字字符串而不是数值(人类可查),但转换器要处理未知枚举值(落"UNKNOWN"标记列,不丢弃——5.2 节降级义务的数仓版);
- 时间分区与 schema 版本对齐:按写入时间分区天然对齐 schema 版本边界——回溯五年数据时,每个分区用"它写入时"的 schema 解析,全版本共存的治理落点。
图 9-3 管道全景:从埋点到数仓的 schema 旅程
实战案例:一个埋点系统的五年回溯治理
背景:某公司埋点日均 200 亿条(第 1.3 节选型案例的后续),Kafka 加 Flink 加 Parquet 数仓,契约演进频繁,法务要求数据可回溯五年。操作:管道选型定 protobuf 加 schema 仓库(在线微服务群已用 protobuf,契约同源收益优先);埋点 SDK 输出带 schema 指纹头(描述符的哈希)的消息,指纹到 desc.pb 的映射归档进版本库;Flink 作业按指纹路由到对应版本的解码器(作业自带最近 N 个版本的解码矩阵);Parquet 落地按天分区、schema 版本对齐分区边界,原始字节列对高价值事件族启用;回溯工具链——按时间范围起批处理,逐分区取"当时"的 desc.pb 解码,枚举未知值落 UNKNOWN 列。结果:五年间契约演进百余次,两次全量回溯(一次法务取证、一次指标重算)都完整成功——回溯时读到的就是当时写入的语义。解读:这个系统的全部韧性来自一条主设计——数据与 schema 指纹同飞、版本归档永久可查;第 5 章的兼容规则在这里的角色从"约束演进"变成"减少版本爆炸"(兼容演进让多数变更不必新建 schema 版本),但终极兜底永远是"写时 schema 可寻址"而不是"演进守规矩"。变式:流量更大的场景可以把指纹粒度从消息级上浮到批次级(一批同 schema 的消息共享一个头部),字节开销再降一档;而低价值日志族可以砍掉原始字节列与指纹(接受不可精确回溯),按数据分级差异化治理。
本节要点回顾
- 管道的根本差异:写入方与读取方永不见面,schema 可寻址性是第一问题;
- 两种姿势:JSON 信封是过渡或混合态,裸字节加注册表是治理正解;
- Avro 对决的判据:契约主战场在哪管道跟到哪,按数据源分治优于统一论;
- 数仓落地四点:映射声明化、原始字节列保回溯、未知枚举落 UNKNOWN 列、分区对齐 schema 版本;
- 终极兜底:兼容规则减少版本爆炸,"写时 schema 同飞归档"才是五年回溯的保证。
四份现场报告收笔。全册的发掘到此完整闭环:从第 1 章那桩抓包悬案出发,途经语言、字节、编译器、版本、元数据、性能、生态,最终回到四个真实现场——工具箱已经交到你手上,下一个发掘现场是你自己的系统。