1.4 数据模型:几何体即数据库
1.4 数据模型:几何体即数据库
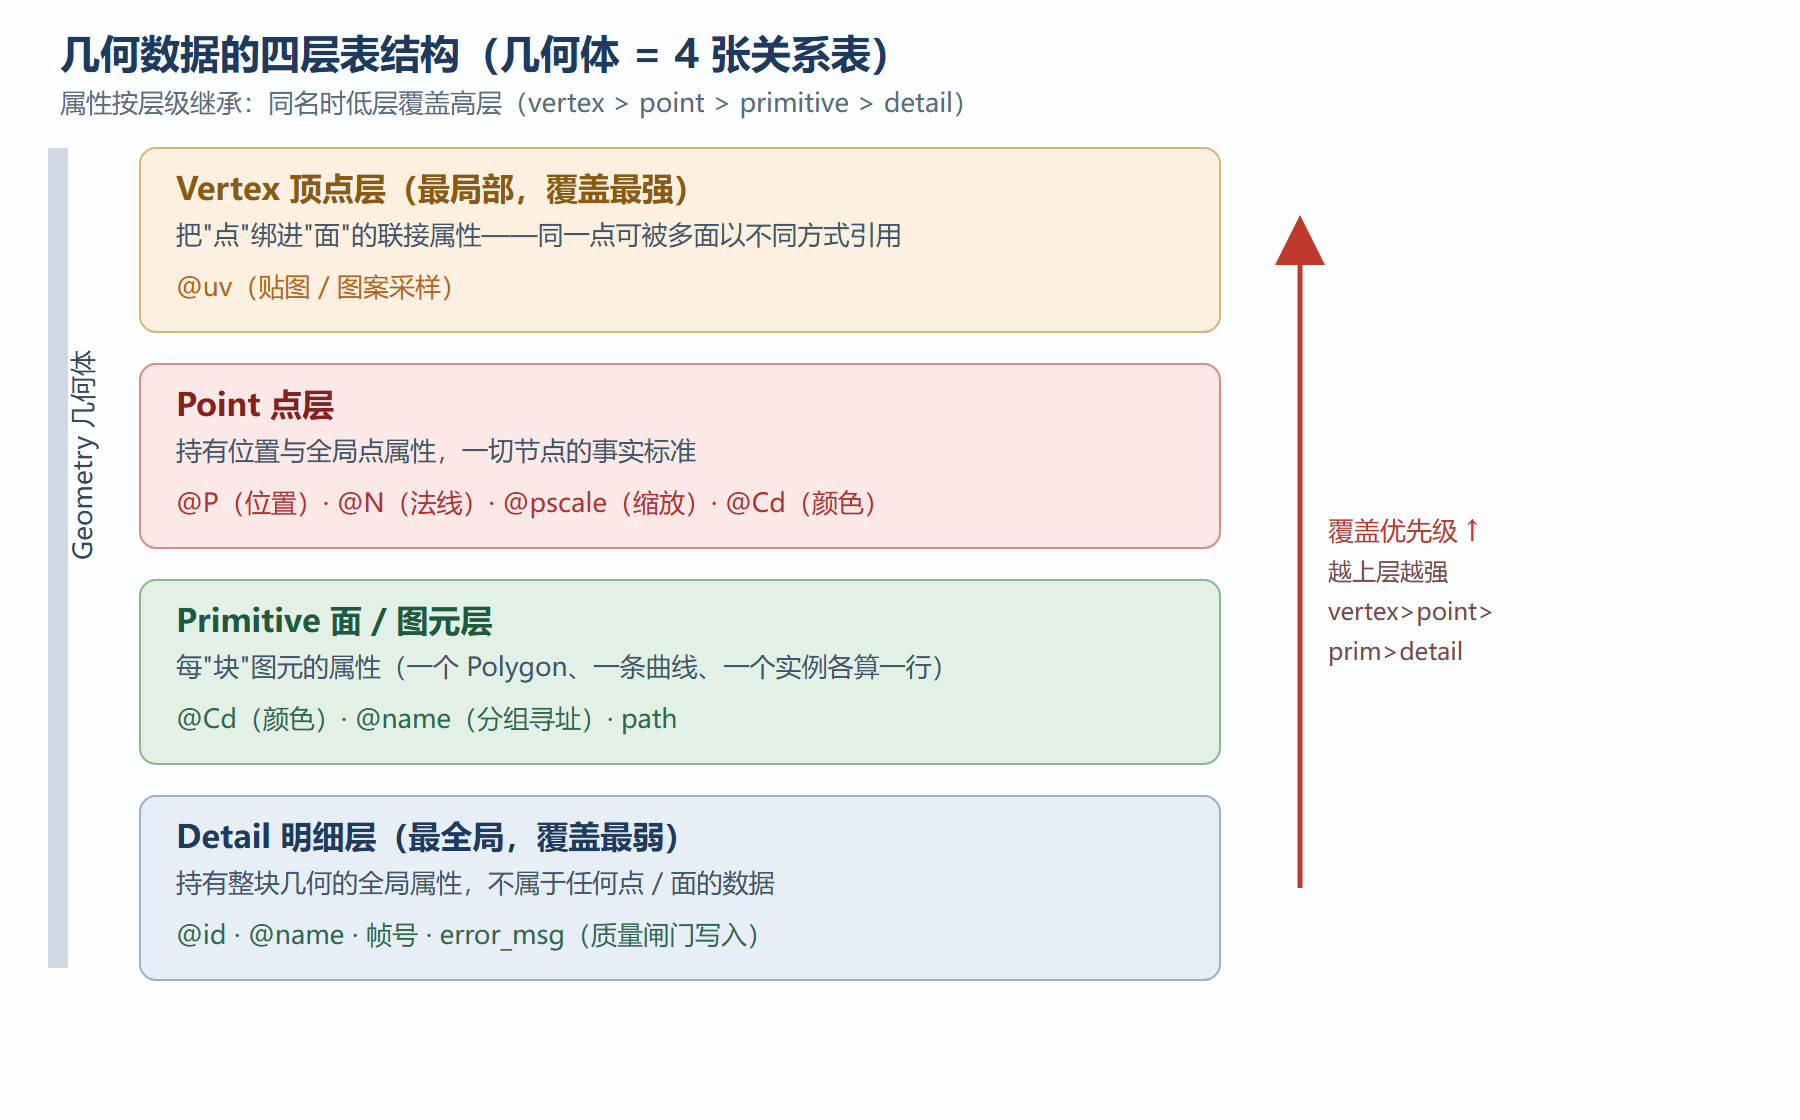
本节摘要:Houdini 几何体的本质是一组关系表:点表(Point)持有位置与属性,顶点表(Vertex)把点绑进面,面表(Primitive)持有整块面的属性。属性按层级继承(detail→primitive→point→vertex),组是命名选择集。看懂 Spreadsheet,第 2 章的 VEX 就是"对这张表写查询"。
实验:把山体拆成一张表
回到 Scatter 的输出,打开场景视图右上角的 Spreadsheet(表格图标)。你会看到几列:P(位置,xyz 三个分量)、ptnum(点编号),可能还有 Cd、pscale 之类。这张表就是山的全部——没有别的魔法。
再分别在 Grid 输出与 Scatter 输出处看一遍:行数从 1 万涨到 5000,说明 Scatter 重造了一张点表,不是往旧表上贴东西。
图 1.4-1 几何数据的四层表结构
图 1-4:几何数据的四层表结构
属性:几何的灵魂
形状只是属性的特例(P 也是一列)。真正让几何"活"起来的是你往表里加的列。做一个最小实验——给散布点加尺寸属性:
在 Scatter 后放一个 Attribute Wrangle(先别管语法,第 2 章细讲),Run Over 保持 Points,写入:
// 按高度给点分配随机缩放:山脚小、山顶大 float h = relbbox(0, @P).y; // 归一化高度 0~1 @pscale = fit(rand(@ptnum), 0, 1, 0.05, 0.1) * (0.5 + h);
再接 Copy to Points 复制一个小球,你会看到:山脚的球小而密、山顶的球大。你没有"摆放"任何一颗球——你只是给点表加了一列 pscale,Copy 节点读到它并遵守。下游节点消费上游写入的属性,这是 Houdini 数据模型的全部剧情。
常用系统属性速查
| 属性 | 所在层 | 谁消费它 |
|---|---|---|
| P | point | 一切节点的事实标准 |
| N | point/vertex | 法线计算、Copy 朝向 |
| Cd | point/primitive | 显示颜色、材质入口 |
| pscale | point | Copy to Points、实例化 |
| uv | vertex | 贴图、图案采样 |
| name | primitive | 分组寻址(模拟、材质常用) |
组:命名的选择集
Group 是给表的某些行贴标签。Blast、Facet 等大量节点都接受组名。它和属性是一体两面——组在底层就存为 0/1 属性。1.1 的实验里你在 Spreadsheet 看到的多余列,很可能就是 Scatter 写入的组。
⚠️ 常见坑:把"选择"用一次性的 UI 框选固化在节点上(每次上游变化选择就失效),而不是写成基于属性的规则(如坡度>30°)。程序化资产里,选择本身也必须是规则——第 3 章散布会大量用这条原则。
💡 关键直觉:把每个 SOP 想成一条 SQL——Mountain 是 UPDATE 点表 SET P=…;Scatter 是 CREATE 新点表。VEX 就是让你直接写这种 UPDATE 的笔。
本节要点回顾
- 四层表:Point / Vertex / Primitive / Detail,几何即数据库;
- P 也是属性:属性才是几何的核心资产,下游节点靠读属性决定行为;
- 属性继承:同名时低层覆盖高层(vertex > point > primitive > detail);
- 组=0/1 属性:选择要写成规则而不是 UI 框选;
- 看不懂网络时,先开 Spreadsheet 看表——它是万能调试器。
第 2 章开始学写"对这张表的查询与更新":VEX、VOPs、Python、HScript 四种笔各有所长。
延伸:用属性查询思维解决一个实际问题
把几何当数据库,意味着"查询"用 Wrangle 表达。任务:从散布了几千个实例的场景里,找出所有"坡度太陡或朝北"的实例位置。传统建模思路是肉眼挑,数据库思路是一条查询:
// Attribute Wrangle (Run Over: Points) —— 生态规则查询 vector up = {0,1,0}; float slope = degrees(acos(dot(v@N, up))); // 坡度角 int facing_north = v@N.z < -ch("north_thresh"); // 假设 -Z 为北 int reject = (slope > ch("max_slope")) || facing_north; i@eco_reject = reject; removepoint(0, @ptnum); // 仅在 reject 时: 改用 if 包裹
生态师只需改 max_slope 与 north_thresh 两个参数,植被分布即随规则重算——规则从"艺术家的手感"变成"可审计的参数",这正是几何体作为数据库的全部意义。
延伸:属性命名与版本的规范表
[团队属性字典(节选)] @id, @name — 实例标识(字符串型用 s@name) @P, @N, @uv — 内置, 勿挪用 f@density_@ — 业务: 密度采样值 s@layer_* — 业务: 分层标签, 全小写下划线 @tmp_* — 临时属性, 输出前必须 Clean 删除 规范: 新属性先登记字典再使用; 版本升级用 @v 前缀过渡 (@v2_height), 确认无下游读取后再删旧版
最后强调数据观迁移的检验方式:能否用"表"的语言描述你的场景。一条完整的岩石资产管线,本质上是一张岩石表(主键 name,字段 density/mass/fracture_level/...)加一套物化视图(SOP 输出、DOP 状态、USD prim)。下次 review 网络时,先在纸上把每个关键节点的输入输出写成表结构草稿——属性名、类型、语义、生产者、消费者五列。这个练习十五分钟一张,却是防止"属性沼泽"(命名随意、来源不明、消费未知)最有效的手段;多数大型程序化项目的失控,最初的症状都是属性沼泽,而非几何错误。
最后用一句话锚定本章在全书的地位:后续每一章的高级技术,拆到最底层都是对几何数据库的一次或几次查询与改写——植被是带生态权重的散布查询,城市是带约束的分割改写,动力学是带时间的状态迁移,PDG 是把查询本身变成可调度任务。把"几何即数据库"内化成思维默认值的人,学任何新节点都只需要问一个问题:"它读哪些属性、写哪些属性"——答案在手,节点即透明。这句话值得写在你的工位上。