8.2 工程化开发标准
8.2 工程化开发标准
本节摘要:程序化资产是给人用的程序,所以要按软件工程的纪律对待:网络分层有固定章法(输入整形 → 规则主体 → 输出打包)、命名可预测、参数有契约、变更走版本、行为可测试。本节给出一份可直接落地的最小规范,并把全书的山体主线按它整理收尾。
网络结构的章法
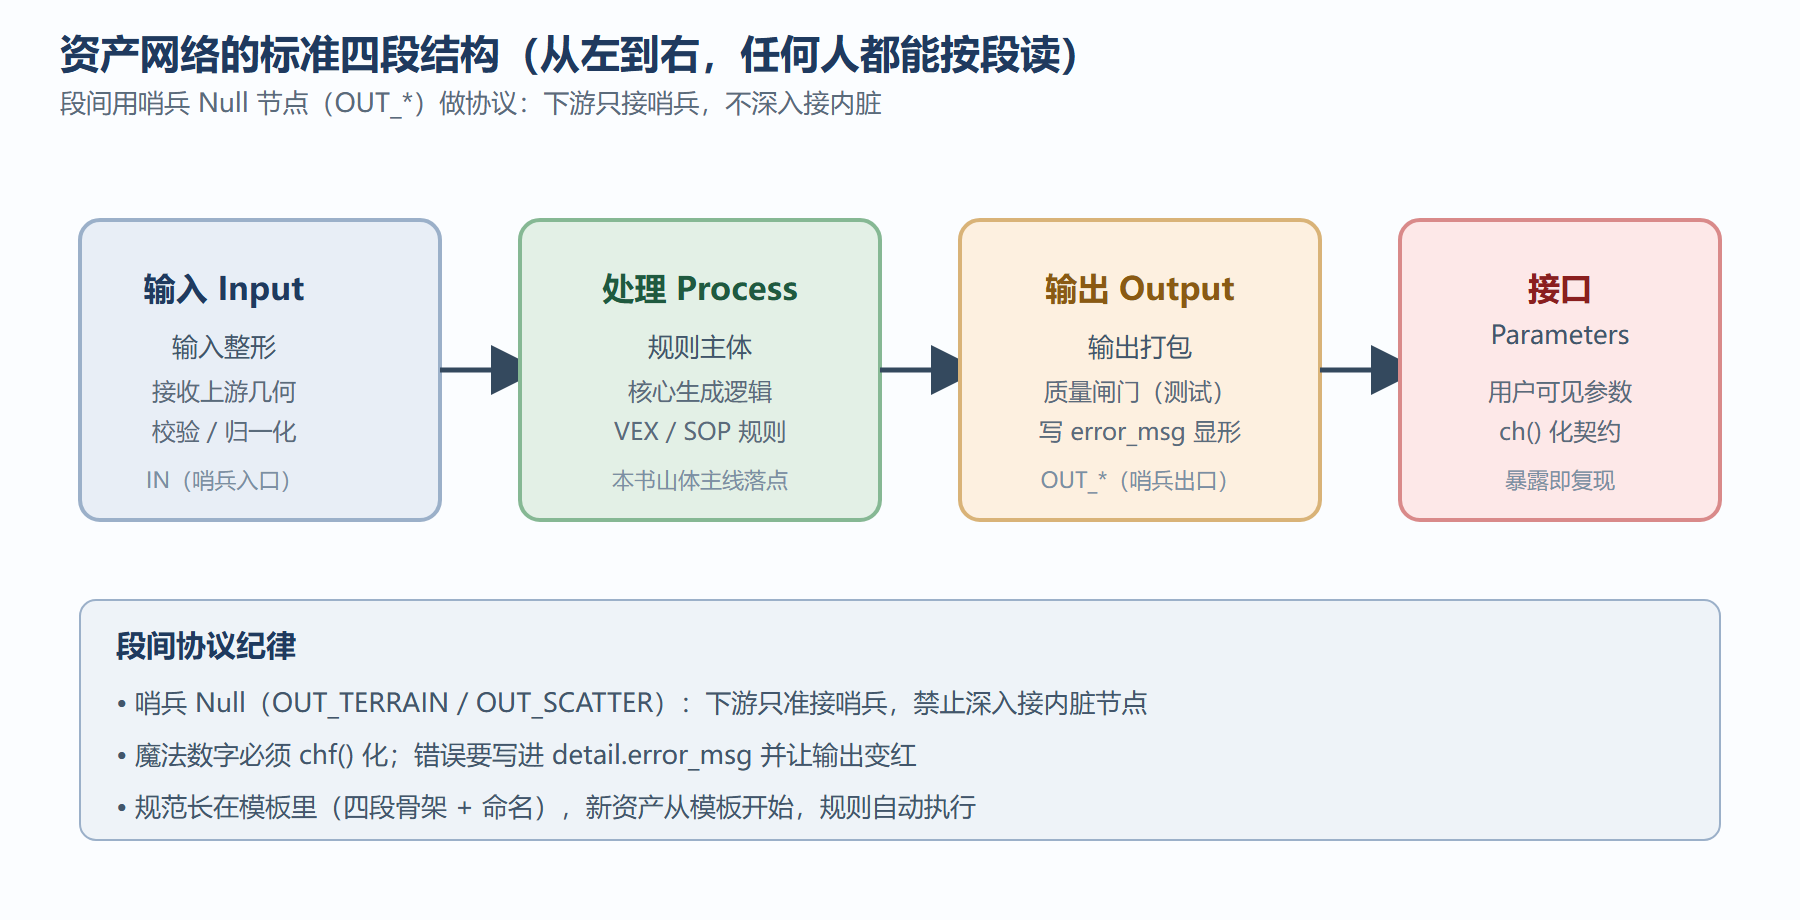
一个可维护的资产网络应该从左到右分四段,任何人打开都能按段读:
图 8.2-1 资产网络的标准四段结构
图 8-2:资产网络的标准四段结构
命名与契约
最低限度的一组约定(团队可增不可减):
- 属性全小写下划线:
rock_density而非rockDensity——VEX/Python/引擎三端引用一致性最好; - 段间哨兵:
OUT_TERRAIN、OUT_SCATTER命名的 Null 节点,下游只准接哨兵不准深入接内脏; - 魔法数字禁止裸奔:凡在 Wrangle 里写常数,必须
chf()化并给出命名——三个月后的自己就是第一个用户; - 错误要有声音:质量闸门段发现非数/越界,写进 detail 的
error_msg并让输出显示红——静默的坏数据会流到渲染农站在才发现。
测试:程序化资产的"单元测试"
不需要测试框架,两个习惯就够:
- 极端参数扫描:把关键参数拉到 min 与 max 各 cook 一次,不崩、不产出非数即过——6.2 产线天然能做这件事(Wedge 就是测试矩阵);
- 金样本对比:固定种子 cook 一版存为参照,重大改动后对比产物属性统计(点数、包围盒、平均 pscale)漂移是否在预期内。
版本与变更
沿用 7.1 的身份格式,加一条纪律:行为变更必须升版本并写变更说明(哪怕只是 HDA 描述字段里一行字)。回溯"这批山为什么长这样"时,版本号+种子号(元信息随数据流,7.1)就是全部答案。
⚠️ 常见坑:规范只写在文档里而不长在网络里。文档会失联,网络不会——把规则固化成模板资产(内含四段骨架与命名的空 hip/HDA),新资产从模板开始,规范就自动执行了。
💡 关键直觉:工程化的收益曲线是复利。第一个资产多花半天,第十个资产省下的是别人的整周。
本节要点回顾
- 四段结构:输入整形 / 规则主体 / 质量闸门 / 输出打包;
- 哨兵 Null + 属性命名约定是段间协议;
- 质量闸门=测试:错误要写进数据并显形;
- 极端扫描 + 金样本是廉价的测试组合;
- 规范长在模板里,不活在文档里。
主线资产至此既有形又有质。最后一章看向地平线:AI 与开放世界。
廕伸:程序化项目的仓库结构约定
工程化从文件组织开始,一个多人协作的程序化项目仓库标准结构,配合上一章的资产分层约定:
repo/ otls/ # HDA 库(版本化, 只增不改) hip/templates/ # 主场景模板(瘦场景, 全部引用资产) tools/shelf/ # Python 工具与 shelf tests/ # 回归场景: 指纹抽样(Solver章)+性能基线 docs/attrs.md # 全局属性字典(第二章字典的正式版) CI 动作: hython 无头跑 tests/ -> 几何指纹比对 + cook 时间 超阈值则阻塞合并 —— 程序化的"单元测试"
廕伸:代码评审的七问模板
[HDA/网络评审七问] 1. 参数名是否用户语言, 分组是否心智模型? 2. 属性是否登记字典, 命名是否规范? 3. 随机种子是否全部暴露且默认可复现? 4. 有无硬编码路径/版本/绝对参数(魔数)? 5. 错误输入(空几何/非法参数)是否优雅降级? 6. 重算范围是否最小(缓存友好)? 7. 有无对应测试场景进 tests/?
七问全部有答案的网络才可合入主干——评审的意义不是挑错,而是把团队的隐性经验固化为可执行的门槛;程序化工程化的终点,是让"做得对"比"做错了"更容易。
最后谈谈工程化的人文面:评审七问与仓库结构真正的敌人不是技术而是习惯。落地建议从"最小仪式"开始——只强制两条(属性必须登记字典、随机种子必须暴露),其余条款作为 checklist 供 review 时参考而非门槛;等团队尝到两次"因为字典而对上了属性"的甜头,再逐条升级为强制。工程标准的目标是降低而非提高协作成本,任何让成员绕道而行(先偷偷改完再补流程)的标准都是错的标准,发现绕道行为时正确的反应是修订标准而不是加强稽查。
再补一个工程化落地的度量建议:用三个数字季度性体检程序化仓库的健康度——资产复用率(HDA 被多于一个项目引用的比例)、评审通过率(一次过审的提交占比)、回归报警数(双闸每周触发次数)。三个数字分别衡量生态、流程与质量,趋势比绝对值重要。没有度量的工程化会退化为仪式,而仪式的终点是被废弃;三个轻量数字就能让标准保持活的压力,这是把第八章自我应用于第八章的示范。
最后给程序化团队的文档最小集,避免流程爱好者把工程化做成文山会海:一页属性字典、一页仓库结构图、一页评审七问、一份结题报告模板,四页足矣。所有更重的流程(需求单、变更单、会议纪要)只有在四页纪律失效的具体案例出现后才补——工程化的文档量与团队规模成正比但与信任存量成反比,先攒信任再上流程,顺序错了就会得到一个文档齐全但无人遵循的假工程化。
再补充新成员入职的工程化首课设计:入职第一周只做三件事——通读属性字典并默写十个核心属性、复现一次回归测试跑通双闸、给任一现有 HDA 提一个通过评审七问的改进 PR。三件事分别建立数据观、质量观与协作观的肌肉记忆,比读任何 wiki 都有效。工程文化的传承靠的是这套"入职即上手"的仪式,而非文档库存量;仪式存在的信号,是半年后新人开始给七问清单提修改案——那时标准就真正活了。
本节的最后落点是人的成长路径:程序化工程师的成熟阶梯大致三级——初级能建网络(技术维度)、中级能封装资产(接口维度)、高级能设计管线与标准(组织维度)。评审七问、仓库结构、入职三事都是第三级的工作产物;有意走完全程的读者,建议每年把"自己最满意的网络"按当年的新标准重做一遍,重做中暴露的差距就是下一年度的成长清单——这套自我迭代法与程序化本身的"非破坏、可回溯"完全同构,工程师本人也该是一条不断重构却从不推倒的管线。