9.1 AI 驱动的程序化生成
9.1 AI 驱动的程序化生成
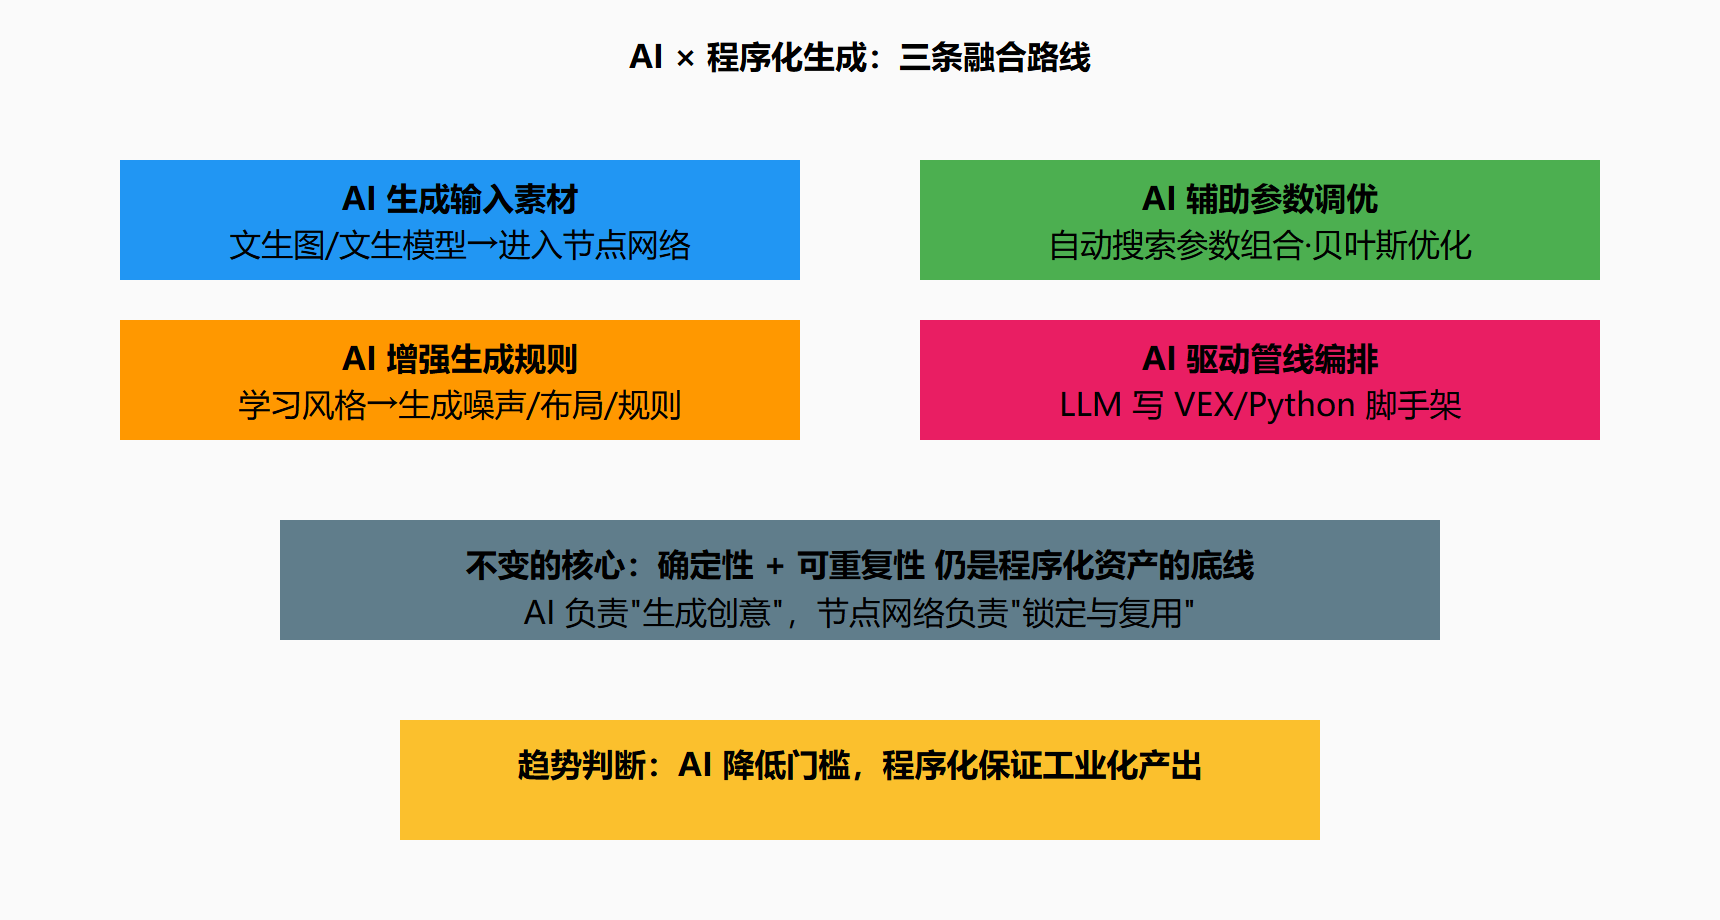
本节摘要:AI 不是程序化的替代者,而是管线里的新零件。它有三个稳定接入位:数据侧(生成高度图/纹理素材)、规则侧(从真实数据拟合分布规律,替代手调参数)、性能侧(学习代理模型,用神经网络替代昂贵计算)。可控性与可靠性决定每个位置该给模型多少话语权。
三个接入位
位置一:数据侧——素材的无限货架
扩散模型生成的贴图、参考图、高度图草稿,作为输入数据进入传统管线:AI 出一张山体概念图 → 转成高度场初稿(或作为 4.1 噪声层之外的参考约束)→ 后续侵蚀、掩码、散布照旧。特点是隔离性好——模型产物只是数据,坏了换一张,管线无感。
位置二:规则侧——从真实世界学分布
传统做法里"植被怎么长"是手写规则(坡度、海拔、簇状噪声——3.2 那套)。规则侧的 AI 用真实地理数据训练模型,让它学会"这种气候+这种坡度+这种土壤会长什么"。散布时查询模型而非查询手写公式:
传统:density = f(坡度, 海拔, 噪声) ← 手写,参数靠拍脑袋调 学习:density = model(坡度, 海拔, 湿度, 图像特征) ← 从真实生态数据拟合
价值在真实感的免费获得:手写规则逼近不了的生态相关性(阳坡与阴坡的树种差异、水系与植被的耦合),数据里本来就藏着。代价是不可解释——美术问"为什么这里没树",手写规则能答,模型只能说"数据如此"。
位置三:性能侧——学习的代理模型
第 5 章的模拟、4.1 的侵蚀都贵。性能侧的思路:离线算一万组输入输出对,训练网络模仿这个映射,运行时查询代理而非跑原算法。侵蚀代理、布料代理、人群行为代理都是这个模式——呼应 8.1 的思想:热点计算被"一次训练 + 无数次廉价查询"取代。
图 9.1-1 可控性光谱:AI 在管线中的话语权分配
人机分工的判断标准
三个问题决定一个环节要不要交给 AI:
- 错了谁发现? 素材错了美术一眼看出(可交);生态分布错了没人看得出但会觉得"假"(谨慎交);
- 要改多快? 导演喊改就要秒级响应的位置,模型推理+重跑若慢于调参数,就别交;
- 可复现吗? 6.2 的产线纪律要求同输入同输出——带随机性的生成模型接进产线必须固定种子与版本,否则"复现"破产。
⚠️ 常见坑:把 AI 产物直接当最终资产入产线,无版本无种子记录,三周后无法重出同样的结果。AI 输出也是数据,同样要过 8.2 的契约与溯源。
💡 关键直觉:程序化的本质是"人写规则";AI 的本质是"从数据里学规则"。融合点的最大价值是——人负责规则该长什么样的品味,模型负责规则里繁琐的数值。
本节要点回顾
- 三接入位:数据侧(隔离安全)、规则侧(真实但不可解释)、性能侧(代理替代贵计算);
- 话语权光谱:越近最终内容越收权,越近素材越放权;
- 三问分工:错了谁发现、改得多快、可否复现;
- AI 输出同样过契约:种子、版本、溯源一样不能少。
最后一节:当世界大到装不下——开放世界的规模之战。
廕伸:AI 与规则的三种接线法
当前 AI 与程序化的结合不是"取代规则"而是三种明确的接线方式,各有适用面:AI 做参数决策(分类器/回归器为 Wedge 挑选符合艺术方向的变体)、AI 做数据源(点云或图像生成结果作为 SOP 管线的输入几何)、AI 做评估器(用训练好的评分模型替代人工做变体质检)。第一种最实用:
# Wedge 之后接 Python TOP: 用轻量模型给变体打分排序 import numpy, joblib clf = joblib.load("art_dir.pkl") # 用美术标注的历史变体训练 for wi in upstream_items: feats = numpy.array([[wi.floatAttribValue("density"), wi.floatAttribValue("roughness"), wi.intAttribValue("seed") % 100]]) wi.setAttribute("score", float(clf.predict(feats)[0])) # 下游 Filter TOP 只 cook score 前 10% —— "艺术方向的自动初筛"
廕伸:神经代理与程序化的责任边界
[边界划分] AI 适合: 参数空间探索/风格评分/纹理类高频细节 规则适合: 拓扑正确性/工程约束(路网不交叉)/可微调再编辑 混合律: AI 的输出必须通过规则层的"校验关卡"(如碰撞检查) 才允许进入下游 —— 可控性由规则兜底, 新鲜感由 AI 供给 失败模式: 把拓扑级结构交给端到端模型且无校验 => 不可修复的"看起来像"资产
再给一个冷静的观察作为本节收束:生成式 AI 与程序化的真正分歧点在"错误的类型"。规则系统的错误是可定位的(哪个节点哪个参数),修复是精确的;端到端模型的错误是统计性的(整体感觉不对),修复只能靠重掷或微调。这个差异决定了两者在管线里的位置——越是下游、越接近最终交付的环节越需要规则的可控性,越是上游、越接近灵感探索的环节越用
再给一条判断 AI 工具成熟度的采购者视角:问厂商三个问题——种子可复现吗(同种子同输出)、输出可编辑吗(拓扑与属性而非烘焙网格)、管线可组合吗(能进 TOP 与 USD 而非孤岛软件)。三问皆能者才值得进入生产管线,否则只配在预览阶段使用。这套问法本质上是把本书八章的工程标准压缩成采购清单——程序化的护城河不在拒绝新工具,而在有一套让任何工具安全进场的安检流程。
收束本节也收束技术部分:AI 的入场没有改写本书的任何一章,只是为每章增加了一个新变量——第一章的数据观用于审计 AI 输出的属性完整性,第二章的语言栈用于包装模型调用,第六章的调度用于模型批量推理,第八章的双闸用于验收生成质量。能这样逐章落位的团队,AI 是杠杆;无处落位的团队,AI 是玩具与焦虑。这大概是"AI 驱动的程序化"最诚实的一句话:驱动它的从来不是 AI,是工程。