02-网络服务器:去重、下行调度与网关选择
7.2 网络服务器:去重、下行调度与网关选择
本节摘要:网络服务器是 LoRaWAN 的大脑:同一上行可能被多个网关同时收到,NS 要负责去重;下行要调度到正确的网关;还要管理设备会话与 ADR。本节讲清这三个核心逻辑。位置:7.1 讲了网关转发,本节讲接收端如何把多路转发改造成一条可靠数据流。
去重:同一包,一次处理
一个设备的上行可能被多个网关同时接收(覆盖重叠)。NS 的去重逻辑:
1. 以 (DevAddr, FCnt) 为去重键 2. 第一条到达的处理,其余丢弃(或用接收质量最好的那条) 3. 去重窗口要大于网关间网络延迟差,否则"晚到的重复包"被当成新包
去重的依据是帧计数:正常上行每帧计数递增,重复包计数相同即判重。实现要点:去重表要按时间过期(设备 1 天不上行,旧记录清除);多网关并发上报时去重逻辑要并发安全。
下行调度:谁来发、什么时候发
设备只在接收窗口监听,NS 必须:选择网关(通常选最近上报该设备上行的网关,信号最好)→ 确定发送时刻(RX1 窗口 = 网关收到上行 + 传播补偿 + RX1 延迟)→ 向网关下发定时指令。调度错误的表现:下行总是慢半拍(错过窗口)或从错误的网关发出(设备听不见)。
网关选择的质量因子:RSSI/SNR(谁收得最好)、到达时间(谁最先到,网络最短)、网关负载(避开拥挤网关)。成熟 NS(ChirpStack、TTN)按"最近上行网关 + 质量分"综合决策。
会话与状态管理
NS 要为每个设备维护:会话密钥(NwkSKey/AppSKey)、帧计数(上行下行各一套,4.3 的同步算法)、ADR 状态(当前 DR/功率/窗口数据)、区域配置(信道表)。设备量级上来后,会话表、去重表、下行队列的内存与数据库设计要跟上——百万设备级的 NS 需要分片与缓存策略。
易错点清单
- 去重键用错:只用 DevAddr 不用 FCnt,同地址设备(入网后地址复用)会互相误判;
- 下行窗口计算漏传播时间:网关到 NS 的往返延迟要补偿,否则下行永远晚半个窗口;
- 网关离线状态不剔除:选网关时把离线网关算进去,下行石沉大海,要维护网关健康度;
- 会话过期策略缺失:设备长期不上行,NS 的会话要按策略过期并通知应用侧,否则出现"设备已重入网、NS 还在用旧会话"。
要点回顾:NS 用 (DevAddr, FCnt) 去重;下行按"选网关 + 定时刻 + 下发"三步调度;会话、计数、ADR 状态按设备维护。下一节把数据交到应用手里——北向集成的最后一公里。
网络服务器的扩展性设计
设备量级从千级到百万级,NS 的扩展性设计要在架构期就定:无状态网关连接(网关连接可横向扩容)、会话分片(按设备 ID 哈希分片存储会话与计数)、去重表淘汰策略(TTL + 容量上限)、下行队列异步化(发下行不阻塞处理上行)。ChirpStack 等开源 NS 提供了参考,但百万级还是要自研分片与缓存。
扩展性检查清单: - 网关连接数:单 NS 实例能扛多少并发连接? - 会话查询:按 DevAddr 的查询延迟是否随设备数线性增长? - 去重并发:同一设备多网关同时上报时,去重是否并发安全? - 下行调度:高峰期下行队列是否堆积,调度延迟是否超标?
多租户与隔离
SaaS 化的 NS 要支持多租户(多应用/多组织):数据隔离(租户只能看到自己的设备与数据)、配额管理(每租户的设备数、消息数上限)、审计日志(每租户的操作留痕)。隔离的实现要贯彻到数据库层(租户字段 + 查询强制过滤)与 API 层(租户令牌鉴权),不能只靠"约定"。
易错点补充
- 去重窗口与网络延迟不匹配:网关分布广(跨机房)时去重窗口要放大,否则重复包被当新包处理;
- 会话存储与计数更新的事务性:计数更新失败会回退,导致合法帧被误判重放,更新要原子化;
- 多租户漏过滤:一个租户的查询没带租户条件,就会串数据,SQL 层要强制租户条件而不是靠上层自觉。
关键实现清单
- 去重键用 (DevAddr, FCnt) 且按时间过期
- 下行调度 = 选网关 + 定时刻 + 下发,补偿传播时延
- 网关选择按最近上行 + 质量分,剔除离线网关
- 会话/计数/ADR 状态按设备持久化,计数更新原子化
典型故障与处置
| 现象 | 原因 | 处置 |
|---|---|---|
| 同一上行重复处理 | 去重窗口小于网关间延迟差 | 放大窗口或统一时钟 |
| 下行总是错过 | RX 时刻计算漏传播补偿 | 核对网关往返时延补偿 |
| 设备失联但网关正常 | 会话过期或计数同步失败 | 重入网或按窗口重建计数 |
小结
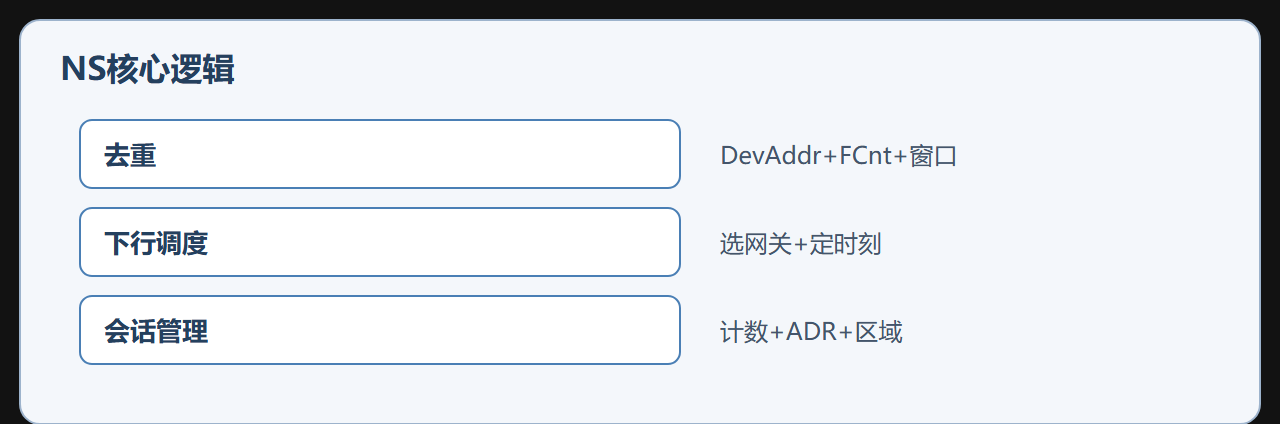
小结:NS的三个核心逻辑——去重(DevAddr+FCnt,窗口过期)、下行调度(选网关+定时刻+补偿传播时延)、会话管理(计数原子更新、过期策略)。上线前建议用模拟网关脚本压一遍:并发100台设备的去重正确性、下行队列在高峰期的延迟,这两个点最容易在真实流量下暴露问题。
开源 NS 对比速览
| 方案 | 定位 | 优势 | 注意 |
|---|---|---|---|
| ChirpStack | 自托管主流 | 组件齐全、文档好 | 需自己运维数据库与消息队列 |
| TTN | 公有云 | 零运维、生态大 | 数据不出国的场景不适用 |
| 自研 | 定制需求 | 完全可控 | 成本高,仅大规模才划算 |
中小规模(千级设备)用 ChirpStack 自托管是性价比最高的起点。
NS 上线前的自检清单
功能自检:用模拟网关脚本验证——同一上行被两个网关上报时去重正确(只处理一次);下行按 RX1/RX2 时刻发出(网关日志核对时间戳);设备离线后下行不落队列(或标记失败)。容量自检:并发 500 台设备模拟上行,观察去重表内存、队列积压与响应延迟。安全自检:无凭证的连接被拒绝、越权主题订阅被拒绝、下行接口的鉴权生效。三项自检通过后再接真实设备,能少踩一半现场坑。
补充一句:NS 的核心指标是"下行成功率"与"去重后上行成功率",两个指标分别反映下行调度质量与上行处理质量,运维看板应同时展示,任何一项下滑都要按本章的排错路径定位。