03-应用层语义化与DLMS的兼容账
9.3 应用层语义化与 DLMS 的兼容账
本节摘要:LoRaWAN 传的是字节,业务系统要的是语义。本节讲应用层序列化方案(编解码器)与智能表计场景的 DLMS/COSEM 兼容思路。位置:9.2 扩展了物理边界,本节扩展"协议到业务"的边界。
应用层语义化的两种路线
| 路线 | 原理 | 适用 | 注意 |
|---|---|---|---|
| 编解码器(Decoder) | NS/应用侧写解析函数,把字节翻译成 JSON 字段 | 自定义设备、小型业务 | 版本管理要跟上固件 |
| 标准对象模型(DLMS/COSEM) | 用标准化的对象模型表达计量数据 | 智能电表、多厂商互通 | 开销大,需适配层 |
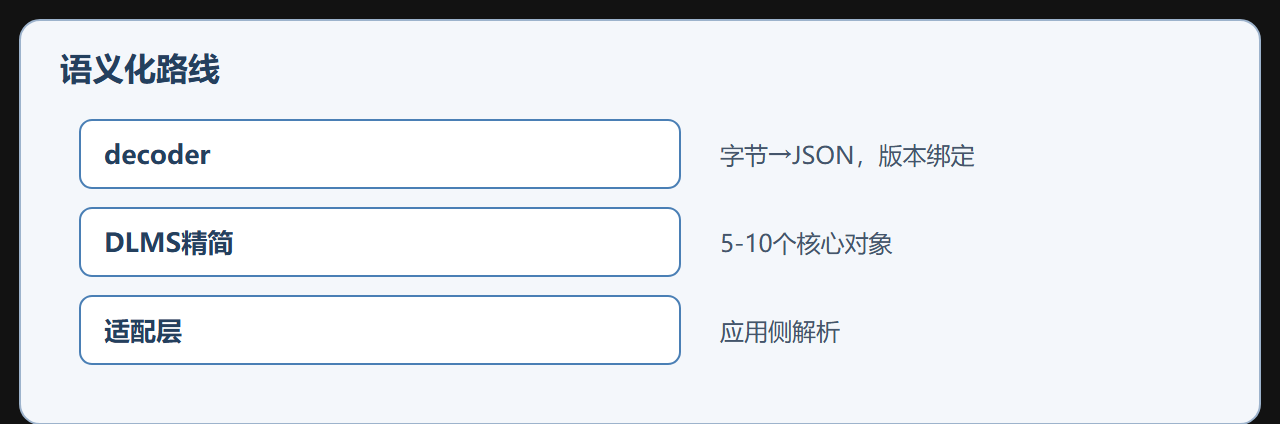
编解码器路线是 LoRaWAN 社区默认做法:设备按约定格式打包字节(如"2 字节水位 + 1 字节电压 + 1 字节状态"),应用侧写 decoder 还原成语义字段。版本管理是最大的坑——设备固件升级改变字节布局后,旧 decoder 解析新报文会出错,decoder 要带版本号并与设备固件版本对应。
DLMS/COSEM 的兼容账
智能电表行业用 DLMS/COSEM 标准表达计量对象。LoRaWAN 与 DLMS 的兼容思路是适配层:把 DLMS 的报文封装进 LoRaWAN 的 FRMPayload,或用"精简 DLMS"(只承载关键计量对象)。开销分析:
DLMS 完整报文(几十~几百字节)在 SF7 下可能超净荷上限 → 需分帧或精简对象集 → 或用低速档(SF10/12)换净荷上限,但空中时间翻倍
工程结论:能精简就精简,DLMS 完整协议栈跑在 LoRaWAN 上不划算;多数表计场景用"计量对象映射"(读表号、电量、状态几个关键对象),把复杂度留在应用侧。
易错点清单
- decoder 不版本化:固件升级后旧 decoder 解析错位,字段全乱,必须 decoder 与固件版本强绑定;
- 把 DLMS 当字节流直传:DLMS 报文在 LoRaWAN 净荷限制下要分帧/精简,直传会频繁超限;
- 忽略字节序与浮点编码:跨厂商解析错误多半来自字节序(大端/小端)与浮点表示不一致,编解码规范要写死;
- 应用侧解密与解码职责不清:先解密(AppSKey)再解码(decoder),两个环节的密钥与版本要分别管理。
要点回顾:应用层语义化靠编解码器或标准对象模型;decoder 版本化是长期运维的关键;DLMS 走适配与精简路线。全册至此收官:从链路预算出发,物理、MAC、网络、应用四层逐层落地,再到测试部署与边界扩展,一本账算到底。
编解码器的版本治理
decoder 的版本治理是长期运维的必修课:decoder 与固件版本映射表(哪个固件版本对应哪个 decoder 版本)、向后兼容(旧 decoder 至少能解析新报文的基础字段)、灰度上线(decoder 更新先在小范围验证再全量)。最坏情况是"设备已经升级、decoder 还没同步",这段时间所有新报文解析失败或错位——升级顺序应该是先上 decoder 后上设备固件。
decoder 版本管理示意: decoder_v3 → 兼容固件 v2.x 与 v3.x(解析新字段,旧字段保持) 固件升级流程:先部署 decoder_v3 → 再灰度升级设备固件 → 观察解析正确率
DLMS 适配的落地路径
表计场景接 DLMS 的落地路径:第一,梳理对象集——列出业务真正需要的计量对象(当前电量、累计电量、表状态、时间),通常 5–10 个对象足够;第二,做精简映射——把 DLMS 对象编码成 LoRaWAN 友好格式(压缩、按需请求);第三,协议栈分层——LoRaWAN 传字节,DLMS 语义在应用侧解析,两端解耦。不建议在设备上跑完整 DLMS 协议栈——开销大且与 LoRaWAN 的净荷限制冲突,精简映射是主流。
易错点补充
- decoder 与固件版本脱钩:没有版本映射表,出问题无法定位是哪一端的问题;
- 精简映射丢字段:映射时漏掉关键对象(如事件时间戳),后续补字段要重新规划报文格式;
- 把 DLMS 对象硬编码进设备:设备侧的 DLMS 支持应是可配置的(哪些对象上报、多久一次),写死会导致业务调整要换固件。
关键实现清单
- decoder 与固件版本映射表强绑定,先上 decoder 后升固件
- 字节序与浮点编码在规范中写死,跨厂商一致
- DLMS 走精简映射(5–10 个对象),不跑完整协议栈
- 先解密(AppSKey)再解码(decoder),两端分别管理
典型故障与处置
| 现象 | 原因 | 处置 |
|---|---|---|
| 升级后解析错位 | decoder 与固件版本脱钩 | 核对版本映射并灰度 |
| 跨厂商解析失败 | 字节序或编码不一致 | 统一大端并文档化 |
| 报文超净荷上限 | DLMS 完整报文直传 | 精简对象或分帧 |
语义化架构的演进路径
应用层语义化不必一步到位,可以按规模演进:第一阶段,硬编码协议——设备与解析逻辑一一对应,适合几十台设备的小系统;第二阶段,decoder 插件化——每种设备一个 decoder 文件,按设备型号加载,适合百级设备、多型号场景;第三阶段,标准对象模型——DLMS 等标准语义,适合千级设备、多厂商互通、监管要求统一的行业(表计、能源)。
| 阶段 | 规模 | 架构 | 切换时机 |
|---|---|---|---|
| 硬编码 | < 50 台 | 写死在代码 | 出现第二类设备时 |
| decoder 插件 | 百级 | 按型号加载 | decoder 版本管理成为负担时 |
| 标准模型 | 千级 | DLMS/COSEM | 多厂商互通或监管要求时 |
演进原则:不要一开始就上第三阶段(成本高),也不要在第二阶段的规模还硬编码(维护爆炸);按设备数与异构程度推进,每阶段留好接口。
数据质量与业务闭环
语义化的终点是业务可用:数据校验(范围、单位、连续性检查)、异常告警(超阈值、缺失、跳变)、业务动作(上报、联动、指令下发)。建议在应用侧加一道"数据质量层":原始报文、解码结果、质量标记三列存档,业务消费质量标记——"这条数据可信吗"由质量层回答,业务层只管用。这样即使 decoder 有 bug 或设备异常,业务也不会被脏数据带偏。