2.2 空间信道建模统计与几何两条路
2.2 空间信道建模:统计与几何两条路
本节摘要:容量公式需要"真实的 H"才能算出有意义的数字,而真实 H 只能靠建模。信道模型有两条路线:统计派用相关矩阵把信道压成几个数字,快但失真;几何派用散射簇参数把环境还原成可测量的几何结构,真实但繁琐。本节讲清两条路的取舍,介绍 3GPP 38.901 的 UMi / UMa / RMa 三类场景,以及角度扩展、时延扩展、功率延迟谱这些参数到底是从哪台仪器测出来的,最后说明模型怎么被用进仿真与标准。
核心问题
阅读完本节,你应当能够:
- 区分相关矩阵模型(统计派)与几何随机模型(散射簇派)各自的输入、输出与失真来源
- 说出 3GPP 38.901 中 UMi、UMa、RMa 三类场景分别刻画什么传播环境
- 解释角度扩展、时延扩展、功率延迟谱、到达角与离开角这些参数如何从信道探测仪得到
- 说明为什么纯独立同分布瑞利模型被称为"统计幻觉",以及在什么场景下它仍然够用
- 判断一项仿真该用统计模型还是几何模型,依据是什么
一、为什么需要模型,而不只是公式
上一节我们假设 H 是独立同分布瑞利矩阵——每个元素都是零均值复高斯变量。这个假设让公式优雅、可解,但它在物理上几乎不成立:天线间距小于半波长就强相关,城市街道会天然把信号限制在某个角度范围内形成"信道簇",室内更是强非平稳。
模型存在的意义,是在保真度与可用性之间找平衡:既要够贴近真实传播,又要够简单能被仿真和标准化复用。这就是两条路线的分野。
二、统计派:相关矩阵模型
统计派不关心信号从哪面墙反射,只关心"天线之间有多相关、整体能量多大"。它把信道压缩成几个统计量:路径损耗、阴影衰落、以及最关键的天线相关矩阵 R。
H = R_rx^{1/2} · H_w · R_tx^{1/2}
其中 H_w 是白噪声矩阵,R_rx、R_tx 是接收与发射端的相关矩阵。只要知道这几个矩阵,就能生成一大堆符合统计特性的 H,计算极快。
优点是轻量、可解析、适合做理论推导;缺点是丢掉了所有几何成因——它告诉你"相关性是多少",却不告诉你"为什么是这个角度"。在天线相关性主导、细节不重要的场景(比如早期容量研究)够用,但一旦要仿真波束赋形或大规模阵列,它就失真严重。
统计模型并非一无是处。在只需要回答"上界大概在哪"的理论研究里,它快得无可替代:一行相关矩阵就能生成上万次信道实现,做蒙特卡洛平均。它的失效边界也很清楚——只要问题涉及方向(波束指向、到达角分布、阵列几何),就必须换几何模型。一个实用的经验法则是:凡是要算"空间"二字的地方,统计模型就不够;凡是只关心"统计特性"的地方,几何模型的繁琐就是浪费。这也是为什么同一篇论文里常出现两种模型混用:上界推导用统计,波束仿真用几何,各取所长。
三、几何派:散射簇模型与 3GPP 38.901
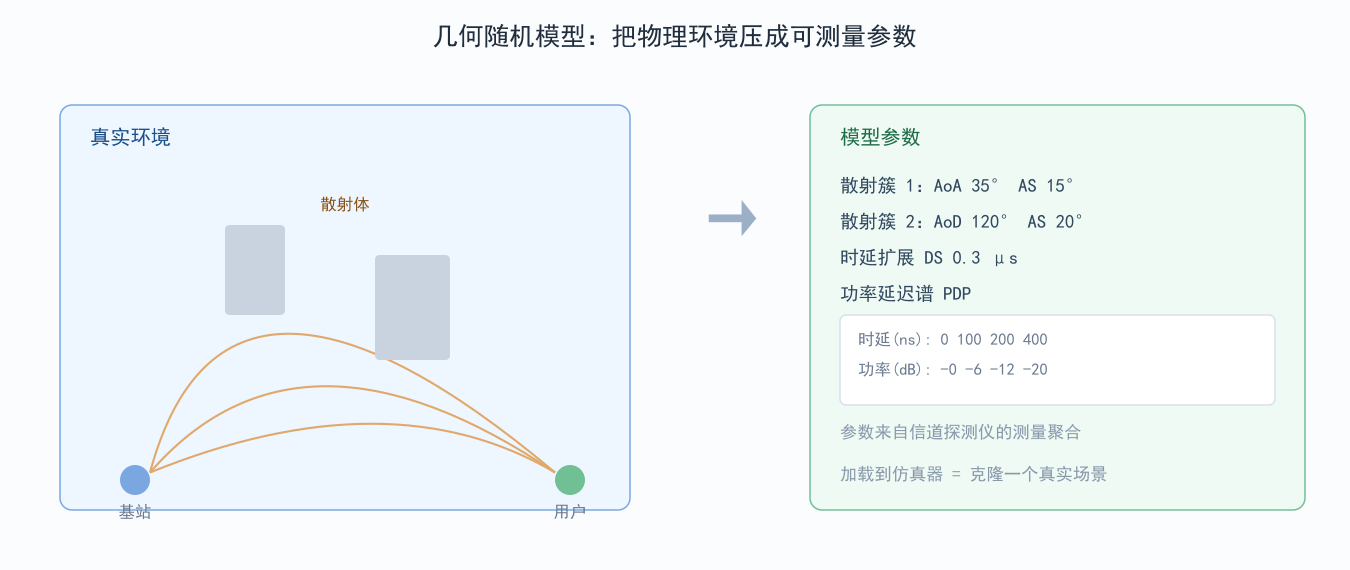
几何派反过来:它把环境抽象成有限个"散射簇",每个簇有中心到达角、中心离开角、角度扩展、时延、簇内功率。信号在簇之间反弹,由此算出每条路径的幅度和相位。
3GPP TR 38.901 是这套思想的集大成者,按环境分成三类场景:
| 场景 | 全称 | 典型环境 | 关注点 |
|---|---|---|---|
| UMi | Urban Micro | 城市微蜂窝,基站低、街道峡谷 | 街道波导、人体遮挡 |
| UMa | Urban Macro | 城市宏站,基站高、楼顶以上 | 高层衍射、大尺度衰落 |
| RMa | Rural Macro | 农村宏站,开阔、稀疏散射 | 长距离路径损耗、稀疏多径 |
模型参数都来自真实测量仪器——信道探测仪(Channel Sounder)。它发一串已知序列,在接收端解出发射到接收的所有多径分量,从而测出每条路径的到达角、离开角、时延和功率。把这些聚合成角度扩展、时延扩展、功率延迟谱,就得到可复现、可标准化的模型参数。工程师在仿真平台里加载 UMi 参数,等于"克隆"了一个真实的城市微蜂窝。
图 2-2:几何派把环境抽象成散射簇
四、三代模型的演进
建模本身也经历了三次转向:
- 理论阶段(1990s–2000s 初):纯独立同分布瑞利,成就了大量理论,但被称为"统计幻觉"——它隐含"任意两根天线完全不相关、散射无限丰富",现实中几乎不成立。
- 经验主义矫正(2000s 中–2010s):WiMAX 论坛、欧洲 COST273 项目大规模实测,催生几何随机模型,3GPP 25.996(LTE)与 38.901(5G)是集大成者,以"可测量、可复现、可标准化"为最高准则。
- 机理融合(2020s–今):射线追踪给出厘米级确定性响应但算力昂贵;物理信息神经网络把麦克斯韦方程作为软约束;混合模型以 SCM 为骨架、射线追踪为肌肉、AI 为代理,兼顾保真度与效率。
五、模型怎么进仿真与标准
理解了两条路线,还要知道它们怎么被用。标准化的信道模型(如 38.901)是"公共语言":芯片厂商、基站厂商、运营商都用同一套参数做链路级和系统级仿真,这样不同家的设备才能在同一基准上比性能。统计模型则常驻在理论论文和快速原型里,用来推导闭式上界。
一个容易忽略的点:模型参数本身会随频段剧烈变化。毫米波频段波长变短,散射体相对尺寸变大,角度扩展往往更窄、信道更稀疏,所以 38.901 对 FR2(毫米波)单独给出参数。用错了频段参数,仿真结论会系统性偏离真实部署。
建模还有一类"看不见的误差"值得单列。其一是簇数量与功率分配的过简化:标准模型给的是典型统计均值,但某次具体实测可能多一个强反射簇,模型没捕捉到,结果仿真里没出现的强干扰在现网里出现了。其二是非平稳性:用户在街道里走几步,散射环境就换了一茬,而静态模型假设观测窗口内平稳,用它做长时间平均会掩盖瞬态。其三是材料参数的缺失:玻璃幕墙的菲涅尔反射、人体组织的吸收,都不是几个角度扩展能概括的,这正是射线追踪和混合模型要补的空白。所以模型再标准,结论也要回到实测去标定——模型是地图,不是领土本身。
选择错误的模型代价很直接。用统计相关矩阵去做大规模阵列仿真,会系统性高估可复用自由度,因为矩阵里根本没有角度信息,波束赋形依赖的方向结构被抹平了,仿真里跑出 8 流,现网可能只有 3 流。反过来,用几何模型去做纯理论上界推导,又会被繁复参数拖垮,失去闭式可解性。取舍的关键永远是:我这一刻要回答什么问题——要上界用统计,要方向用几何,要具体楼宇用射线追踪。把问题想清楚,模型自然选对。
六、怎么选
没有"更好"的模型,只有"更合适"的模型:
- 做容量理论上界、要可解析推导 → 统计相关矩阵模型,快。
- 做波束赋形、大规模阵列、协议仿真 → 必须用几何随机模型(38.901),否则方向信息全丢。
- 做具体楼宇的确定性预测 → 射线追踪或混合模型。
牢记这条边界,能少走很多弯路:用错模型不会报错,只会在结论里悄悄埋雷。统计模型算出的"满秩高容量"在几何模型里可能塌成"秩二低容量",差异不是算法 bug,而是模型假设本身不同。选型前先问一句"我要回答什么问题",答案自然浮现。选型没有银弹,只有权衡;把问题写清楚,模型自己会浮现,反过来先定模型再去套问题,往往得到漂亮却偏离现实的结论。
⚠️ 常见坑:拿独立同分布瑞利模型去做大规模天线阵列仿真。阵列波束赋形高度依赖角度结构和相关性,而 iid 模型假设所有方向独立、所有天线不相关——它恰好把波束赋形依赖的那部分信息抹掉了,结果自然失真。
💡 关键直觉:模型的"真实度"不是越高越好,而是够用就好。一套能复现目标现象、又能被标准化复用的模型,胜过一套物理精确但谁也无法复现的"完美"模型。38.901 的精髓就在"可测量、可复现"这六个字。
七、常见疑问
角度扩展、时延扩展这些参数有什么用?
它们是连接理论和实测的桥梁。角度扩展决定空间自由度能拉多高(角度越铺开,天线越容易看到独立方向);时延扩展决定频率选择性(扩得越宽,均衡和循环前缀越重要)。仿真器加载这些参数,等于把"某栋写字楼玻璃幕墙怎么反射"翻译成了"一组可计算的统计"。
为什么农村场景 RMa 也单独建模?
农村散射体稀疏,多径少而路径损耗主导,信道更接近视距、秩更低。如果用城市模型去仿农村,会高估可复用自由度、低估覆盖距离。场景分类的本质是"让仿真的信道统计和真实部署环境对齐"。
AI 会取代几何模型吗?
短期不会。当前最优实践是混合:用 SCM 提供物理可解释的骨架,用神经网络学习参数随环境动态演化的规律。把麦克斯韦方程作为神经网络的软约束(物理信息神经网络),性能提升的根源正是"几何结构被显式嵌入"。AI 是代理,不是替代。
本章回顾
- 两条路线:统计派(相关矩阵,快但失真)与几何派(散射簇,真实但繁琐)
- 统计派公式 H = R_rx^½ · H_w · R_tx^½,丢弃几何成因只留相关性
- 38.901 三类场景:UMi 城市微蜂窝、UMa 城市宏站、RMa 农村宏站,各有侧重
- 参数来自探测仪:到达角、离开角、角度扩展、时延扩展、功率延迟谱由 Channel Sounder 测量聚合
- 三代演进:理论 iid → 测量驱动 SCM → 物理+AI+几何融合
- 模型是公共语言:标准模型让不同厂商在同一基准比性能,频段参数不可混用
- 选型原则:理论上界用统计、波束阵列用几何、具体楼宇用射线追踪或混合
- iid 瑞利是统计幻觉:做大规模阵列仿真会抹掉角度信息,结果失真
- 模型够用就好:38.901 的精髓是"可测量、可复现"
下一节把"矩阵"这件事彻底拆开:SVD、特征值、秩到底在物理上对应什么,为什么看到一组测量就能反推信道结构。