4.1 顺序与并行推理模式
4.1 顺序与并行推理模式
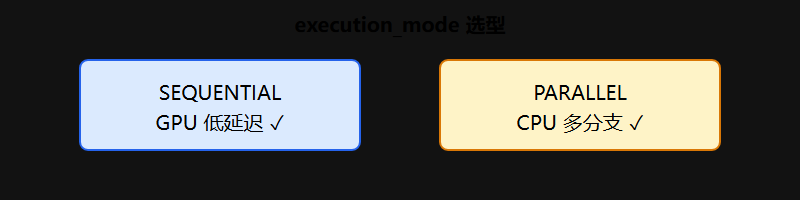
本节摘要:ORT 支持 SEQUENTIAL(默认)与 PARALLEL 两种 execution_mode:前者按拓扑序一次跑一个节点;后者无依赖节点可并行。GPU 为主时 PARALLEL 收益有限,CPU 大模型多分支时可能提升吞吐。
把 execution_mode 调成 PARALLEL 后更慢了
服务端要 QPS,把 execution_mode 设为 PARALLEL 后延迟反而升高——因为 GPU 单 stream 上并行 launch 增加同步开销。这个案例说明 execution_mode 不是"开了就快"的开关,它改变的是算子间的调度策略,而收益取决于图的拓扑与 EP 的类型。先量后调:Profile 看是算子间还是算子内瓶颈,再决定要不要动 mode。
两个概念先分清:算子间并行(inter-op parallelism)指无依赖的多个节点同时跑,由 execution_mode 与 inter_op 线程数控制;算子内并行(intra-op parallelism)指单个算子(如一个大 MatMul)内部被切块并行,由 intra_op 线程数与 EP 的 kernel 决定。前者是调度问题,后者是计算问题,混为一谈是调参翻车的第一来源。
两种模式的机制
| 模式 | 行为 | 适用 |
|---|---|---|
| SEQUENTIAL | 拓扑序单线程调度节点 | GPU 推理、低延迟 |
| PARALLEL | 无依赖节点并行 | CPU、多分支图 |
SEQUENTIAL 下节点严格按拓扑序逐个执行,调度开销最小、行为最可预测。PARALLEL 下调度器把无依赖的节点丢给多个线程同时执行,代价是线程间同步与任务队列开销。收益成立的条件是:图里有足够多的无依赖分支,且每个分支足够长,抵消调度开销。
什么时候该用 PARALLEL
| 场景 | 建议 | 原因 |
|---|---|---|
| GPU 单模型推理 | SEQUENTIAL | 单 stream 并行收益低、同步开销高 |
| CPU 多分支大模型 | PARALLEL 试 | 分支并行可吃满多核 |
| 吞吐敏感批处理 | PARALLEL + inter>1 | 多请求或多分支叠加 |
| 延迟敏感单请求 | SEQUENTIAL | 最坏延迟可控 |
GPU 为主时 PARALLEL 收益有限的原因很直接:CUDA 算子都在同一个 stream 上排队,并行调度只是让 CPU 端的 launch 线程变多,GPU 端没有真的并行,反而多出同步与上下文切换。CPU EP 上一个大 MatMul 的分块由 intra-op 的 OpenMP 完成,与 execution_mode 无关——不要把 intra 并行误当成 mode 的效果。
配置代码
import onnxruntime as ort so = ort.SessionOptions() so.execution_mode = ort.ExecutionMode.ORT_PARALLEL # 或 ORT_SEQUENTIAL sess = ort.InferenceSession( "model.onnx", sess_options=so, providers=["CPUExecutionProvider"], ) # 用 Profile 确认模式生效与收益 so.enable_profiling = True for _ in range(20): sess.run(None, {"input": feed}) prof_file = sess.end_profiling() print(prof_file)
# 命令行快速对比两种模式的延迟分布 python bench_mode.py --mode sequential python bench_mode.py --mode parallel
对比时务必看 P99 而不是只看均值。PARALLEL 的均值可能因为多分支叠加而下降,但调度抖动会让 P99 恶化——这正是"延迟敏感选 SEQUENTIAL"的原因。
判断直觉与常见误区
💡 先量后调:Profile 里如果大部分时间落在单个大算子上(算子内瓶颈),改 mode 无用,改 intra_op 或 EP;只有 Profile 显示多个节点等待调度(算子间瓶颈)时,PARALLEL 才有意义。
⚠️ PARALLEL 模式下 inter_op_num_threads 别设 1——等于把并行能力关掉还付调度开销,是"开了 PARALLEL 反而更慢"的常见配置错误。线程数与 inter_op 的关系在 4.3 展开。
模式诊断脚本
判断当前图适不适合 PARALLEL,先量化"可并行度"——无依赖分支占总节点数的比例:
import onnx from collections import defaultdict def parallel_ratio(path): m = onnx.load(path) out_to_node = defaultdict(list) indeg = {} for n in m.graph.node: indeg[n.name] = len(n.input) for i in n.input: out_to_node[i].append(n.name) # 统计"只有单个消费节点"的边占比(边越密,并行空间越小) total, single = 0, 0 for k, v in out_to_node.items(): if not k: continue total += 1 if len(v) == 1: single += 1 return 1 - single / max(total, 1) print("并行潜力:", parallel_ratio("model.onnx"))
这只是粗筛:并行潜力高不代表 PARALLEL 一定赢,还要看每个分支的长度与 EP 类型。但潜力低于 0.2 的链状图可以直接放弃 PARALLEL,别浪费调参时间。判断链条:链状图 → SEQUENTIAL;多分支且 CPU → PARALLEL 试;GPU → 一律 SEQUENTIAL。
常见问题速查
| 症状 | 根因 | 处置 |
|---|---|---|
| PARALLEL 更慢 | 链状图无并行空间 | 回 SEQUENTIAL |
| PARALLEL 下 P99 飙 | 调度抖动 | 降 inter 或回 SEQUENTIAL |
| 换 GPU 后 mode 无效 | 单 stream 串行 | 保持 SEQUENTIAL |
| CPU 吞吐上不去 | 分支太短 | 改 intra 或融合 |
| 多模型并发吃 CPU | 每 Session 线程独立 | 规划全局线程预算 |
模式切换的工程实践
把 mode 选择从"拍脑袋"变成"可回滚的配置":策略文件里声明 execution_mode,CI 里同时跑两档并记录差异。这样换 mode 就像换参数一样可审计,出问题一条命令回滚。
# 策略式配置:mode 作为策略的一部分 import onnxruntime as ort def build_session(mode): so = ort.SessionOptions() so.execution_mode = mode so.intra_op_num_threads = 8 so.inter_op_num_threads = 1 return ort.InferenceSession("model.onnx", sess_options=so, providers=["CPUExecutionProvider"]) # 发布前对比 for mode in (ort.ExecutionMode.ORT_SEQUENTIAL, ort.ExecutionMode.ORT_PARALLEL): sess = build_session(mode) lat = benchmark(sess) # P50/P99 采集 print(mode, "P50=%.2f P99=%.2f" % lat)
落地准则:默认 SEQUENTIAL,PARALLEL 只作为 profile 验证后的显式选择。默认保守、优化激进、每个决策留测量记录——这条准则也适用于第4章其余所有参数。
与第6章的联调
mode 调优不是一次性的:模型升级、EP 更换、batch 变化都会改变图的并行潜力,上次的 PARALLEL 结论可能失效。做法是把 mode 与吞吐指标一起进 CI:每次模型变更自动重跑 P50/P99 矩阵,mode 或性能回归都会被门禁拦下。这比"上线前调一次然后忘记"可靠得多。
下一节:Arena 如何管内存。