2.1 寄存器模型与 ABI 约定
2.1 寄存器模型与 ABI 约定
本节摘要:三十二个通用寄存器是 RISC-V 非特权规范的工作台:每个寄存器有机器名 x0 到 x31 与 ABI 名两套称呼,按调用约定分成调用者保存与被调用者保存两组。本节拆解这套命名的分工逻辑,并用一个真实函数的汇编现场演示编译器如何遵守约定。
先把定义摆正
寄存器模型,指规范为软件规定的、处理器必须提供的可见存储单元及其语义。RISC-V 的非特权寄存器模型只有三句核心条款:提供三十二个通用寄存器 x0 到 x31(RV32 宽三十二位,RV64 宽六十四位);x0 恒为零,写入无效;另有一个不可作为操作数寻址的程序计数器 pc。加上 F 或 D 扩展后另有三十二个浮点寄存器 f0 到 f31,加上 Zicsr 后还有一排控制状态寄存器——后者属于第三章的地盘,本节不展开。条款短得可疑,但真正决定软件如何写的,是叠在这套模型之上的 ABI 约定。
两套名字,一本分工表
同一个物理寄存器在规范文档里叫 x1,在汇编代码里叫 ra,在编译器中间表示里可能叫返回地址暂存——三套称呼指的是同一个单元。ABI 命名不是装饰,它直接编码了分工规则,看懂这张表,读任何 RISC-V 汇编都不会迷路。
| 寄存器 | ABI 名 | 保存责任 | 典型用途 |
|---|---|---|---|
| x0 | zero | 无需保存 | 恒零源、丢弃写入 |
| x1 | ra | 调用者保存 | 函数返回地址 |
| x2 | sp | 被调用者保存 | 栈指针 |
| x3 | gp | 被调用者保存 | 全局数据指针,链接器松弛优化 |
| x4 | tp | 被调用者保存 | 线程局部存储指针 |
| x5 到 x7、x28 到 x31 | t0 到 t6 | 调用者保存 | 临时值,跨调用不作保 |
| x8、x9、x18 到 x27 | s0 到 s11 | 被调用者保存 | 跨调用存活的局部值,s0 兼帧指针 |
| x10 到 x17 | a0 到 a7 | 调用者保存 | 传参与返回值 |
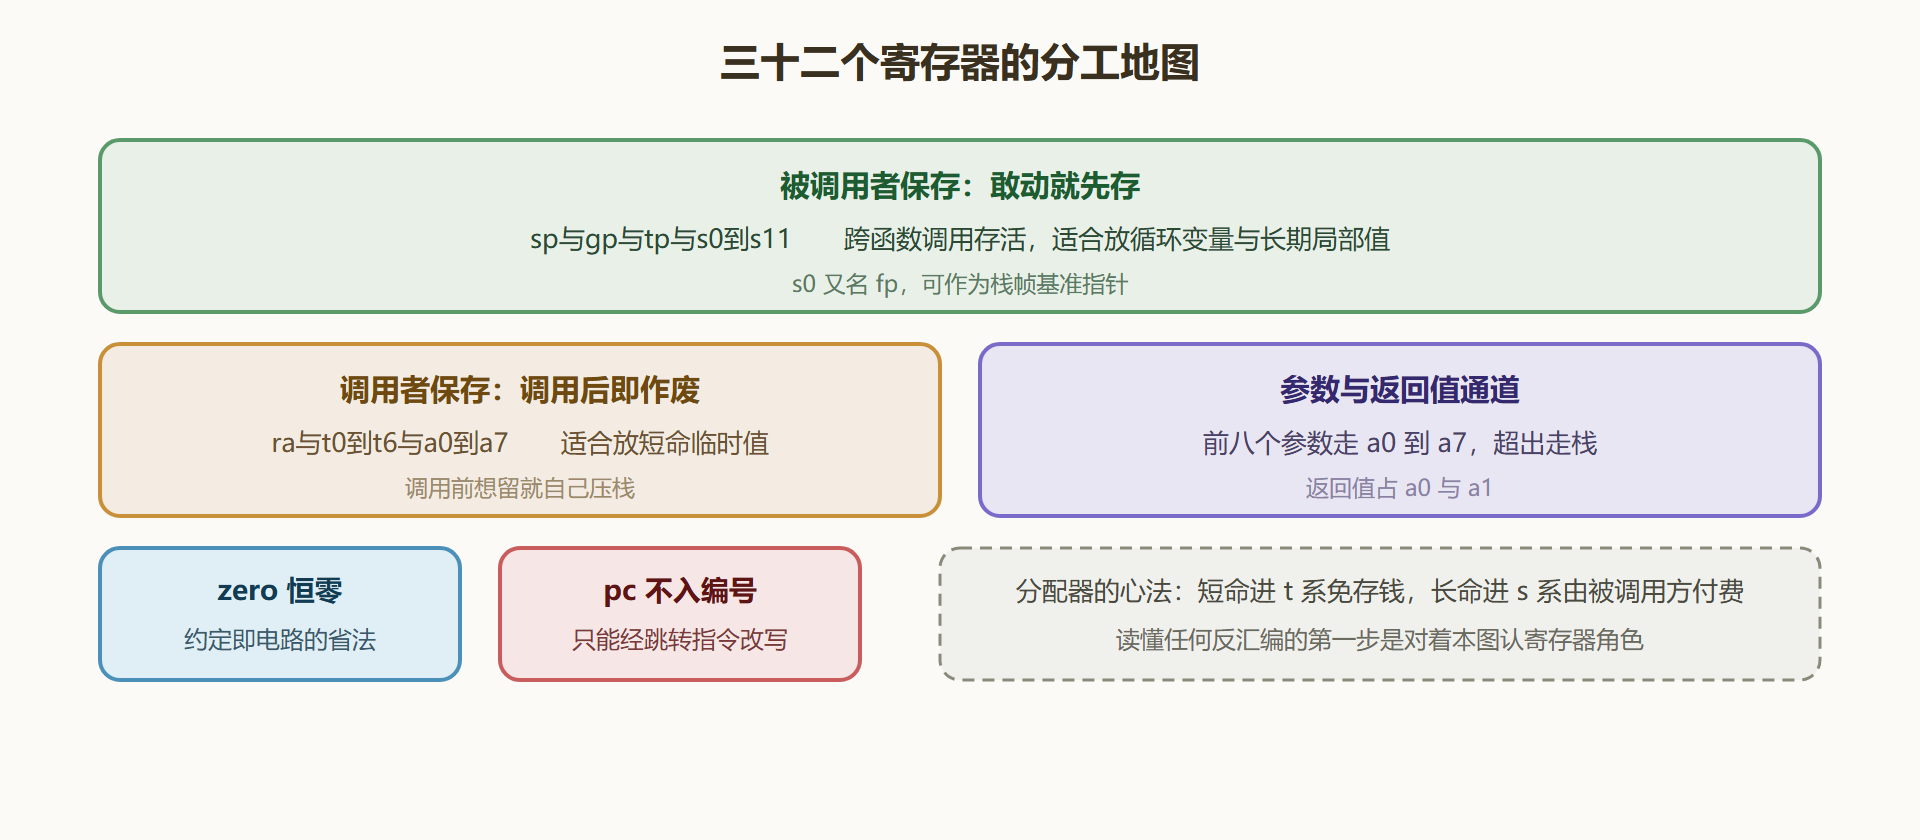
调用者保存(caller-saved)与被调用者保存(callee-saved)的分界线是全章最需要吃透的一条。t 系寄存器:发起函数调用后内容即作废,谁想留谁自己在调用前存栈。s 系寄存器:被调用方若要动用,必须先在函数开头把旧值压栈、返回前恢复。a 系寄存器则兼任传参通道——前八个参数依次走 a0 到 a7,超出的参数走栈;返回值放在 a0 与 a1。这套分工让编译器做寄存器分配时有稳定的预期:短命临时值放 t 系不必付保存代价,跨调用的循环变量放 s 系,代价由被调用方按需支付。
图 2-1 寄存器分组与保存责任
工程现场:一个函数的现场勘察
背景:下面这个 C 函数在循环里累加,随后调用外部函数上报,我们观察编译器如何分配寄存器。
int accumulate(int *buf, int n) { int sum = 0; for (int i = 0; i < n; i++) sum += buf[i]; return report(sum); /* 外部函数 */ }
操作:用交叉编译器以默认优化级别生成汇编,关键片段如下。
accumulate: li t0, 0 # sum 初值,先用 t 系 mv s1, a0 # buf 跨调用要活,挪进 s 系 mv s2, a1 # n 同理 beq s2, zero, done loop: lw t1, 0(s1) add t0, t0, t1 addi s1, s1, 4 addi s2, s2, -1 bnez s2, loop done: mv a0, t0 tail report # 尾调用,省去压栈
结果:真实的编译输出与此高度同构——循环变量与指针被搬进 s 系,因为它们必须在调用 report 之后仍然存活;累加器若全程不遇调用可以留在 t 系。本例恰好在调用前完成累加,编译器于是连 s 系的保存都省了:它发现 report 返回后不再使用 sum,直接尾调用跳转,返回值透传 a0。
解读:这段汇编是"寄存器即预算"的活教材。编译器做了三笔账:把跨调用的值移入被调用者保存组(付一次性搬移成本,免掉调用方反复压栈);把短命值留在 t 系(零保存成本);识别尾调用直接跳转(连 ra 的保存都省掉)。反过来,如果你在裸机汇编里手写函数,忘了保存你用到的 s 系寄存器,上层调用者的变量就会被无声踩掉——这类 bug 在调试器里表现为"某个变量莫名其妙变了",极难追查。
变式:把 report 的调用挪进循环体内,再看寄存器分配的变化——sum 将被迫迁入 s 系并触发保存序列;再把优化级别调到最低,观察每条语句如何退化成"读栈、算、写栈"的呆板序列。两个变式分别演示调用频率与优化级别对分配策略的撬动。
gp 与 tp:两个容易被略过的角色
最后补一刀细节。gp 与 tp 在应用代码里几乎从不直接出现,却是运行时环境的地基:gp 由启动代码初始化为全局数据区附近的固定地址,链接器随后把"远距离取全局变量"的指令对替换成"gp 加小偏移"的短编码,省下一条装载立即数的指令,这个优化叫链接器松弛;tp 则指向线程局部存储块,多线程运行时靠它定位每个线程的私有数据。它们都属于被调用者保存,且按惯例整个进程生命周期不变。在第三章的启动排错里你会看到,gp 与 tp 忘记初始化的故障形态非常典型——程序能跑到 main 附近,随后在第一次访问全局变量时行为错乱。
还有两个模型边界值得一并封存。其一是栈指针对齐的硬约束:ABI 规定 sp 在调用边界必须按十六字节对齐(RV32 上为八字节),编译器生成的压栈与出栈代码默认这个前提,手写汇编破坏对齐后,症状是浮点或成组访存指令间歇性异常,极难与数据错误区分。其二是 E 变体对模型的影响:寄存器砍半到十六个后,ABI 名与保存责任表整体重排,它与主流软件生态的二进制互不兼容——第二章选型问答里提过它的适用边界,此处补上的是模型层的因果:寄存器数量是 ABI 之根,根变了,地上所有约定跟着重写。
本节要点回顾
- 模型三句话:三十二个通用寄存器、x0 恒零、pc 独立于编号体系,其余复杂度都在扩展与约定层;
- 两套命名一套语义:ABI 名直接编码保存责任,读汇编先认角色再认数值;
- 保存责任的分界:t 系与 a 系调用后作废,s 系被调用方用前必存——这是手写汇编与读反汇编共同的安全带;
- 传参协议:前八个参数走 a0 到 a7,返回值走 a0 与 a1,超出部分走栈;
- gp 与 tp 是地基:前者撑起链接器松弛,后者撑起线程局部存储,启动时初始化失败会留下特征明显的现场。
寄存器这张工作台认完了,下一节把工具摆上来:四十七条 RV32I 指令逐类过一遍,六种编码格式逐位手解——包括那个用比特乱序省线路的立即数设计。