2.3 扩展模块选型问答:M、A、F、D、C、V 怎么拼
2.3 扩展模块选型问答:M、A、F、D、C、V 怎么拼
本节摘要:基线 RV32I 只是起点,真实芯片都以扩展字母组合面世。本节以问答形式拆解六大标准扩展各解决什么问题、硬件代价多大、拼错组合会踩什么坑,最后给出一套按应用域对号入座的选型矩阵,并附一次完整的选型复盘。
逐个回答:每个扩展是什么价码
问:M 扩展不就是乘除法吗,为什么值得单独一个字母?
答:因为乘除的语义细节比看上去多。M 提供八条指令:mul 与四个高位乘 mulh、mulhsu、mulhu(分别处理高乘高有符号、有符号乘无符号、全无符号的乘积高位),除法 div、divu 与取余 rem、remu。有符号除法向零取整,规范写死了被零除的结果——商为负一、余数即被除数——以及有符号溢出的结果,全部不触发异常。把异常语义从除法里拿掉,是给硬件减负的关键决策:除法器可以慢,可以多周期,甚至可以被流水线完全掩盖,不用留异常处理路径。代价是软件要自己检查除零——这不是疏忽,是明码标价的取舍。
问:A 扩展的原子操作,和锁有什么区别?
答:A 扩展给的是硬件级原语,分两路。一路是保留集方案:lr(load-reserved)取数时在硬件里登记一个监视地址,sc(store-conditional)写回时检查监视是否仍有效,有效则写入并把结果寄存器置零,无效则置一。两指令之间若无他人动过该地址,整个序列就是原子的;锁、无锁队列、引用计数都靠这对指令实现。另一路是单指令原子:amoadd、amoand、amo-or、amoswap 等,一条指令完成读旧值与写新值。陷阱在 lr 与 sc 之间的窗口:这一段代码若发生中断、异常或上下文切换,sc 必然失败——所以规范允许实现者在陷入时直接清掉保留集,软件要按"失败就重试"的循环来写,不能假设一次成功。
问:F 与 D 只是快慢问题吗,不拼浮点扩展程序就不能跑吗?
答:不拼也能跑,但有两个坑。第一是速度:编译器把浮点运算展开成软件库调用,一条浮点乘法退化成几十条整数指令。第二更隐蔽——ABI 会变。指定 F 后,浮点参数按约定走 f 寄存器传递(abi 名从 ilp32 变成 ilp32f),不拼 F 则浮点参数塞进整数寄存器组。同一台机器上,abi 拼错的二进制会以诡异的方式传错参数,这类故障在链接预编译库时高发。所以选 F 或 D 从来不只是性能决策,还是整个二进制生态的兼容性决策:你的库、你的中间件、你的系统调用接口,都得用同一个 abi 拼法。
问:C 压缩扩展的收益有多大,有什么代价?
答:收益是代码密度:把寄存器编号、立即数范围都裁短的常用指令压成十六位,典型固件体积缩两到三成,直接省闪存和指令缓存占用。代价几乎可以忽略——C 不改变架构语义,只是给高频指令做了一套短编码别名,取指硬件需要处理两字节对齐的混合流,译码逻辑多一点,但换来的是嵌入式场景里几乎是必拼的一个字母。这也是为什么现实中极少见到不带 C 的芯片。
问:B 与 V 呢?
答:B 是位操作扩展家族(现拆成 Zbb、Zbs 等次级字母),提供前导零计数、字节序反转、位域抽取插入这类指令,对协议解析、压缩算法、哈希计算是实打实的加速,密码学与网络设备常拼。V 是向量扩展,引入独立的向量寄存器组与可变长向量模型,单条指令处理成组数据,面向信号处理、机器学习推理——它体量大到值得单独一章,第五章专讲。此外还有 Zicsr(读写控制状态寄存器)、Zifencei(指令流同步)两个次级扩展,如今已从基线中拆出,工具链的 march 字符串里经常要显式点名。
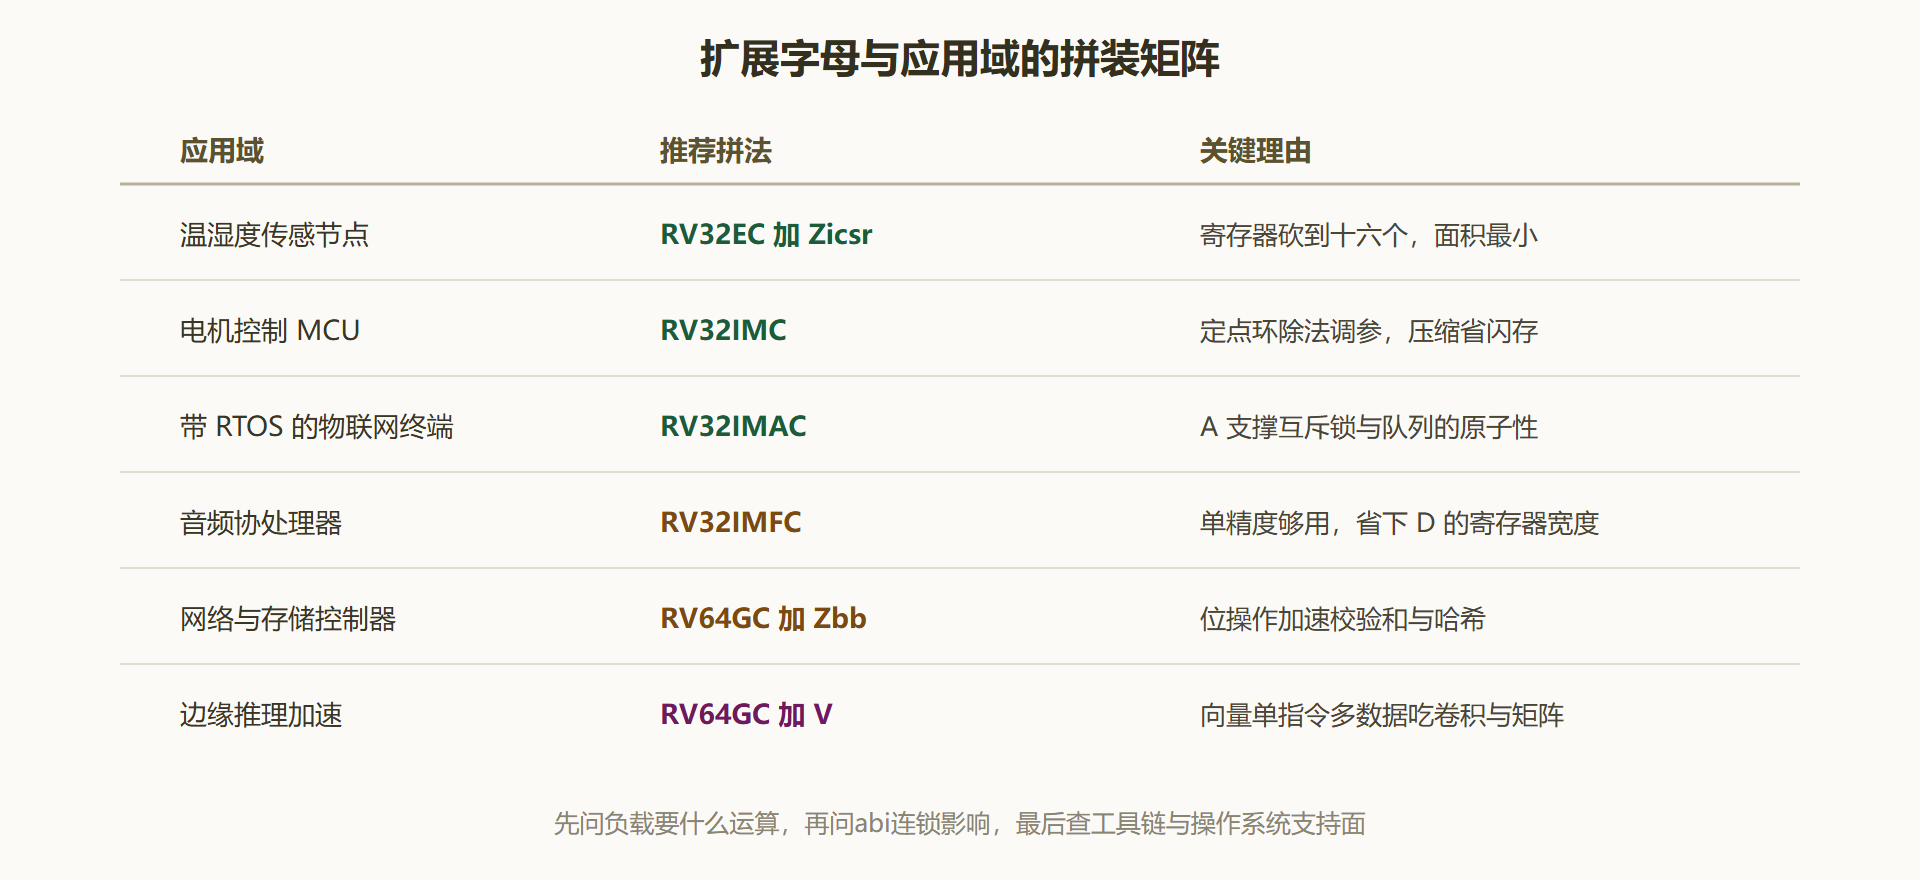
图 2-2 扩展拼装选型矩阵
容易踩的三个组合坑
选型矩阵之外,有三个高频坑要单独点名。第一个是 abi 与库不匹配:march 拼了 F 却用 ilp32 的 abi 链接,浮点参数在整数寄存器里被误解,症状是数学计算结果诡异而非崩溃,极难第一时间联想到 abi。第二个是 E 扩展的隐蔽约束:E 把通用寄存器砍到十六个,编码上 rs 字段缩短,它与标准软件生态(尤其操作系统内核与动态链接库)基本不兼容,只适合深度定制的微控制器场景,拿来跑 Linux 是走不通的。第三个是 march 字符串里忘了 Zicsr:裸机固件要读写控制状态寄存器,若 march 只写 rv32i,编译器会把 csr 指令当非法指令拒绝——这是新手上路的第一块绊脚石,报错信息还常常不直说。
工程现场:一次电机驱动芯片的选型复盘
背景:团队为步进电机驱动设计配套 MCU,负载为电流环控制,含定点除法(速度环参数归一化)、周期性中断、约六十 KB 固件,闪存预算上限六十四 KB。
操作:候选拼法三个。RV32I:乘除全部走软件库,电流环关键路径里的除法退化为数十条指令,实测环周期超标约两倍,出局。RV32IMAC:M 解决除法,A 支撑 RTOS 的互斥原语,C 压固件体积,实测环周期留有两成裕量,固件四十七 KB。RV32IMFC:浮点环控制实现更直观,但 D 级双精度无需求,单精度 F 换来的是代码可读性而非性能必需,且 abi 从 ilp32 切到 ilp32f,现成定点中间件库要重新交叉编译验证。
结果:选 RV32IMAC,浮点换算在算法层用 Q15 定点表示解决。流片后量产,固件后续三年三次功能升级均未触及闪存上限。
解读:这次选型的有效动作有两个:一是用实测环周期而非纸面参数做裁决——扩展拼法的影响必须落在自己的关键路径上才算数;二是把 abi 连锁反应纳入评估,F 不是免费的字母,它牵动整个二进制生态。
变式:若负载换成音频采样处理,Q15 定点路线的开发成本会超过拼 F 的代价,结论反转;若产品要跑 Linux,则基线要求直接跳到 RV64GC 加上一整套系统级扩展,那是第三章之后的世界。选型没有万能答案,只有与负载、预算、软件栈三者的合议。
本节要点回顾
- M 的明码标价:除零与溢出不触发异常,商负一余被除数,硬件省了异常路径,软件补检查;
- A 的正确用法:lr 与 sc 成对出现,失败重试循环是标准写法,窗口内陷入即失效;
- F 或 D 是生态决策:abi 随之而变,库与中间件必须同一拼法,不只是快慢问题;
- C 几乎必拼:两三成固件体积收益,代价可忽略;E 则只属于深度定制的微型场景;
- march 字符串要完整:Zicsr 与 Zifencei 常需显式点名,漏写会在裸机开发第一天就撞墙。
到这里,非特权契约已经读完:寄存器怎么分、指令怎么编、扩展怎么拼。但 sum 加 delta 的程序要真正跑起来,还需要有人发号施令管中断、管内存——下一章翻开规范的另一半:特权架构。