6.1 五级流水线与冒险处理
6.1 五级流水线与冒险处理
本节摘要:流水线让五条指令像装配线上的工件一样重叠推进,把每周期指令数从零点二推向接近一;但重叠立刻制造三类冲突——数据冒险、控制冒险、结构冒险。本节用一张时空图把冲突定位到具体周期,再逐一给出前递、停顿、预测的标准解法,并解释加载使用冒险为何天生要付一个周期的税。
把指令拆成工件
第一章末节留下的那张五级通路图,本章开始真正"转起来"。单周期核里每条指令独占完整通路,时钟周期被最慢的指令(访存类)拖住;五级流水线把通路切成五段,各段之间加寄存器锁存,理想情况下每周期都有一条指令完成——时钟频率取决于最慢的一级而非最慢的指令,吞吐率翻了近五倍。代价是控制复杂度:指令之间不再有时间上的隔离,前一条的结果还没落地,后一条已经伸手来拿。
先给"冒险"分好类,后面所有讨论都挂在三个名字下。数据冒险:指令之间有数据依赖,依赖的结果尚未写回。控制冒险:分支方向未定,流水线前端不知道下一拍取哪。结构冒险:两条指令争用同一个硬件部件。顺序单发射流水线里,写后读是唯一的数据冒险形态——读后写与写写冲突只在乱序引擎里才会出现,这是六点二节的伏笔。
时空图推演:冲突藏在第几拍
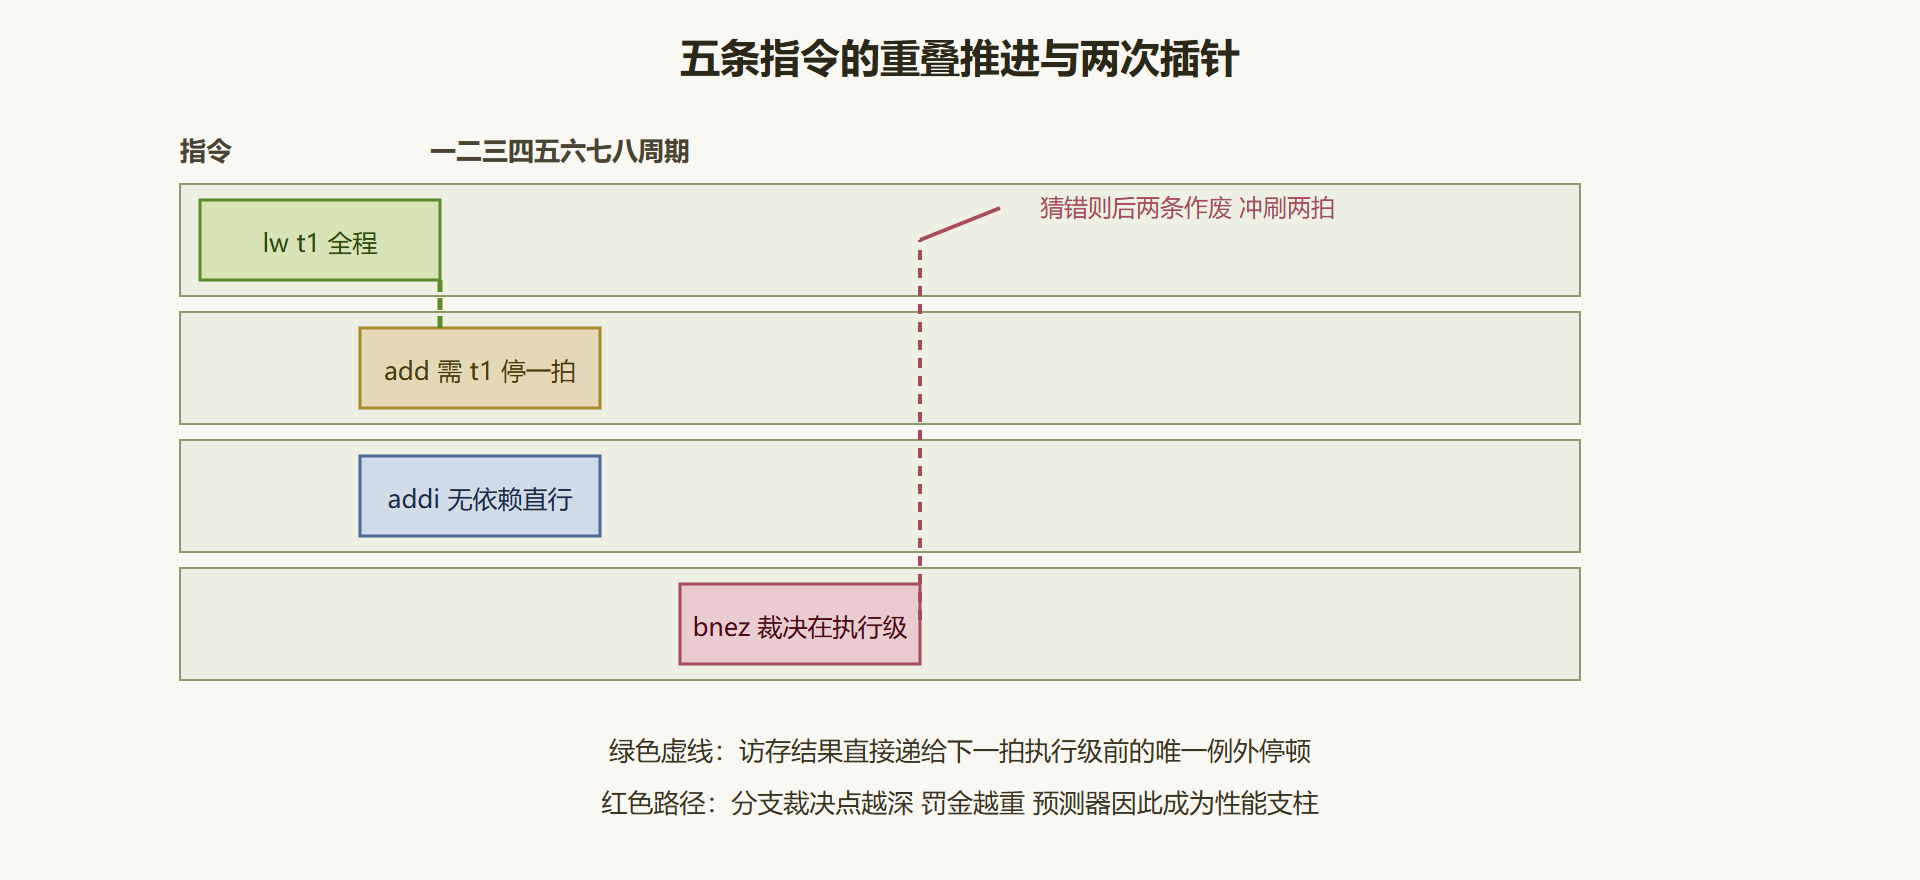
纸上推演四条指令的五级推进,冒险的时序位置一目了然。代码与时空图如下(横轴周期、纵轴指令,F 取指、D 译码、E 执行、M 访存、W 写回)。
周期 1 2 3 4 5 6 7 8 lw t1 F D E M W add t0 F D E* M W E* 依赖 t1 t1 在 M 级才产生 addi a0 F D E M W bnez a1 F D E M W
结果:第二条指令在第四拍进入执行级,而它需要的 t1 要到第五拍(前一条的访存级末尾)才真正可用——差一拍,前递线路也无法凭空变出数据。更常见的情形是隔一条指令的依赖: producers 在第三拍执行级产出的值,消费者第五拍才进执行级,中间隔着的访存写回两级各设一条"旁路",把结果提前递给执行级的入口,一拍不丢。这就是前递(转发旁路)的全部:从访存级与写回级的锁存器直接拉线到执行级输入,让"已在芯片里"的结果不必绕道寄存器堆。
真正塞不进前递网格的只有一种:加载与使用紧邻。数据要到访存级才存在,而使用者在下一拍的执行级——物理上不可能。唯一解法是硬件识别这个模式(译码时比对新加载的目的寄存器与下一条的源寄存器),自动插一个周期的停顿,让时序错开一拍后再前递。这一个周期是架构缴的"物理税",编译器的指令调度(把无关指令挪进加载的阴影里)就是在帮硬件逃税。
控制冒险的账要算到分支身上。若分支在执行级才裁决,其后两条已按旧方向取进的指令要作废,一次猜错白扔两拍;裁决级越深,罚金越高。RISC-V 从设计上砍掉了 MIPS、SPARC 那一代的分支延迟槽——不要求编译器填充跟在分支后的指令,把所有预测负担交给硬件:最简单的静态"预测不跳",到动态两位饱和计数器,再到分支目标缓冲,预测器越贵,猜错率越低。六级以下的小核常用静态预测凑合,高性能核的预测器精度能到百分之九十九以上——这直接决定了深流水线的实际收益。
把分支预测的成本与收益算细一点,有助于理解它为何成为现代核的军备竞赛。两位饱和计数器的原理朴素到可以在纸上模拟:每个分支配一个两比特计数器,跳了加一、不跳减一,计数器处于高位就预测跳、低位就预测不跳——它让"偶发反转"不至于立即翻转预测,只有连续反向才改判。分支目标缓冲再进一步:把历史分支的目标地址缓存起来,取指阶段直接查表改写取指流,连"先取错再作废"的动作都省掉。代价随之而来:计数器与缓冲的存储占用随流水线深度与预测精度需求指数膨胀,深流水线大核的预测器能占去可观的核心面积——第六点二节讲乱序窗口时说的"性能是买来的",预测器就是最典型的一笔。
结构冒险在小核上最常见的形态是存储端口:取指与数据访问抢同一个存储器端口。解法是哈佛化——指令缓存与数据缓存分家,各用各的端口。另一形态是多周期部件:乘法器占执行级三拍,后继指令必须停等,靠给部件加流水级或复制部件缓解。两类解法都花钱,小核通常选择"认了"——结构冒险停顿的实现最便宜。顺带一提,压缩扩展会让取指级的结构管理多一层复杂度:十六位与三十二位指令混排时,取指缓冲要按对齐边界裁剪指令流,判断失误会把半条指令送进译码级——这类问题在引入压缩特性的流水线改造中是高频缺陷,联测时要专门构造跨边界混排的用例。
图 6-1 时空图与前递停顿示意
工程现场:一次循环的每周期账本
背景:评估一颗五级核跑第二章那条求和循环的真实吞吐,判断"接近每周期一条"的说法成不成立。
操作:循环体五条指令,依赖关系两点:lw 与紧邻的 add 构成加载使用冒险(硬件停一拍);bnez 每轮裁决一次,采用静态预测不跳策略,最后一轮猜错罚两拍。按十轮循环推演:理想五拍一轮,加载停顿每轮加一拍,合计每轮六拍;十轮共六十拍加末轮冲刷两拍。
结果:每周期指令数约零点三二。结论与"接近一"相去甚远——五个循环指令里一个加载紧依赖加一个高频率分支,就把理论收益吞掉三分之二。
解读:这笔账的用途不在数字本身,而在揭示流水线收益的三个杠杆:依赖链长度(把加载与使用拆开,插无关指令)、分支密度与可预测性(循环展开降低分支频率)、以及一级缓存命中(停顿与冲刷的罚金都假设了快路径)。同一份代码换种写法(展开两轮、调度加载位置),零点三二就能爬到零点五以上——微架构能力要靠代码形态兑现,这是第七章编译器优化的伏笔。
变式:把分支预测从静态改为带两位计数器的动态预测,重跑循环型负载,观察冲刷罚金几乎消失;再故意把数组访问步长设为跨缓存行,看访存停顿如何取代分支成为新瓶颈——两个变式分别验证预测器收益与存储墙的接管。
本节要点回顾
- 流水线换吞吐不换语义:五级重叠让频率取决于最慢一级,架构状态依旧按序生效;
- 数据冒险靠前递兜底:旁路线路把执行级、访存级、写回级的结果直接递进执行级入口;
- 加载使用是物理税:数据在访存级才存在,硬件自动停一拍,编译调度负责逃税;
- 控制冒险是预测账:裁决点越深罚金越高,RISC-V 无延迟槽,预测精度是深流水线的生命线;
- 结构冒险认便宜解:缓存分家解决端口争用,多周期部件小核选择停等。
顺序流水线的天花板已经现形:等待无处可藏。下一节把"等"从关键路径上摘掉——乱序执行与高性能微架构的三大件登场。